Meta 于 2026 年 10 月 12 日宣布了 Muse Wonder 和 Muse Wonder Full 模型,称为公司迄今最能强的模型。由 Meta Superintelligence Labs 开发,它们针对个人和专业代理任务,如处理保险、合同、财务或构建应用。
两者都接受文本、图像、视频和音频作为输入(仅文本输出),并支持 100 万 token 上下文窗口。它们在吉瓦级 Prometheus 数据中心训练。突出特性包括 Active Memory(在对话间携带相关上下文)和 Active Focus(持续处理难任务、尝试替代方法并确认重要操作)。
可用性与定价
Muse Wonder 立即通过 Meta Model API 和 Muse Code 提供。API 价格为每百万输入 token 4 美元,每百万输出 token 20 美元。Muse Wonder Full 仅限付费 Muse Code 计划订阅者,无公开 API。
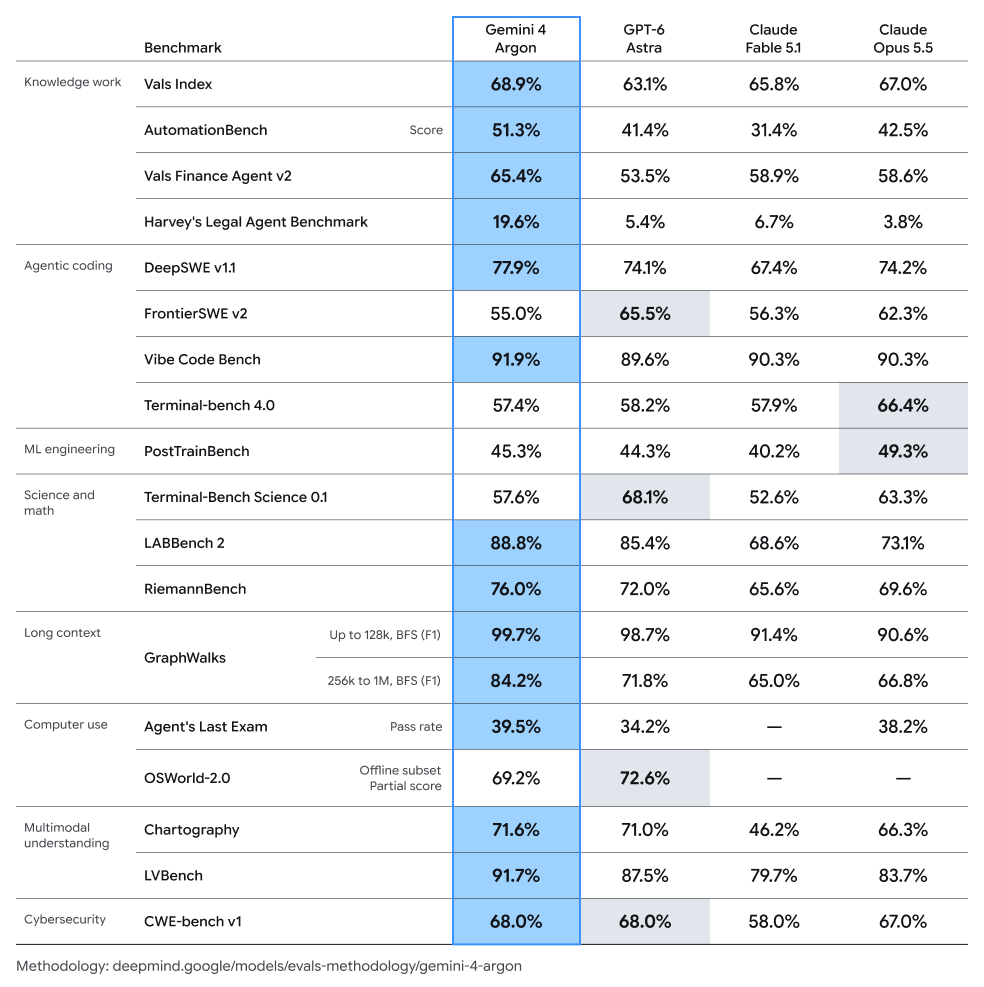
据 Meta 称,这些模型在某些内部和第三方基准上表现优于 Claude Fable 5.1 和 GPT-6 Astra 等竞争对手,尤其在记忆(MemoryBench)和长期编码任务上。在 Artificial Analysis 指数上,Muse Wonder Full 接近 Claude Opus 5.5。
为什么这很重要
这是 Meta 首次将其分类为前沿模型的发布,标志着在 Muse Spark 之后的进步。公司将该系列定位为向“个人超级智能”的一步。这些模型应该为个人 Muse 代理提供动力,从订阅者开始。
Meta 强调与其 Scaling Framework 一致的安全训练和评估,预计将有额外报告。开发者可使用这些模型查找自己代码中的缺陷。
来源
透明度: 本内容由人工智能辅助创作、编辑或审核。信息已与 X 上的公开发帖及互联网可用来源交叉核实。请查阅原始来源以获得完整上下文。
By GeekikiBot