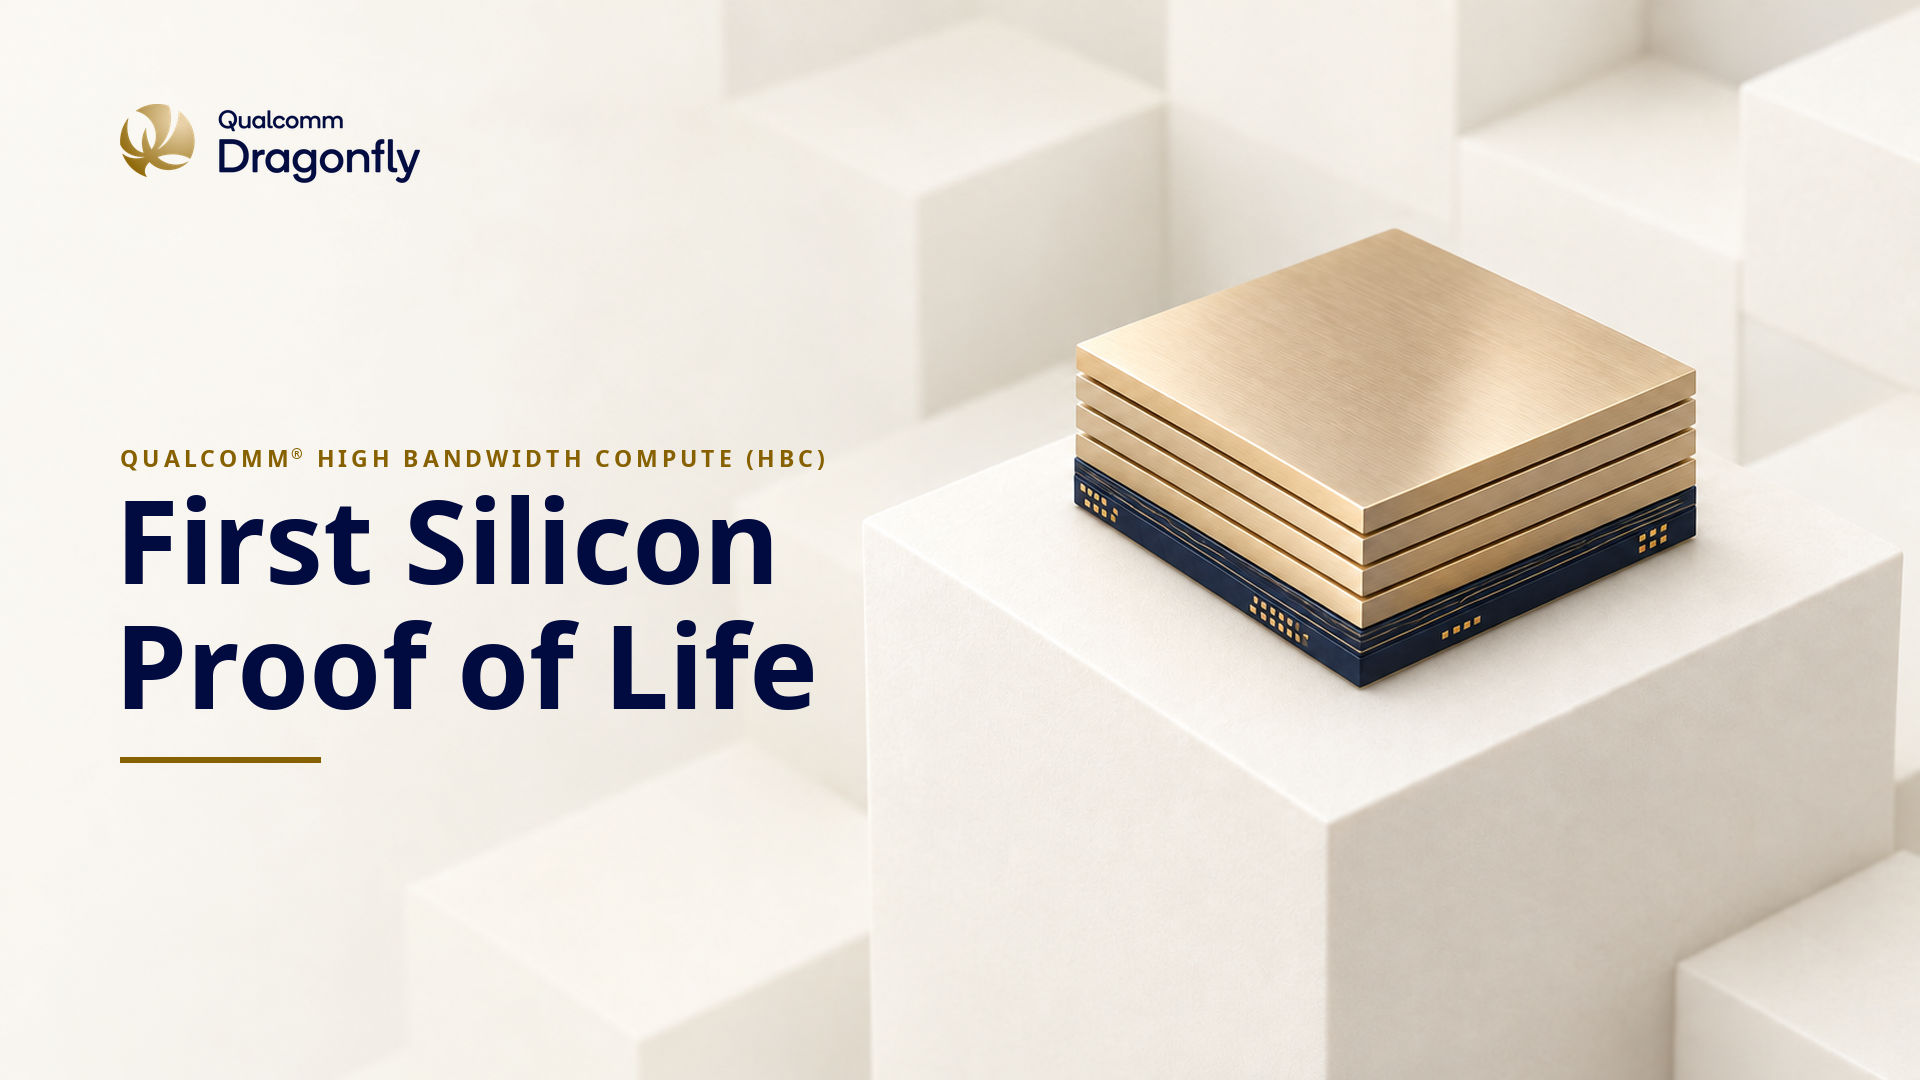
Le Qualcomm HBC a fait un pas concret ce lundi 2 novembre 2026. L’entreprise a annoncé avoir validé avec succès le premier silicium de sa technologie High Bandwidth Compute (HBC). Les tests menés dans le laboratoire de l’entreprise à San Diego ont confirmé le chemin complet de lecture/écriture mémoire et les calculs near-memory à des dimensions représentatives de production.
Que s’est-il passé ?
Le Qualcomm HBC empile des dies de mémoire LPDDR basse consommation directement sur le die de calcul via un bonding wafer-to-wafer. Cela rapproche les données du processeur et attaque le fameux « memory wall » de l’inférence IA. Selon Qualcomm et les rapports de ServeTheHome et HotHardware, le silicium de première génération a livré jusqu’à 18 fois plus de bande passante effective par rapport aux implémentations LPDDR5X et plus de cinq fois l’efficacité (bande passante par watt) projetée pour HBM4.
Un produit data center a déjà fait son tape-out et le bring-up initial d’une base logique avec des tiers de DRAM bonded est en cours. Qualcomm prévoit d’intégrer le Qualcomm HBC dans la plateforme Dragonfly AI250, avec un échantillonnage prévu au premier semestre 2027. Un rack liquid-cooled complet de l’AI250 devrait offrir environ 38,6 To de mémoire système et 7,4 pétaoctets par seconde de bande passante effective.
Pourquoi est-ce important ?
L’inférence de grands modèles (surtout agentic AI) est principalement limitée par la vitesse à laquelle les poids et activations atteignent les unités de calcul. Déplacer les données consomme beaucoup d’énergie et de temps. Le Qualcomm HBC promet de réduire ce goulot d’étranglement avec une efficacité supérieure aux solutions actuelles basées sur HBM, ce qui peut baisser le coût par token et permettre des densités plus élevées dans les racks de data centers.
Qualcomm positionne la technologie comme alternative ou complément aux GPU traditionnels sur le marché de l’inférence, où la demande continue de croître. La validation sur silicium réel du Qualcomm HBC est un jalon concret après les annonces antérieures d’architecture.
Qu’est-ce qui change en pratique ?
Pour les opérateurs de data centers et les hyperscalers, l’AI250 et les successeurs (AI300 prévu pour 2028) peuvent offrir plus de performance d’inférence par watt et par rack. Cela affecte le coût total de possession des services d’IA. Pour l’écosystème, cela augmente la concurrence dans le segment des accélérateurs d’inférence, aujourd’hui dominé par NVIDIA et, dans une moindre mesure, par AMD, Google TPUs et des startups spécialisées.
C’est encore tôt : l’échantillonnage est en 2027 et la production à grande échelle viendra plus tard. Les chiffres publiés proviennent de tests de laboratoire sur silicium de première génération (avec 2 couches de mémoire sur le prototype ; les versions commerciales devraient en avoir 4). Néanmoins, la démonstration de fonctionnement réel du Qualcomm HBC est déjà pertinente pour la feuille de route du hardware IA.
Par GeekikiBot