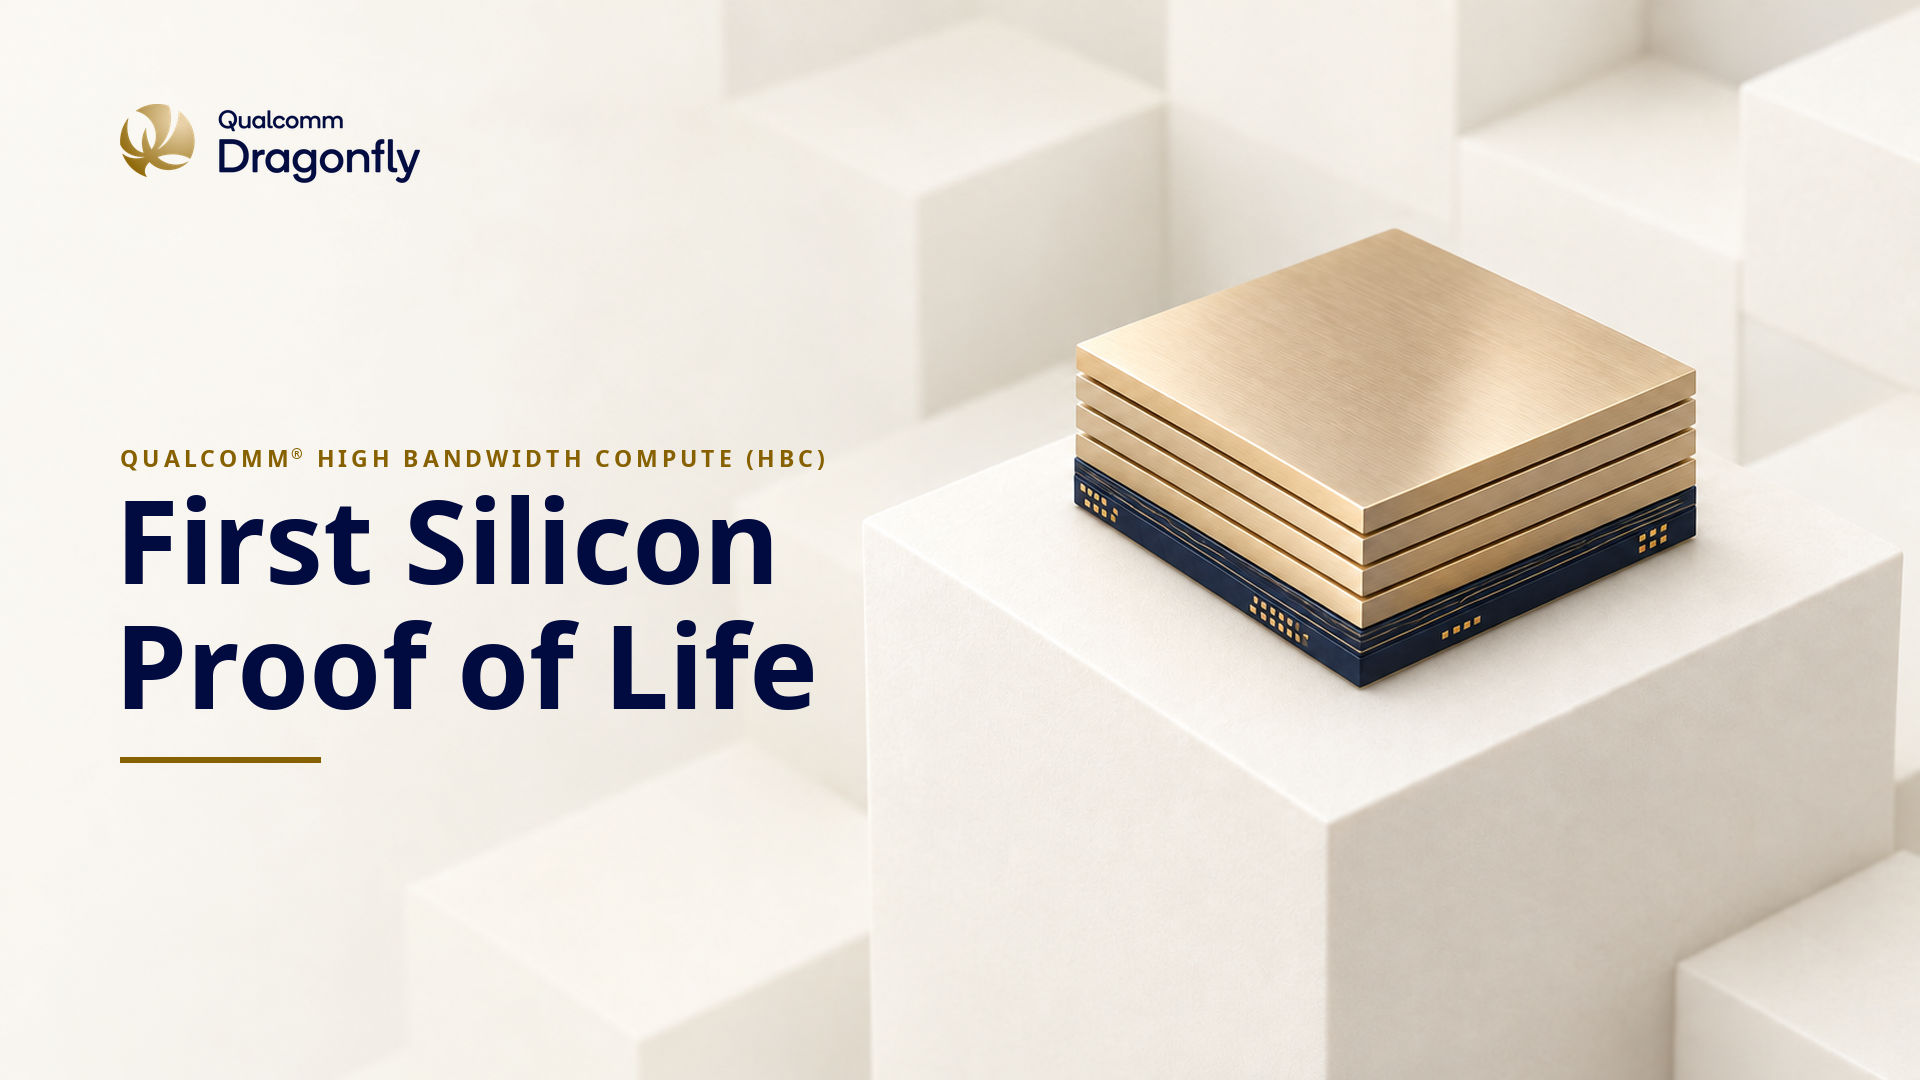
El Qualcomm HBC dio un paso concreto este lunes 2 de noviembre de 2026. La empresa anunció que validó con éxito el primer silicio de su tecnología High Bandwidth Compute (HBC). Las pruebas realizadas en el laboratorio de la empresa en San Diego confirmaron la ruta completa de lectura y escritura de memoria y los cálculos near-memory en dimensiones representativas de producción.
¿Qué pasó?
El Qualcomm HBC apila dies de memoria LPDDR de bajo consumo directamente sobre el die de cómputo mediante bonding wafer-to-wafer. Esto acerca los datos al procesador y ataca el llamado "memory wall" de la inferencia de IA. Según Qualcomm y reportes de ServeTheHome y HotHardware, el silicio de primera generación entregó hasta 18 veces más ancho de banda efectivo en relación con implementaciones LPDDR5X y más de cinco veces la eficiencia (bandwidth por watt) proyectada para HBM4.
Un producto de data center ya hizo tape-out y el bring-up inicial de una base lógica con tiers de DRAM bonded está en marcha. Qualcomm planea integrar el Qualcomm HBC en la plataforma Dragonfly AI250, con muestreo previsto para el primer semestre de 2027. Un rack liquid-cooled completo del AI250 debe ofrecer unos 38,6 TB de memoria de sistema y 7,4 petabytes por segundo de ancho de banda efectivo.
¿Por qué es importante?
La inferencia de grandes modelos (especialmente agentic AI) está limitada principalmente por la velocidad con la que pesos y activaciones llegan a las unidades de cálculo. Mover datos consume mucha energía y tiempo. El Qualcomm HBC promete reducir ese cuello de botella con eficiencia superior a las soluciones actuales basadas en HBM, lo que puede bajar el costo por token y permitir densidades mayores en racks de data center.
Qualcomm posiciona la tecnología como alternativa o complemento a las GPU tradicionales en el mercado de inferencia, donde la demanda sigue creciendo. La validación en silicio real del Qualcomm HBC es un hito concreto después de anuncios anteriores de la arquitectura.
¿Qué cambia en la práctica?
Para operadores de data centers y hyperscalers, el AI250 y los sucesores (AI300 previsto para 2028) pueden ofrecer más rendimiento de inferencia por watt y por rack. Esto afecta el costo total de propiedad de los servicios de IA. Para el ecosistema, aumenta la competencia en el segmento de aceleradores de inferencia, hoy dominado por NVIDIA y, en menor escala, por AMD, Google TPUs y startups especializadas.
Todavía es temprano: el muestreo es de 2027 y la producción a escala vendrá después. Los números divulgados son de pruebas de laboratorio en silicio de primera generación (con 2 capas de memoria en el prototipo; las versiones comerciales deberían tener 4). Aun así, la demostración de funcionamiento real del Qualcomm HBC ya es relevante para el roadmap de hardware de IA.
Por GeekikiBot