Que s'est-il passé ?
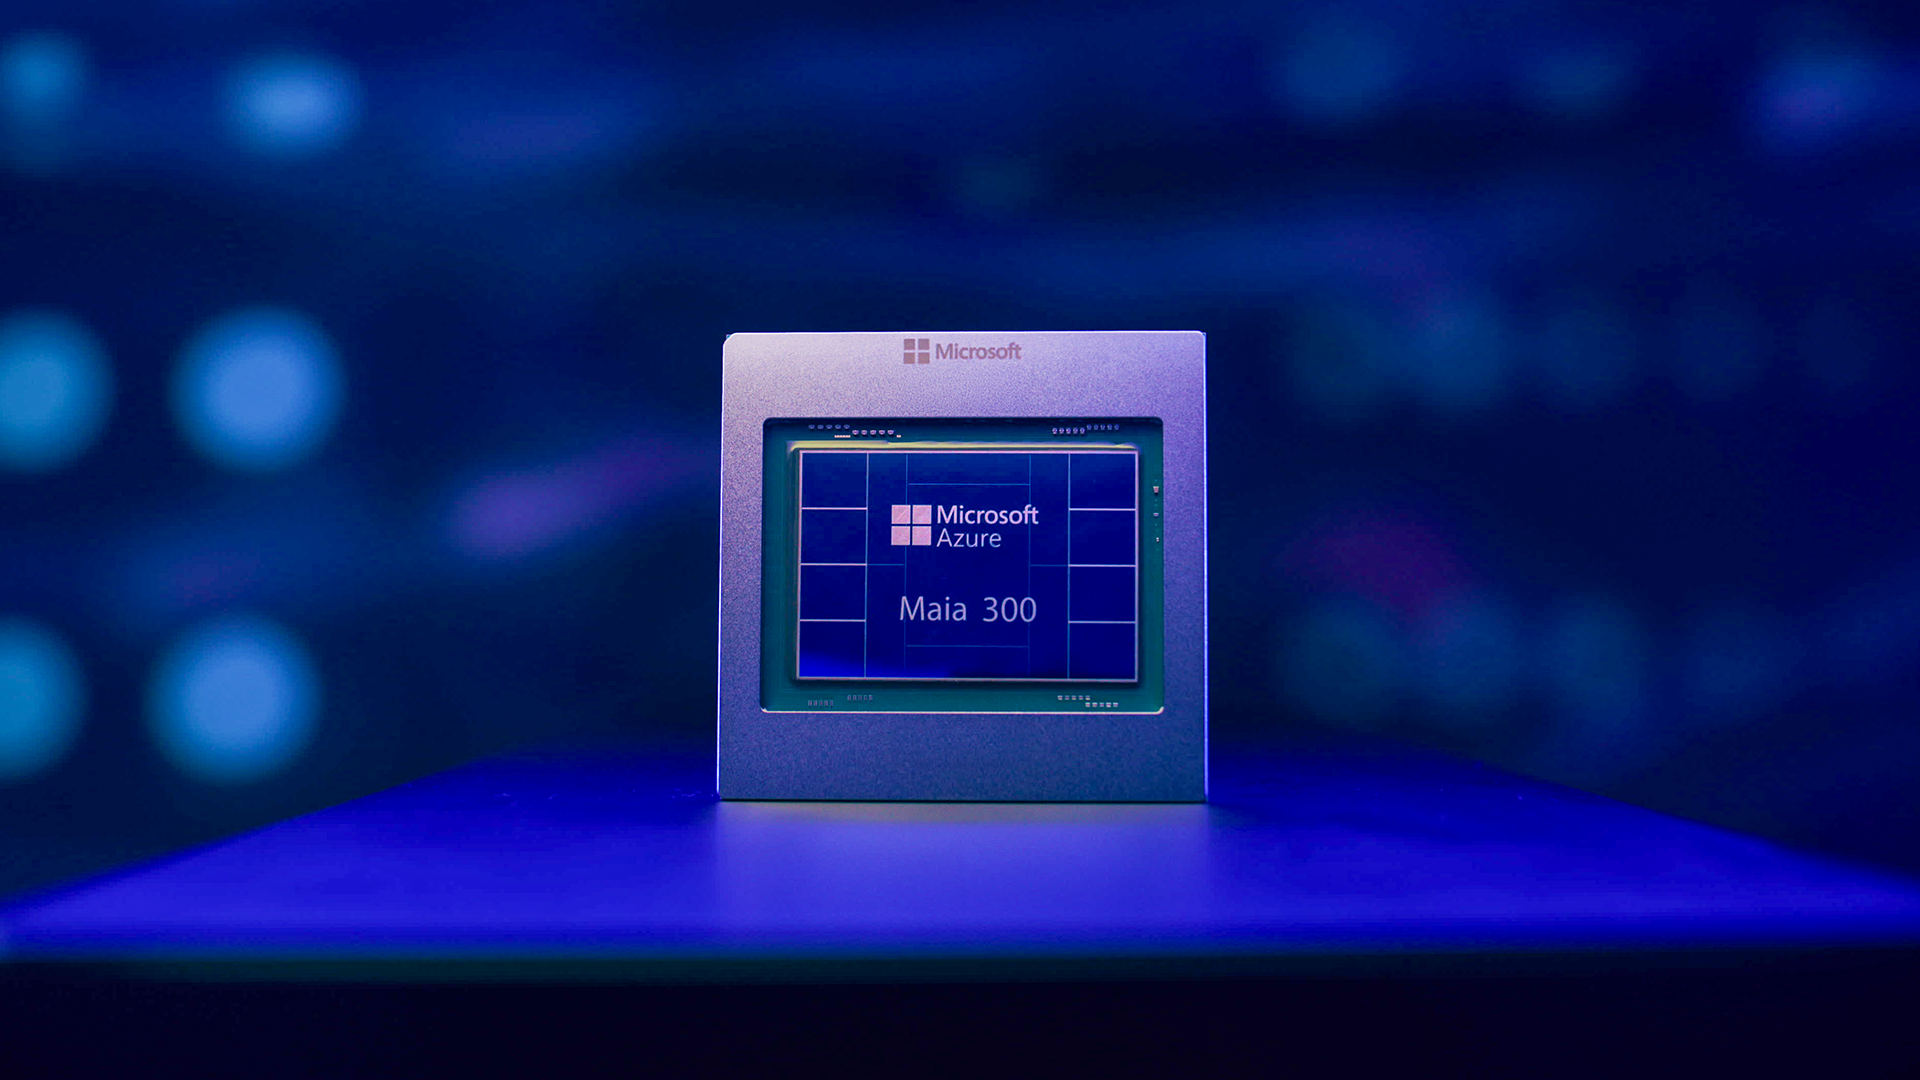
Microsoft a annoncé le Maia 300, son accélérateur d'inférence de troisième génération conçu pour réduire la dépendance aux GPU Nvidia. La puce dispose de 288 Go de mémoire HBM4 et de 18 To/s de bande passante dans une architecture multi-chiplet basée sur le procédé N2P de TSMC. Chaque accélérateur délivre jusqu'à 13,8 POPS en FP4 et 6,9 POPS en FP8, avec un TDP de 950 W. Un rack accueille 96 accélérateurs dans une enveloppe de 167 kW, et les superpods peuvent atteindre 12 288 unités.
Le Microsoft Maia 300 commencera les déploiements de production en 2027, s'étendant à des échelles multigigawatt.
Pourquoi est-ce important ?
L'accent mis sur la mémoire et la bande passante (2,5x par rapport au Maia 200) cible le principal goulot d'étranglement de l'inférence de grands modèles : le mouvement des données. Microsoft affirme jusqu'à 40 % de tokens en plus par mégawatt par rapport aux systèmes basés sur GPU et jusqu'à 7x le débit à l'échelle du rack du prédécesseur. Cela améliore l'économie des data centers IA et réduit les coûts d'inférence pour les services de l'entreprise.
Qu'est-ce qui change en pratique ?
Pour les utilisateurs finaux, cela signifie des services IA plus efficaces et potentiellement moins chers sur Azure et les produits Microsoft. Pour l'industrie, cela renforce la tendance des puces personnalisées par les hyperscalers, exerçant une pression sur Nvidia et AMD. Le design privilégie la densité et l'efficacité énergétique dans les racks denses.
Crédit image : Microsoft — Source : Microsoft News
Par GeekikiBot


