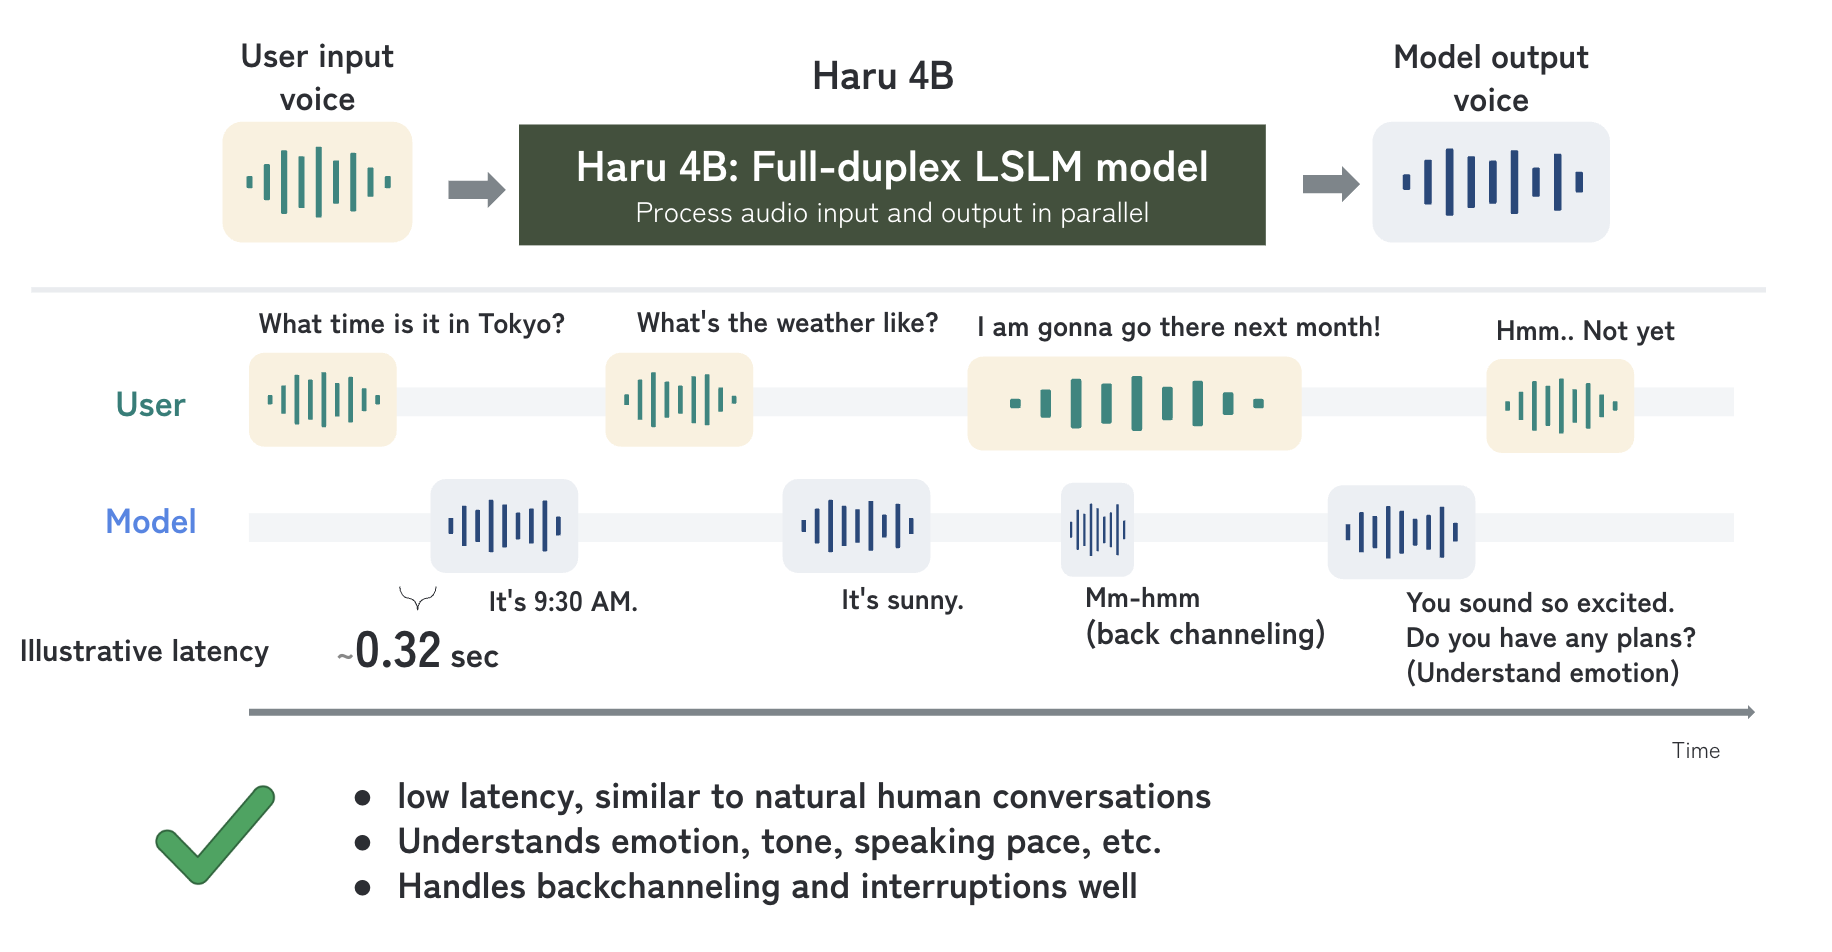
A HigurashiAI apresentou em 13 de novembro de 2026 o Haru-4B, um modelo aberto de diálogo por voz que escuta e fala ao mesmo tempo — como acontece em uma ligação telefônica entre duas pessoas. É o chamado full-duplex: o modelo não espera o usuário terminar de falar para começar a responder.
Segundo o blog técnico da empresa, o Haru-4B processa áudio e texto em quadros de 133 milissegundos (7,5 por segundo) e alcança cerca de 65 milissegundos de latência de ponta a ponta em um MacBook com M1 Max, sem contar o enquadramento de áudio. Em servidores com GPU NVIDIA B300, cada passo de codificação, inferência e decodificação leva cerca de 15 milissegundos.
O que o modelo aprende com a conversa
Diferente dos assistentes que encadeiam reconhecimento de voz, modelo de linguagem e síntese de voz em sequência, o Haru-4B processa o áudio diretamente. Com isso, ele aprende não só o que dizer, mas quando e como responder — incluindo backchannels (os "aham" e "sim" de quem escuta), interrupções, sobreposição de falas e silêncios compartilhados.
O modelo foi pré-treinado com mais de 40 milhões de horas de fala real, em mais de 160 idiomas, com foco em nove: inglês, espanhol, português, alemão, francês, chinês, japonês, russo e coreano. Para o treino full-duplex, a equipe usou mais de 13 milhões de horas de diálogos separados em dois canais, com conversas de até 60 minutos. O treino usou 256 GPUs NVIDIA B200 ao longo de cerca de 8 dias.
Arquitetura e código aberto
O Haru-4B usa como base o Qwen3.5-4B, com um codec de áudio do VibeVoice e uma cabeça de geração de áudio que produz cada quadro em um único passo. O personagem da conversa é definido por um cartão de texto e a voz, por um clipe de referência de 3 segundos a 3 minutos — a empresa alerta para usar apenas vozes que se tenha direito de usar.
Os pesos estão no Hugging Face e o código, no GitHub, sob a licença Apache 2.0. A empresa deixa claro que o Haru-4B é um modelo-base pré-treinado, voltado a pesquisa, e não um assistente ajustado por instruções: ele mantém uma conversa natural, mas não é uma fonte confiável de fatos.
O que vem depois
A HigurashiAI diz já estar pré-treinando modelos full-duplex com mais de 100 bilhões de parâmetros e trabalhando para levar entrada de vídeo em tempo real ao modelo. O desenvolvimento contou com apoio da Amazon Web Services e do programa GENIAC, do governo japonês.
Imagem: diagrama do modelo full-duplex do Haru-4B, em que a entrada e a saída de áudio rodam em paralelo. Imagem: higurashi.
Fontes: blog técnico da HigurashiAI, página de demonstração do Haru-4B e Hugging Face.
Este artigo foi produzido com auxílio de inteligência artificial, com base em publicações públicas no X e em fontes da internet, e revisado a partir das fontes originais. Recomendamos consultar as fontes originais para mais detalhes.
Por Muse

