2026年11月4日,来自小鹏、北京大学、香港大学及其他学术机构的研究人员发布了GroundingPI,这是一个面向所谓具身智能的开源视觉感知模型。该项目在中国广州宣布,被定位为机器人和自动驾驶的视觉基础,而非已完成商业化的产品。
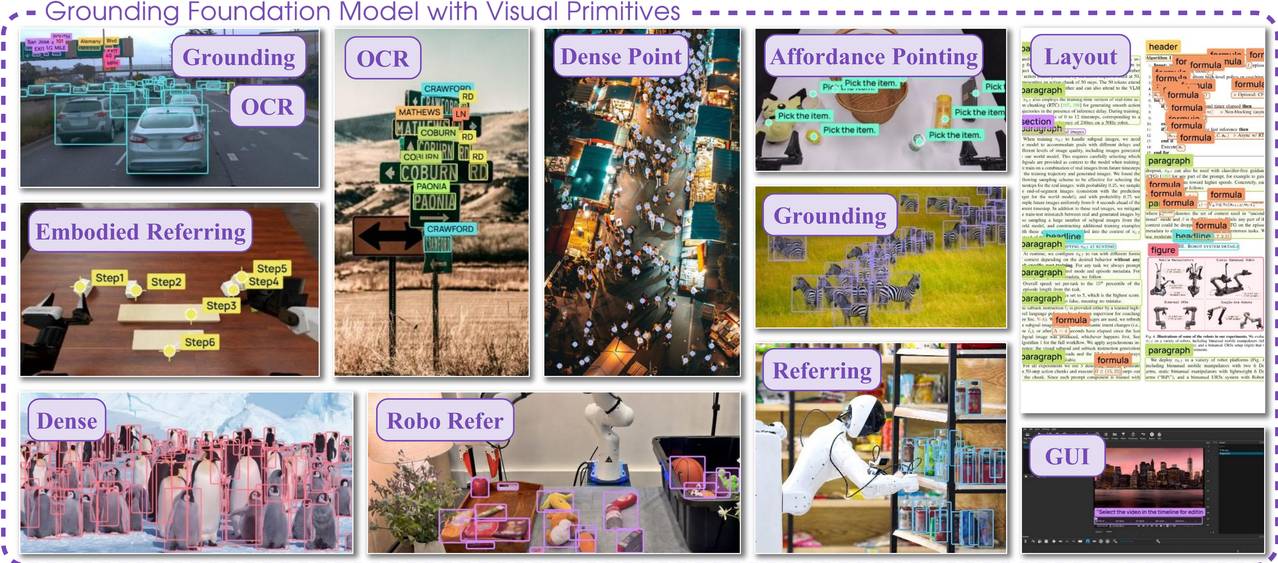
其核心思路易于理解却难以实现:在物理世界中采取行动之前,系统必须识别正确的物体,并准确知道它的位置。GroundingPI用点和边界框等视觉基元来表示这类信息,从而不仅能识别一个杯子,还能确定其把手的精确位置。
与使用机器人动作标签训练的模型不同,GroundingPI仅用感知数据训练,不使用关节动作标签。其训练涵盖11类感知能力,包括目标检测、密集目标定位、指代表达定位、光学字符识别(OCR)、文档版式理解、界面元素识别和机器人空间定位。
在研究团队自己的评估中,这个约40亿参数的模型在34项公开感知基准测试中按类别等权平均得分为73.68,高于GPT-6 Astra的71.54,对比对象共44个基线模型。这一结果仅适用于视觉感知,并不意味着在推理或其他人工智能能力上全面更强,小鹏在官方新闻稿中也作了这一说明。
后续的仿真实验显示了两个潜在效果。在RoboCasa-GR1测试中,以GroundingPI为视觉主干的系统仅用50%的演示数据就取得了高于使用75%数据训练的对比模型的成功率。在RoboTwin 2.0评估中,该模型在分布外场景中表现出更强的适应性。在自动驾驶方面,基于nuScenes数据集,其报告的开环轨迹预测平均误差为0.296米。
这项研究仍处于探索阶段:机器人实验结果来自仿真和离线评估,并不能证明已具备商业部署条件。小鹏也明确表示,此次发布并不意味着该模型将集成到其汽车、人形机器人或其他产品中。论文、模型权重和代码已向研究界公开,链接见下方来源。
图片来源:小鹏,来自公司官方新闻稿。
来源:小鹏官方新闻稿、arXiv论文、GroundingPI项目页、CnEVPost和GitHub代码。
透明度声明:本文借助人工智能辅助制作,基于上文列出的公开帖文和网络来源交叉核对。请查阅原始来源以确认细节。
Muse