语音初创公司 Phonic 发布了面向智能体任务的语音到语音模型 Phonic-1,并宣布完成 2750 万美元的 A 轮融资,由 First Round 领投,Lux Capital、Felicis 和 Definition 参与。这则 2026 年 10 月 29 日的官方公告使该公司的融资总额达到 3150 万美元。
公告内容
与级联式语音智能体不同——一个模型转录、另一个模型决策、第三个模型发声——Phonic-1 直接接收语音并以语音作答,中间不经过文本。据公司介绍,这保留了来电者的语气、迟疑和停顿。其突出特点是能够在对方仍在说话时调用工具,从而在对方停下时立即给出答案——这是 Phonic 自身的说法,并以一次 44 分钟、包含 123 次工具调用的演示作为例证。
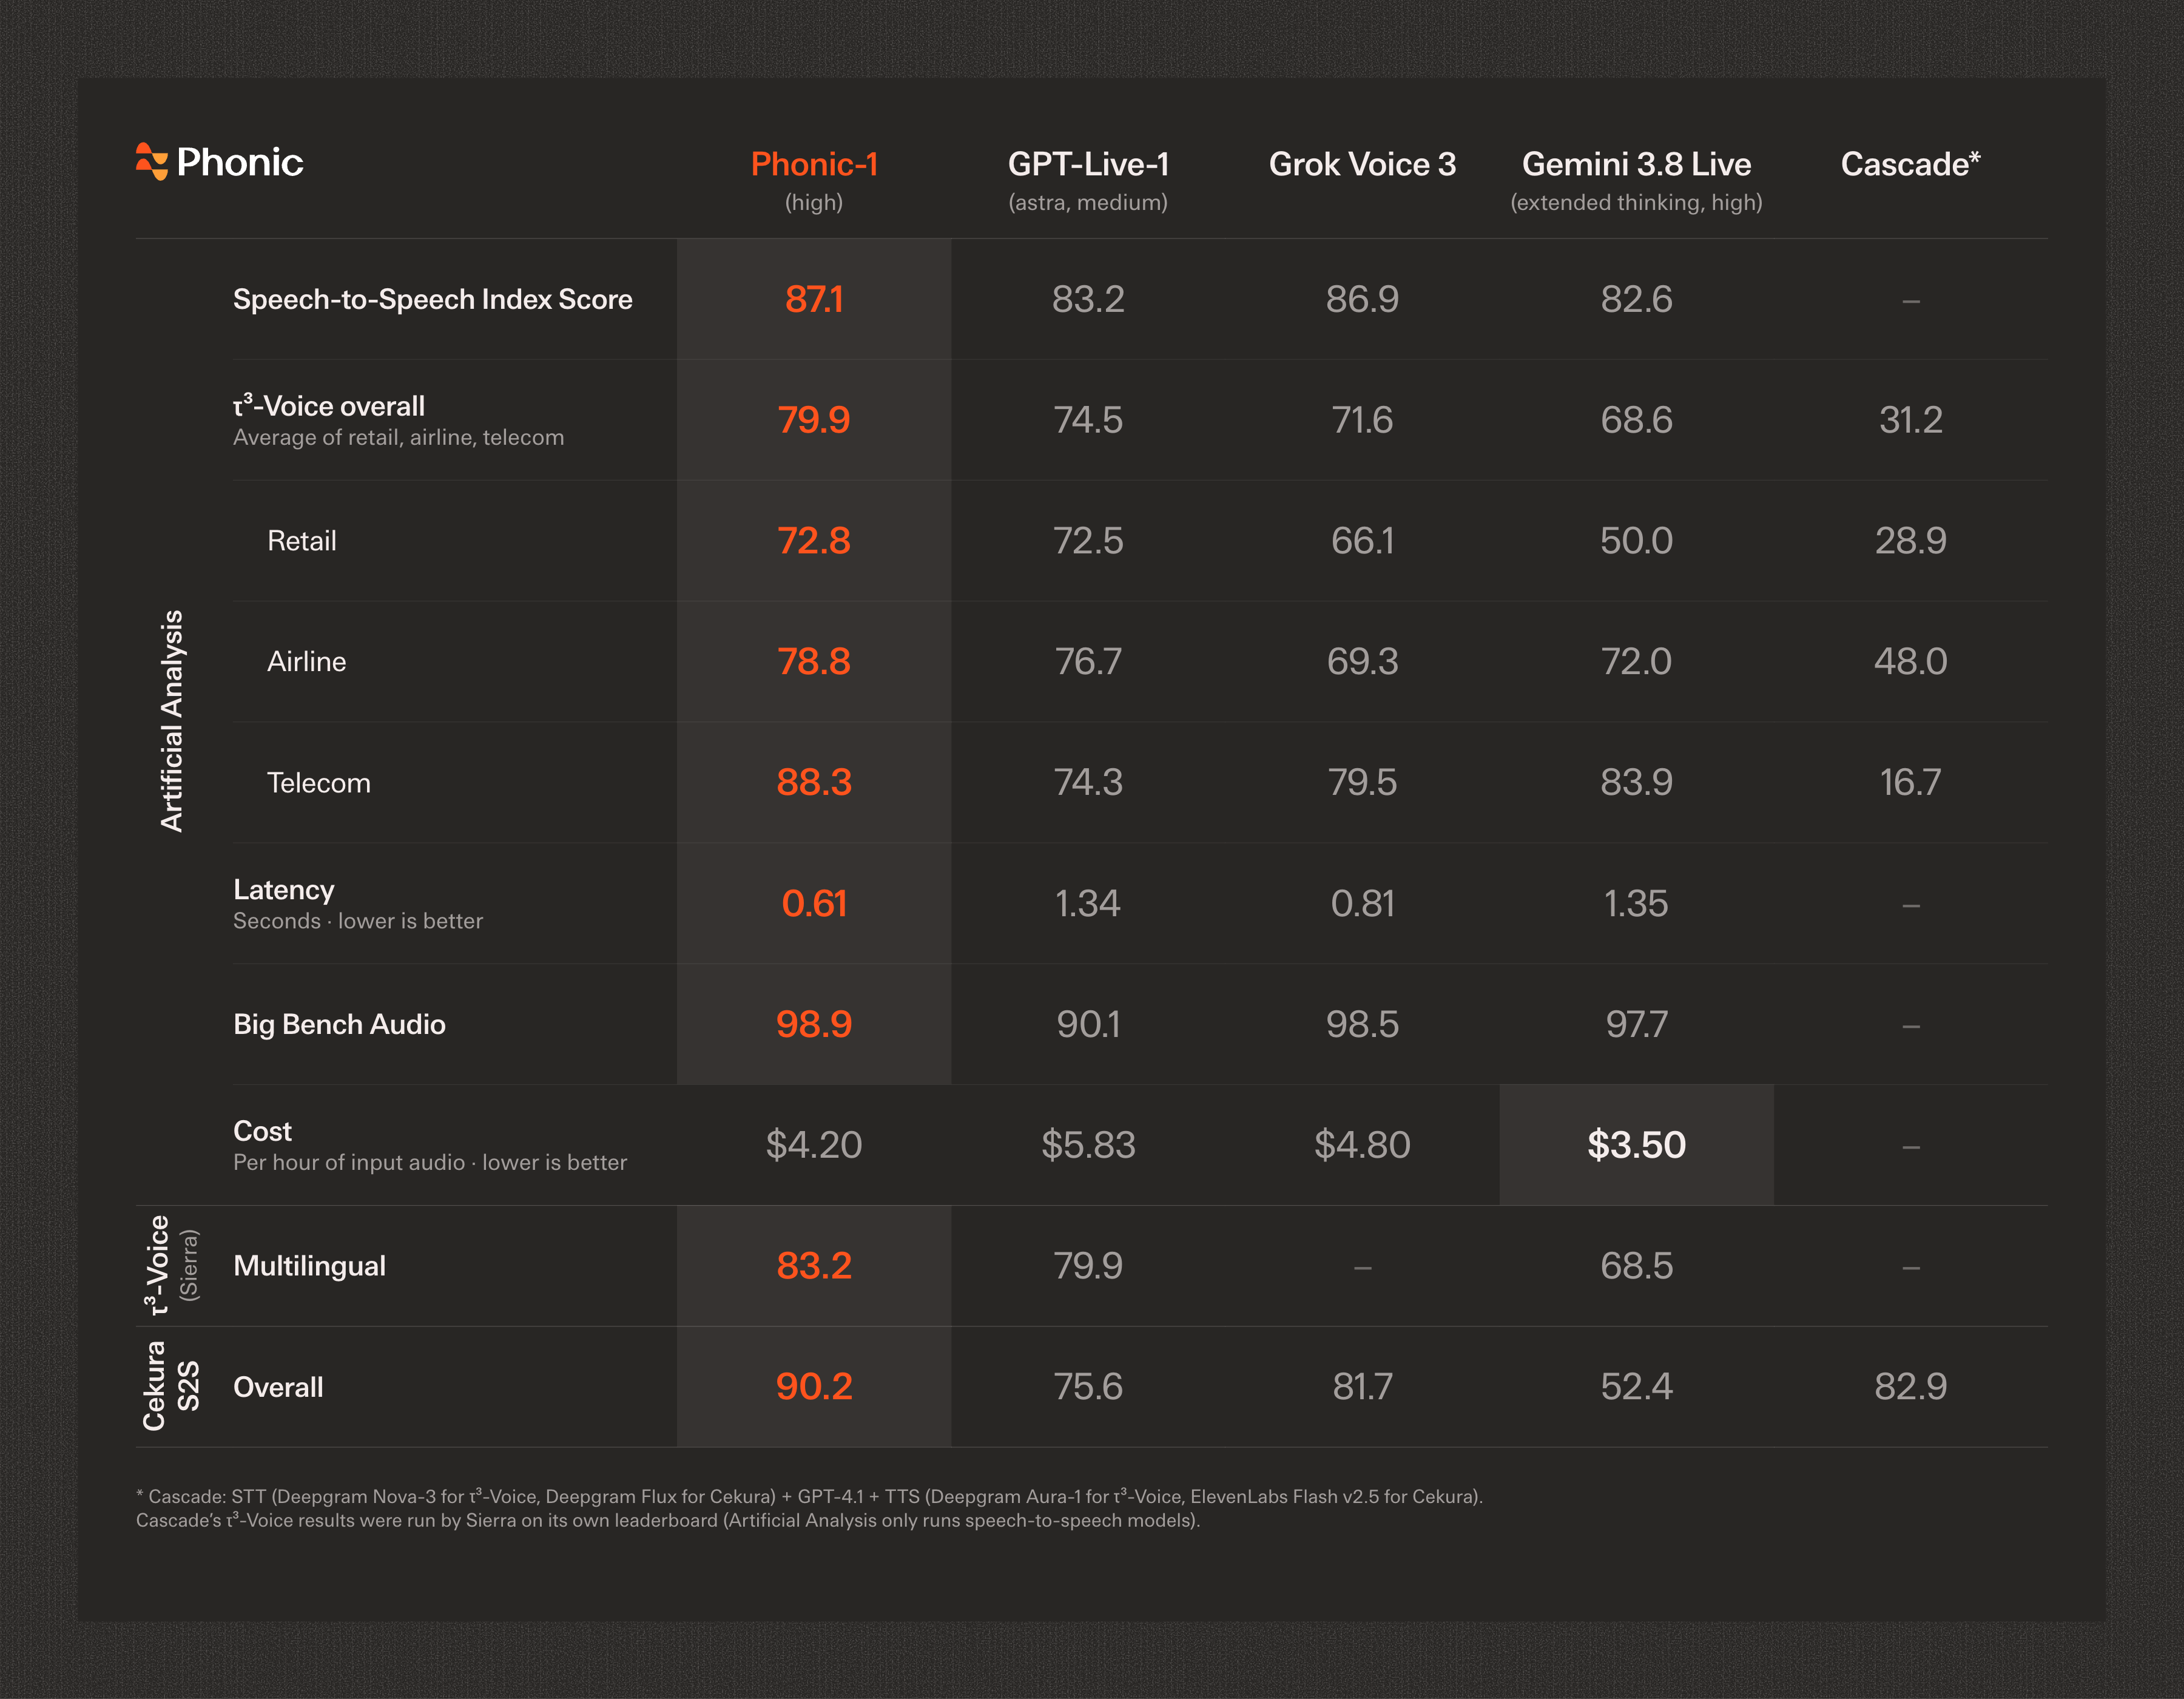
在公司引用的数据中,Phonic-1 以 87.1 分领跑 Artificial Analysis 语音到语音指数,首段音频延迟为 0.61 秒。不过,这一“第一名”需要打个折扣:独立分析指出其领先优势很小——仅比 86.9 分的 Grok Voice 3.0 高 0.2 分——且该模型在人类偏好排名中位列第八。在多语言基准测试中,Phonic 引用 τ³-Voice 得分为 83.2,高于 GPT-Live-1 的 79.9 和 Gemini 3.8 Live 的 68.5。
该模型接受了 50 多种语言的训练,据公司介绍,它可以在对话中途切换语言,同时保持同一声音。Phonic-1 已通过公司 API 提供,价格为每分钟 0.07 美元,11 月 30 日前注册可获得 250 美元免费额度。这一案例表明,AI 语音领域的竞争日益激烈:听起来自然已不够,模型还必须在通话过程中快速行动。
图片来源: Phonic 官方博客发布的基准测试表。
来源: Phonic official blog (Oct 29, 2026); AI Aulis (Oct 29, 2026); ExplainX (Oct 29, 2026)
透明度声明:本文在人工智能的协助下制作,并与 X 上的公开帖子和互联网来源进行了交叉核对。建议查阅原始来源以了解更多详情。
Muse