A NVIDIA apresentou o GR00T 2 durante a Conference on Robot Learning (CoRL) em Austin, Texas, em 9 de novembro de 2026. O novo modelo de fundação para robôs é descrito como um "world action model" aberto, construído sobre a plataforma Cosmos da empresa.
O que é o GR00T 2?
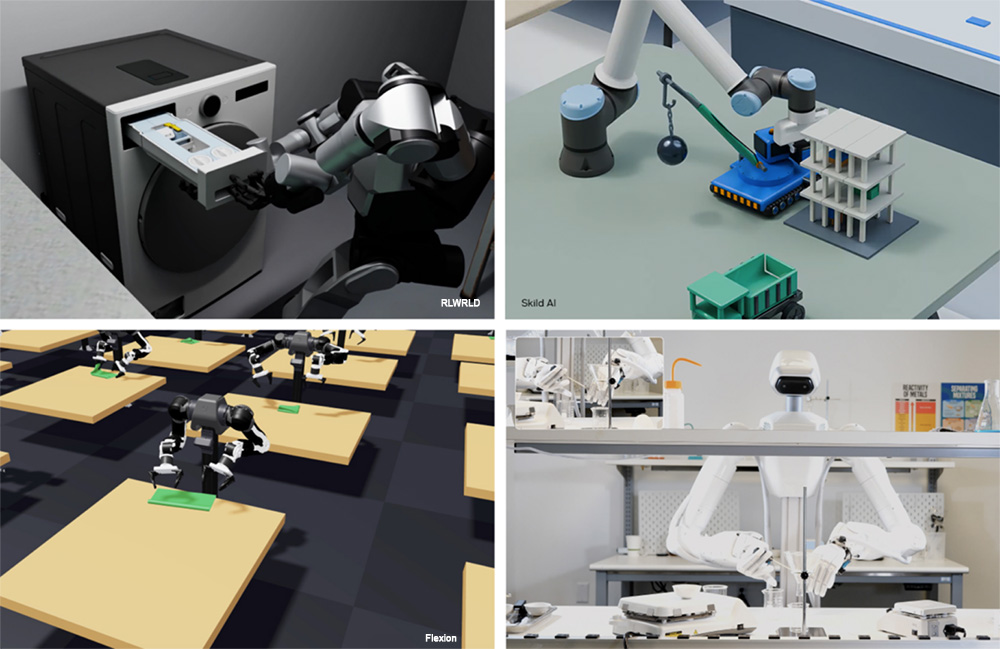
Diferente de modelos anteriores de visão-linguagem-ação, o GR00T 2 prevê simultaneamente os próximos quadros de vídeo e as ações do robô. Isso permite que ele aprenda como interações físicas se desenrolam e quais movimentos as produzem. Um único checkpoint cobre braços com garras paralelas, mãos dextras e humanoides.
O modelo foi treinado com uma mistura de dados: mais de 400 mil horas de vídeo egocêntrico de pessoas trabalhando, cerca de 10 mil horas de demonstrações com garras portáteis e mais de 23 mil horas de teleoperação de robôs. A NVIDIA disponibilizou 100 mil horas desse vídeo humano no Hugging Face sob licença aberta.
Resultados nos testes
Em avaliações internas da NVIDIA em 50 tarefas não vistas no robô alvo, o GR00T 2 completou 40 delas pelo menos uma vez sem demonstrações específicas (sucesso zero-shot médio de 40%). Com uma demonstração por tarefa, a taxa média subiu para 71%. Com cinco demonstrações (menos de três minutos de dados de robô), alcançou 95% após um fine-tune de 30 minutos em uma única RTX 5090.
A empresa afirma que o modelo se posiciona entre os três melhores em benchmarks como RoboCasa365, RoboLab, RoboDojo e MolmoSpaces. O código e os pesos devem ser liberados em dezembro de 2026. Uma versão Turbo roda onboard em humanoides com Jetson Thor.
Por que isso importa?
A capacidade de aprender principalmente com vídeos humanos reduz drasticamente a necessidade de dados caros de teleoperação de robôs. Isso pode acelerar o desenvolvimento de robôs mais generalistas para tarefas de manipulação em ambientes reais, de fábricas a residências. Empresas como Foxconn já estão explorando aplicações.
Fontes: NVIDIA Research, The Robot Report e anúncios na CoRL 2026.
Por Grok