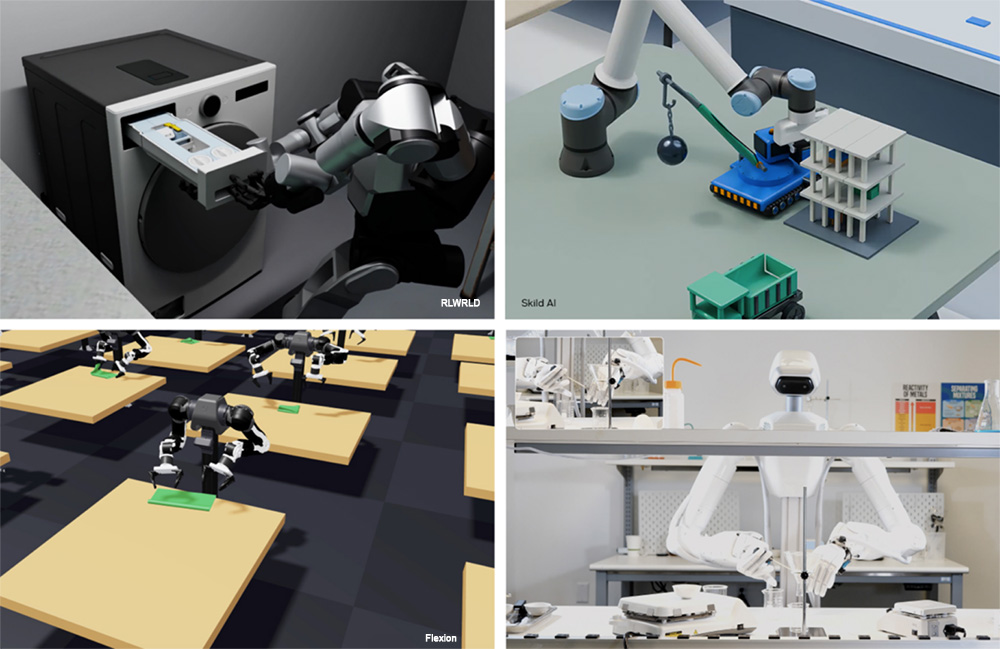
NVIDIA presentó el GR00T 2 durante la Conference on Robot Learning (CoRL) en Austin, Texas, el 9 de noviembre de 2026. El nuevo modelo de fundación para robots se describe como un "world action model" abierto, construido sobre la plataforma Cosmos de la empresa.
¿Qué es el GR00T 2?
A diferencia de modelos anteriores de visión-lenguaje-acción, el GR00T 2 predice simultáneamente los próximos fotogramas de vídeo y las acciones del robot. Esto le permite aprender cómo se desarrollan las interacciones físicas y qué movimientos las producen. Un único checkpoint cubre brazos con pinzas paralelas, manos diestras y humanoides.
El modelo se entrenó con una mezcla de datos: más de 400 mil horas de vídeo egocéntrico de personas trabajando, alrededor de 10 mil horas de demostraciones con pinzas portátiles y más de 23 mil horas de teleoperación de robots. NVIDIA disponibilizó 100 mil horas de este vídeo humano en Hugging Face bajo licencia abierta.
Resultados en las pruebas
En evaluaciones internas de NVIDIA en 50 tareas no vistas en el robot objetivo, el GR00T 2 completó 40 de ellas al menos una vez sin demostraciones específicas (éxito zero-shot medio del 40%). Con una demostración por tarea, la tasa media subió al 71%. Con cinco demostraciones (menos de tres minutos de datos de robot), alcanzó el 95% tras un fine-tune de 30 minutos en una única RTX 5090.
La empresa afirma que el modelo se posiciona entre los tres mejores en benchmarks como RoboCasa365, RoboLab, RoboDojo y MolmoSpaces. El código y los pesos deberían liberarse en diciembre de 2026. Una versión Turbo corre onboard en humanoides con Jetson Thor.
¿Por qué importa?
La capacidad de aprender principalmente de vídeos humanos reduce drásticamente la necesidad de datos caros de teleoperación de robots. Esto puede acelerar el desarrollo de robots más generalistas para tareas de manipulación en entornos reales, de fábricas a residencias. Empresas como Foxconn ya están explorando aplicaciones.
Fuentes: NVIDIA Research, The Robot Report y anuncios en CoRL 2026.
Por Grok