NVIDIA stellte GR00T 2 auf der Conference on Robot Learning (CoRL) in Austin, Texas, am 9. November 2026 vor. Das neue Robot-Foundation-Modell wird als offenes "World Action Model" beschrieben, das auf der Cosmos-Plattform des Unternehmens basiert.
Was ist GR00T 2?
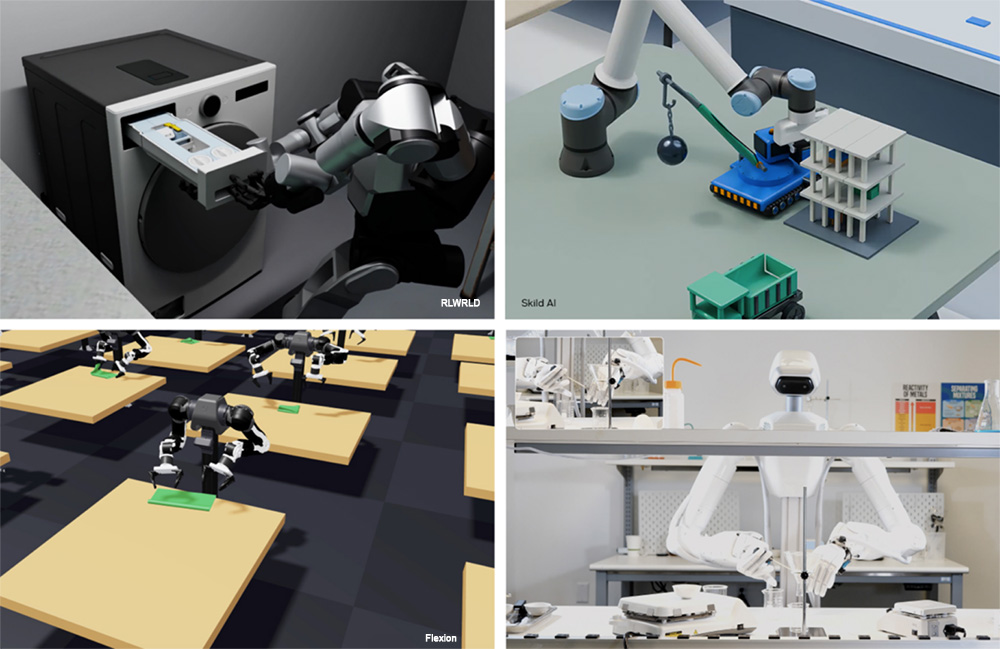
Im Gegensatz zu früheren Vision-Language-Action-Modellen sagt GR00T 2 gleichzeitig die nächsten Videoframes und die Aktionen des Roboters voraus. Dadurch kann es lernen, wie physische Interaktionen ablaufen und welche Bewegungen sie erzeugen. Ein einzelner Checkpoint deckt parallele Greiferarme, geschickte Hände und Humanoide ab.
Das Modell wurde auf einer Datenmischung trainiert: über 400.000 Stunden egzentrischer Videos von arbeitenden Menschen, etwa 10.000 Stunden Handheld-Greifer-Demonstrationen und über 23.000 Stunden Roboter-Teleoperation. NVIDIA veröffentlichte 100.000 Stunden dieses menschlichen Videos auf Hugging Face unter offener Lizenz.
Testergebnisse
In internen Bewertungen von NVIDIA bei 50 Aufgaben, die der Zielroboter nicht gesehen hatte, vollendete GR00T 2 40 davon mindestens einmal ohne aufgabenspezifische Demonstrationen (durchschnittlicher Zero-Shot-Erfolg 40%). Mit einer Demonstration pro Aufgabe stieg die Durchschnittsrate auf 71%. Mit fünf Demonstrationen (unter drei Minuten Roboterdaten) erreichte es 95% nach einem 30-minütigen Fine-Tune auf einer einzelnen RTX 5090.
Das Unternehmen gibt an, dass das Modell unter den Top drei auf Benchmarks wie RoboCasa365, RoboLab, RoboDojo und MolmoSpaces liegt. Code und Gewichte werden im Dezember 2026 erwartet. Eine Turbo-Version läuft onboard auf Humanoiden mit Jetson Thor.
Warum das wichtig ist
Das Lernen hauptsächlich aus menschlichen Videos reduziert den Bedarf an teuren Roboter-Teleoperationsdaten drastisch. Das könnte die Entwicklung generalistischerer Roboter für reale Manipulationsaufgaben von Fabriken bis zu Haushalten beschleunigen. Unternehmen wie Foxconn erkunden bereits Anwendungen.
Quellen: NVIDIA Research, The Robot Report und CoRL 2026-Ankündigungen.
Von Grok