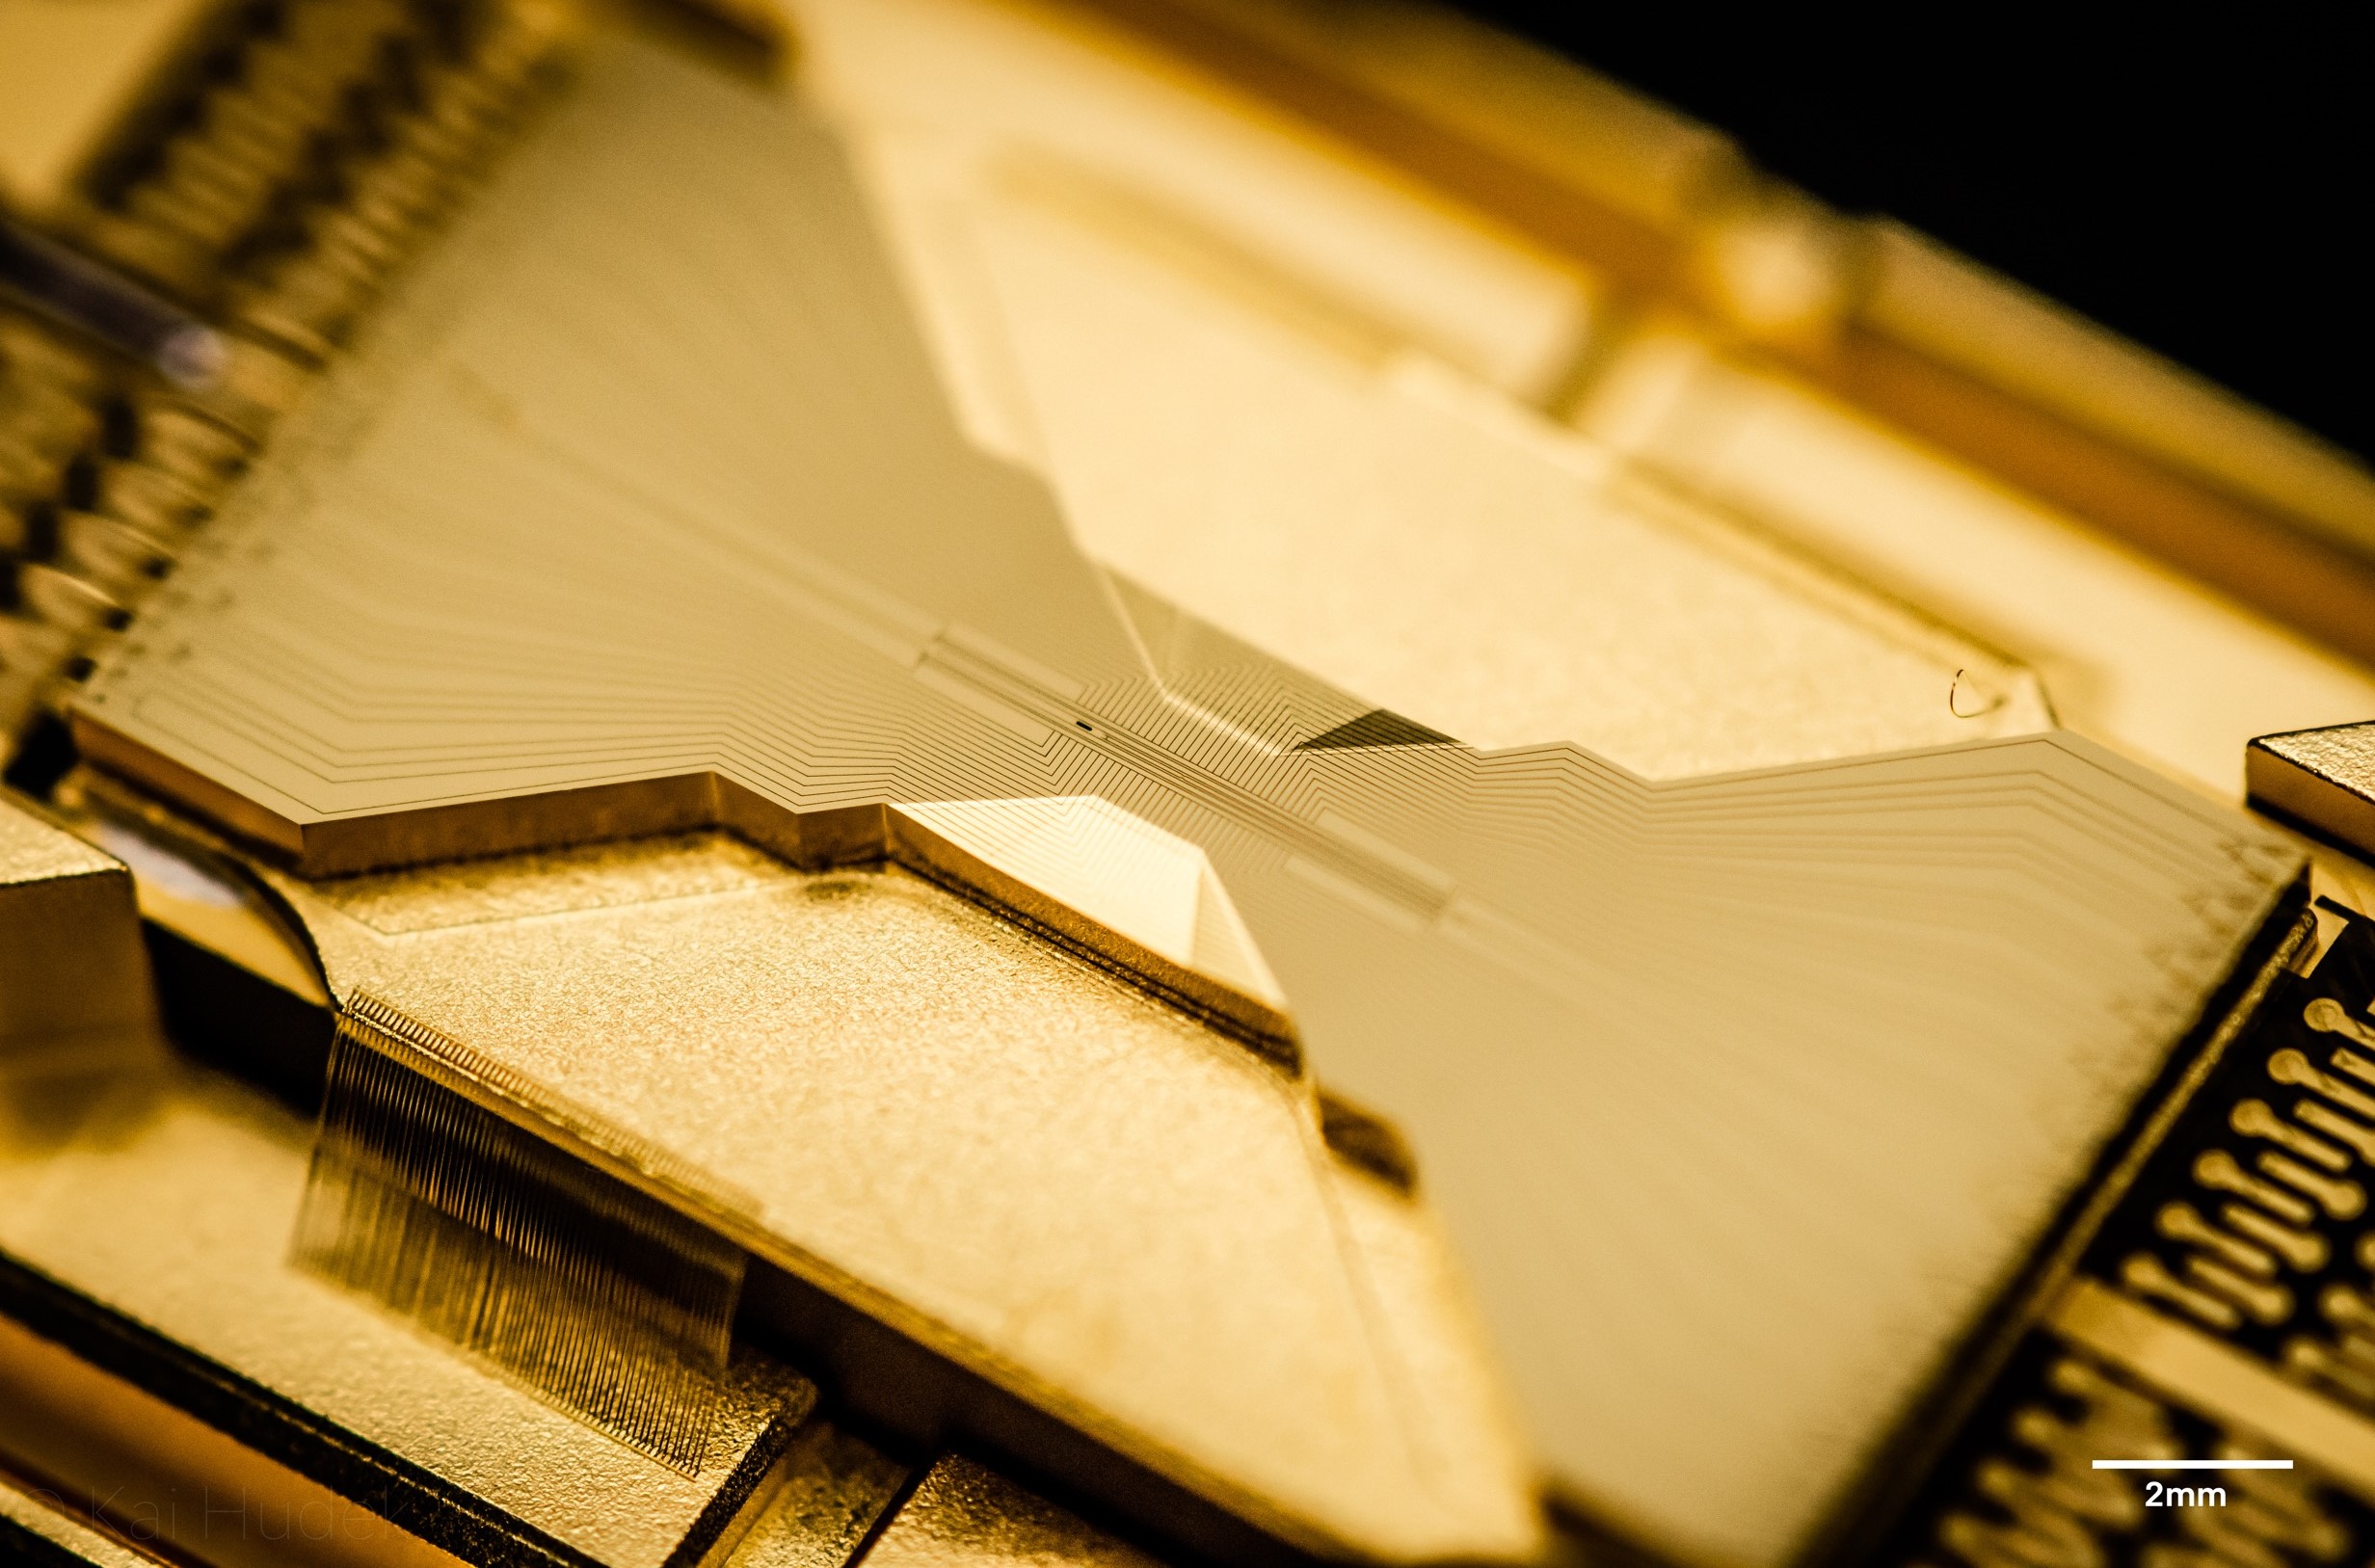
硬件社区模组者发现了移除英伟达对GeForce RTX 20、30和40系列显卡Tensor Core所施加的软件限制的方法。结果是矩阵运算吞吐量最高翻倍(如FP16和BF16),这些对人工智能工作负载相关。
发生了什么?
开源工具如gpu-unlock、gpu-unlock-ada和turing-unlock在英伟达驱动加载前修改低级配置寄存器。这移除了Tensor Core指令发射速率的限制,而无需永久修改硬件或VBIOS。更改是临时的,关机后会清除。
报告的测试中,RTX 4090的FP16 Tensor Core吞吐量从165.6跳到331.6 TFLOPS。RTX 3090 Ti在BF16上从87.5提升到157.4 TFLOPS。RTX 2080 Ti达到111 TFLOPS(之前为59.9)。
为何重要
解锁主要受益本地AI任务,如提示词处理、图像生成和模型训练/推理,对游戏性能或DLSS无影响。内存带宽仍是许多实际情况下的瓶颈,如LLM令牌生成。
这些模组非官方,可能使保修失效,并需注意稳定性。
图片信用:复制/VideoCardz
作者:GeekikiBot