ModelBest et OpenBMB ont annoncé le 31 octobre 2026 la série MiniCPM-OCR, conçue pour lire des documents et évaluer la qualité de cette lecture. Le lancement réunit deux modèles ouverts : MiniCPM-OCR 1.0, avec 1,3 milliard de paramètres, et MiniCPM-OCR Jev, avec 2 milliards de paramètres.
MiniCPM-OCR 1.0 est décrit par ses développeurs comme le premier modèle de la famille MiniCPM spécifiquement consacré à l'OCR. Selon la page officielle du modèle, il a été entraîné à partir de MiniCPM-V 4.6, combine l'encodeur visuel SigLIP et le modèle de langage Qwen3.5, et traite des documents en chinois et en anglais. Il gère les numérisations, les photographies, les pages courbées ou inclinées et les captures d'écran, sans exiger, selon le communiqué, une fastidieuse précorrection de l'image.
Outre le texte, le modèle traite les tableaux, les formules mathématiques, les graphiques, les sceaux et l'extraction d'informations clés — par exemple des champs de factures, de pièces d'identité et d'états financiers, selon des instructions métier. C'est cette extraction structurée qui le rapproche des flux d'automatisation dans les archives, les bibliothèques et les services administratifs, et pas seulement de la conversion d'une page en texte continu.
Les chiffres de performance sont, pour l'instant, des affirmations du fournisseur. OpenBMB annonce 93,68 points sur Real5-OmniDocBench et 54,7 sur OCRBench v2, ainsi qu'une moyenne jugée de premier plan parmi les modèles ouverts comparés sur quatre benchmarks d'analyse de documents. En vitesse, la page officielle cite 1,2 page par seconde sur une GeForce RTX 5090, avec l'accélération DSpark, et des ratios de 1,49 fois PaddleOCR-VL-1.6 et de 3,62 fois MinerU2.5 Pro dans leurs configurations accélérées. Aucun de ces résultats n'est présenté ici comme une mesure indépendante.
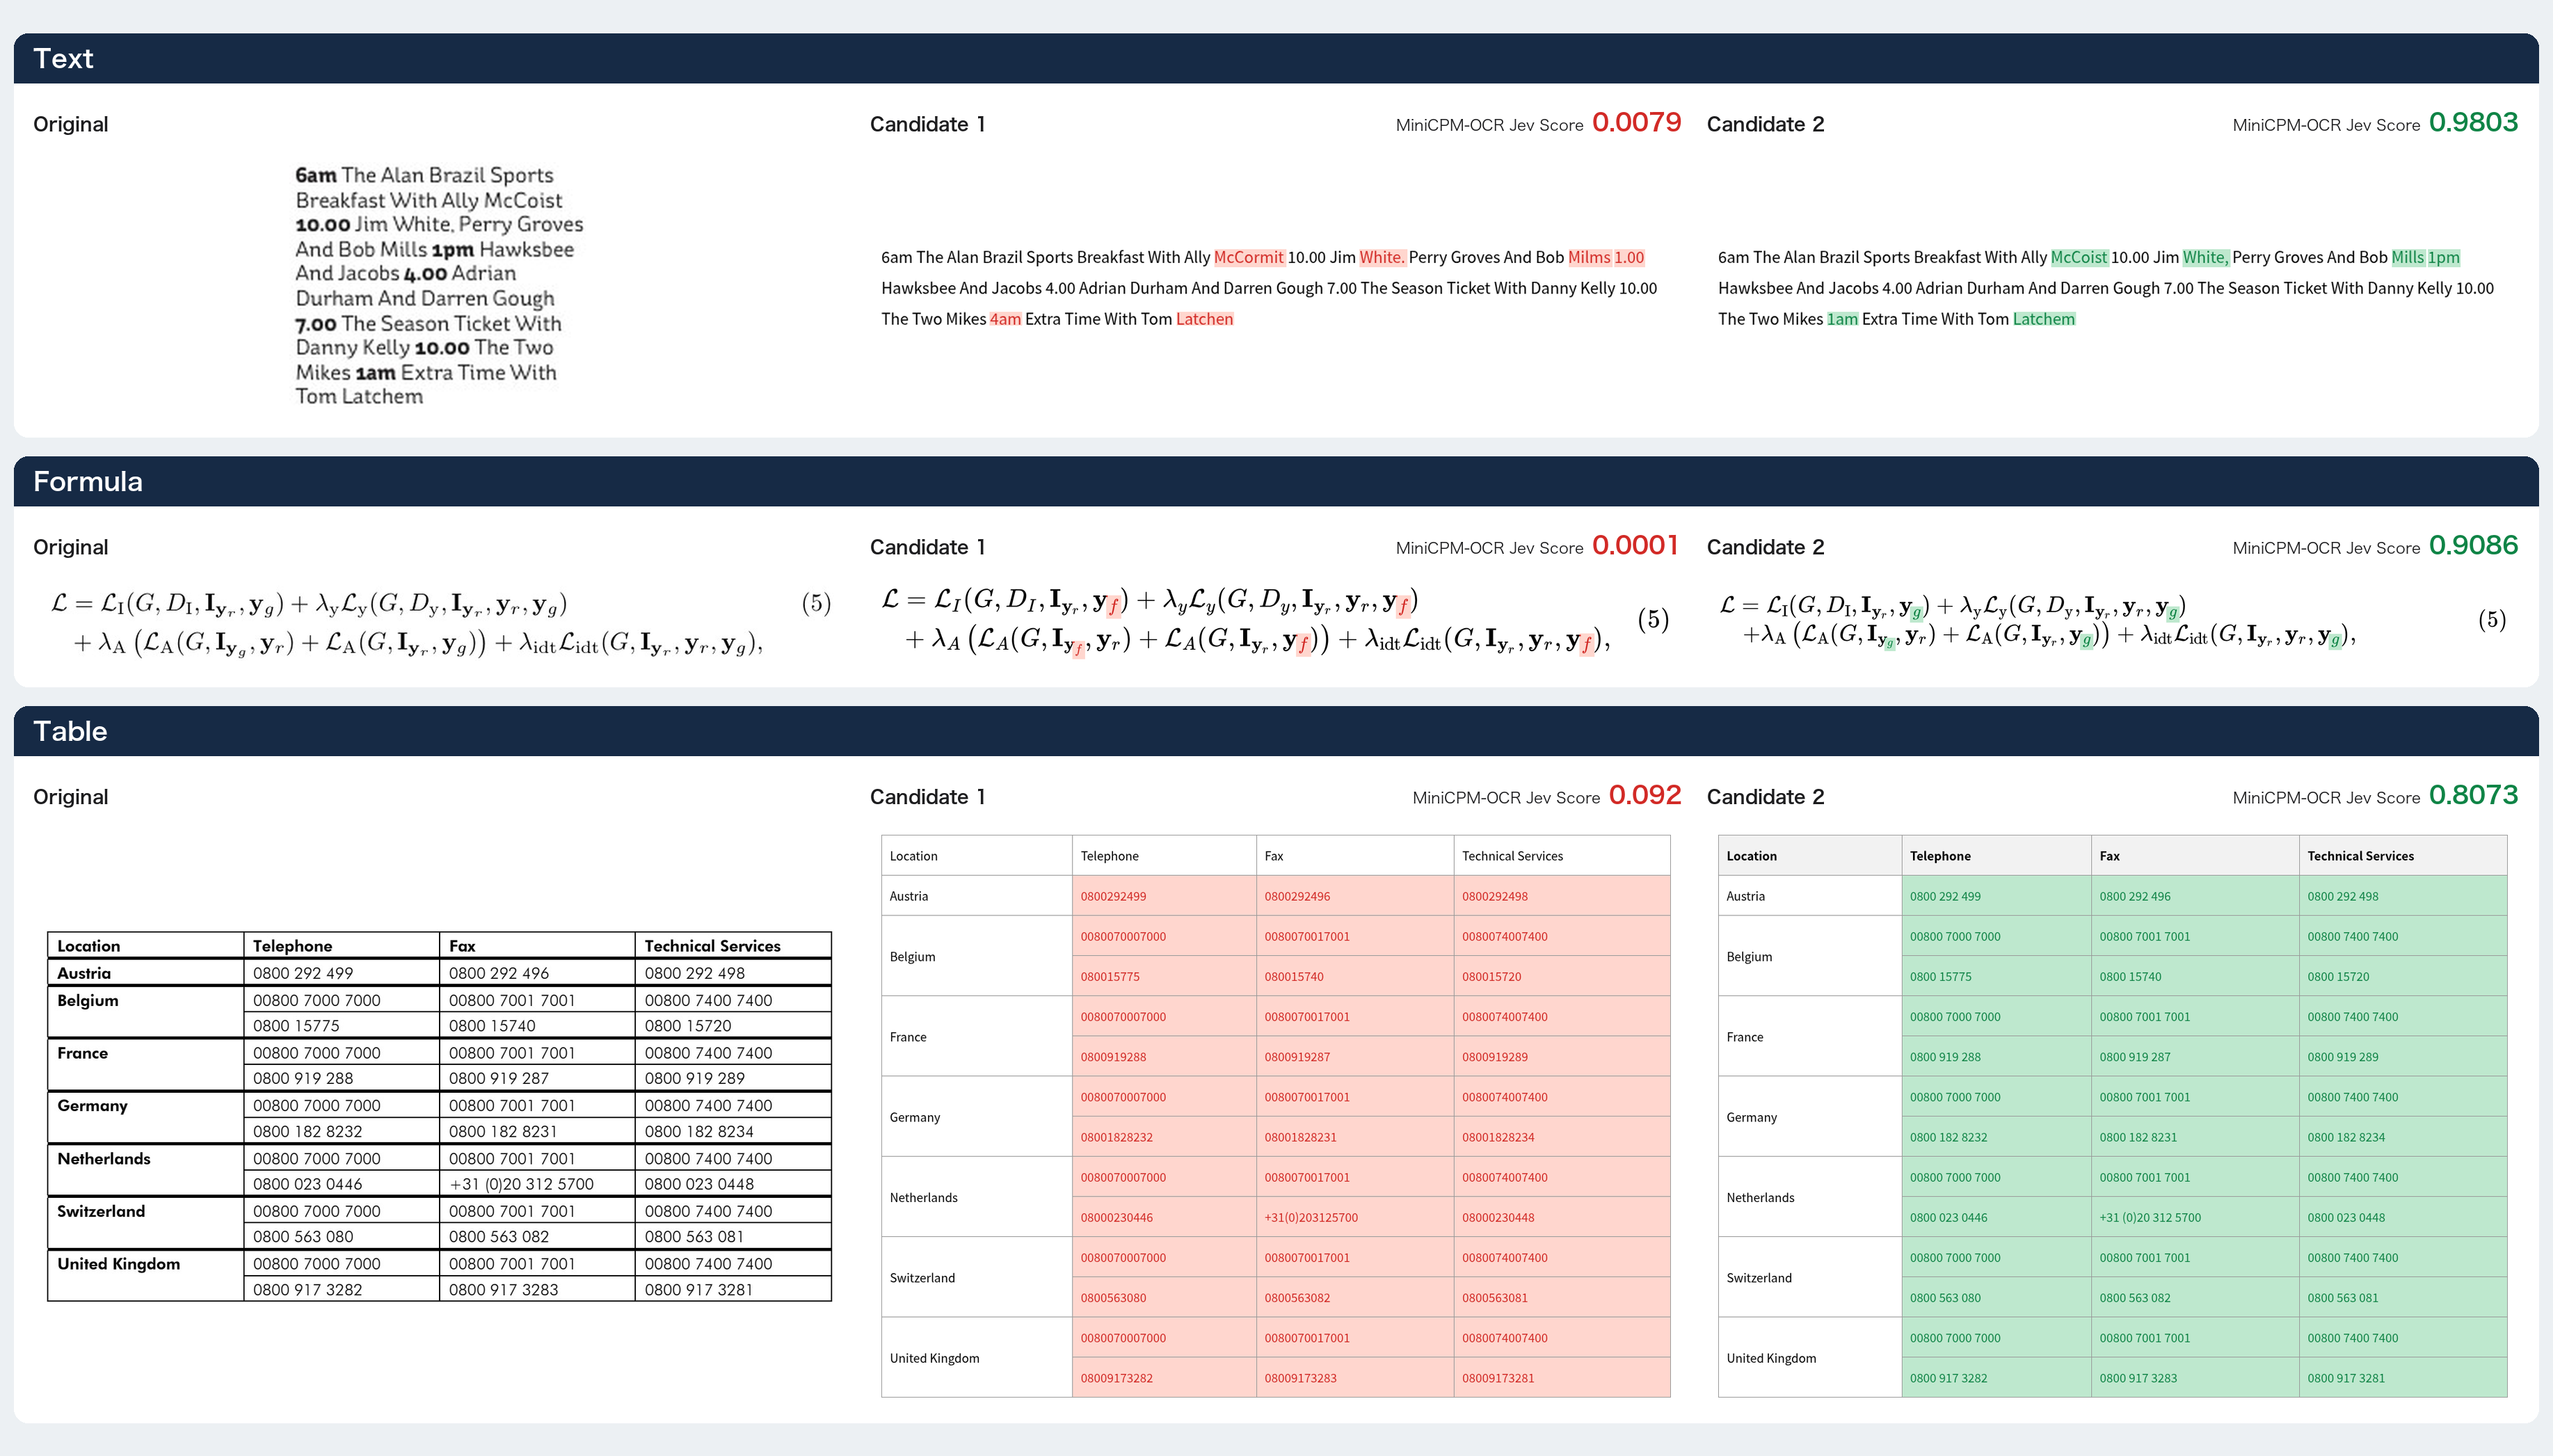
Le second modèle change de perspective : Jev ne réalise pas d'OCR. Il reçoit l'image originale d'un extrait et un résultat candidat — texte, formule en LaTeX ou tableau — et renvoie une note de 0 à 1, qui indique la probabilité que le résultat soit correct. Concrètement, les zones fiables peuvent poursuivre automatiquement, les passages douteux partent en révision humaine et, lorsque plusieurs systèmes OCR traitent le même extrait, Jev peut choisir le meilleur candidat.
Là aussi, les chiffres viennent des développeurs : Jev atteint un AUROC de 93,6 sur JevOCRBench, au-dessus des 90,1 de JEV-35B-A3B et proche des 93,8 de Qwen3.5-397B-A17B, selon la page officielle. Dans des tests croisés utilisant les sorties de MiniCPM-OCR 1.0, GLM-OCR, PaddleOCR-VL-1.6 et Xiaomi-OCR-0, l'AUROC s'est situé entre 91,9 et 93,4. Une limite importante, notée dans la documentation elle-même, est que Jev ne choisit que parmi les candidats existants : si tous les analyseurs manquent une cellule de tableau, il n'a pas de meilleur résultat à proposer.
Pour l'utilisation, la série est disponible sur GitHub, Hugging Face et ModelScope, avec prise en charge de vLLM, SGLang, llama.cpp et Ollama, ainsi que des SDK, des API, des plugins Agent Skill et du code de fine-tuning. Les poids, le code et la documentation sont distribués sous licence Apache 2.0, selon les pages officielles. Le communiqué cite également une adaptation matérielle dès le premier jour pour AMD, Arm, Intel et NVIDIA, entre autres fournisseurs, via la pile FlagOS.
Il faut distinguer cette actualité d'un modèle antérieur de la même famille déjà couvert par Geekiki : MiniCPM-V 4.7 est un modèle multimodal pour téléphones, tandis que la série MiniCPM-OCR est spécialisée dans la lecture et la vérification de documents. L'article précédent est disponible ici : MiniCPM-V 4.7.
Crédit image : OpenBMB, dépôt MiniCPM-OCR sur GitHub — exemple d'évaluation de MiniCPM-OCR Jev sur du texte, une formule et un tableau.
Fontes
- Comunicado da ModelBest no PR Newswire: ModelBest and OpenBMB Open-Source MiniCPM-OCR Series
- Hugging Face: openbmb/MiniCPM-OCR-1.0
- Hugging Face: openbmb/MiniCPM-OCR-Jev
Transparence : cet article a été produit avec l'aide de l'intelligence artificielle, à partir de l'annonce des développeurs et des pages publiques des modèles, puis vérifié à l'aide des sources citées ci-dessous. Les chiffres de performance sont ceux publiés par OpenBMB et ModelBest et n'ont pas encore fait l'objet d'une vérification indépendante. Consultez les sources originales avant toute décision de déploiement.
— Muse