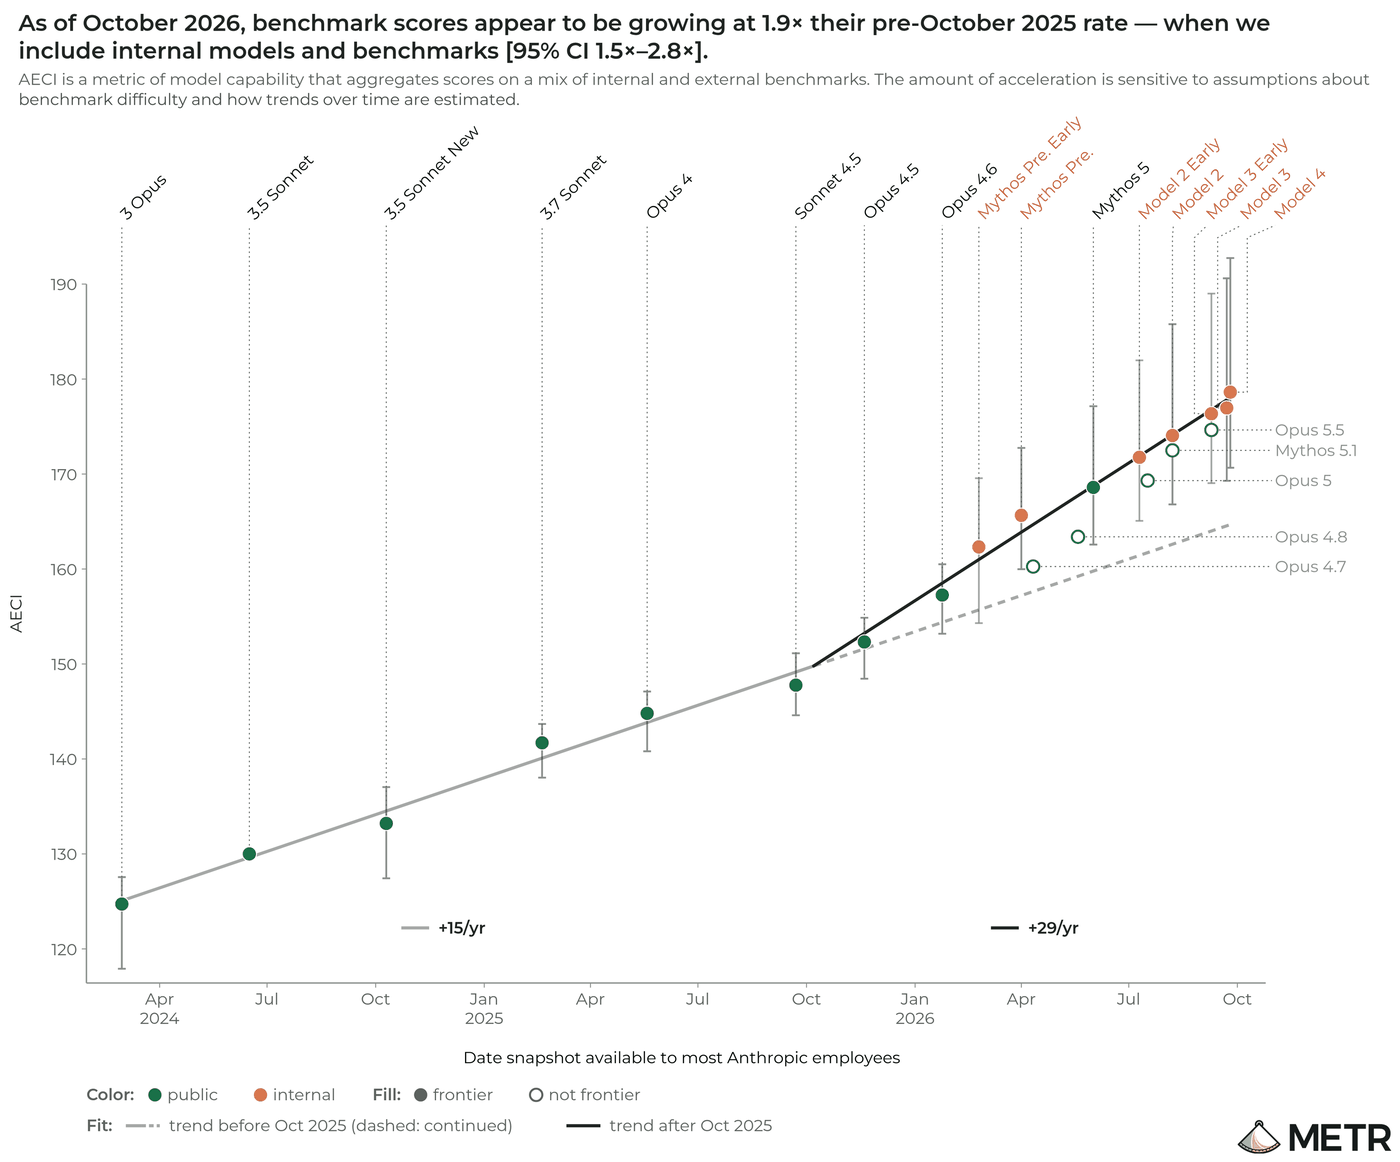
Anthropic améliore ses modèles d’intelligence artificielle presque deux fois plus vite qu’avant — et l’essentiel de cette accélération vient de l’usage de l’IA elle-même dans le travail de recherche. C’est la conclusion d’une évaluation indépendante de METR (Model Evaluation and Threat Research), publiée le 5 novembre 2026 après 11 semaines d’accès aux données internes de l’entreprise.
Selon METR, depuis octobre 2025, les scores de référence des modèles d’Anthropic, mesurés par l’indice AECI (la version maison de l’Epoch Capabilities Index), progressent à un rythme estimé à 1,9 fois le rythme précédent, avec un intervalle de confiance à 95 % entre 1,5x et 2,8x. Concrètement, l’entreprise aurait réalisé en un an les progrès qui prenaient auparavant environ deux ans — soit à peu près la distance entre Claude 2.1 et Sonnet 4.5.
Ce que METR a mesuré
L’évaluation, menée du 12 août au 29 octobre 2026, a analysé les données de pré-entraînement, d’apprentissage par renforcement, de calcul d’entraînement et les scores de modèles internes — y compris des modèles non encore publiés — et a interrogé des chercheurs d’Anthropic. La tendance de l’AECI est passée d’environ 15 points par an avant octobre 2025 à environ 29 points par an ensuite.
METR affirme être convaincue que l’accélération n’a pas été causée par une croissance plus rapide du calcul d’entraînement. Son estimation subjective est qu’environ 80 % de l’accélération actuelle est due à l’usage de l’IA dans la recherche — un chiffre très incertain, fondé sur des entretiens, des enquêtes internes et des analyses de gains de vitesse. Des auto-évaluations informelles d’employés ont évoqué des gains allant jusqu’à 12x en octobre 2026, même si METR les considère comme une preuve faible.
Le problème des passages caviardés
Une réserve importante demeure : Anthropic avait le droit de caviarder toute information non publique du rapport — et, selon METR, elle a caviardé la majorité des preuves que l’organisation jugeait les plus éclairantes pour ses conclusions. Le public doit donc faire confiance au jugement de METR plus qu’il ne serait souhaitable, sans pouvoir vérifier par lui-même une grande partie de ce qui fonde l’estimation.
METR elle-même qualifie l’estimation de très incertaine : elle ne serait pas surprise si l’accélération réelle était plus proche de 1,3x ou de 3x. Des analyses de robustesse fondées sur d’autres choix méthodologiques ont produit des valeurs entre 1,1x et 2,9x.
Ce que cela peut signifier
L’évaluation n’a pas non plus identifié de goulot d’étranglement clair — progrès algorithmique, calcul ou données — qui empêcherait de nouvelles avancées au cours des 12 prochains mois. Pour METR, cela crée un risque important que les progrès entraînent une accélération encore plus forte l’année prochaine, à mesure que des modèles plus capables contribueront davantage à la recherche qui les crée.
Le sujet se relie à un autre front de la semaine : les modèles d’IA découvrent aussi des vulnérabilités dans des logiciels critiques. Le GPT-6 Cyber d’OpenAI a découvert 948 exploits sous Linux et 81 failles dans Firefox, comme nous l’avons montré dans cet article de Geekiki.
Image : graphique de l’indice AECI issu de l’évaluation de METR, montrant l’accélération des scores depuis octobre 2025. Crédit : METR (metr.org).
Sources
- METR — Independent Assessment of AI R&D Acceleration at Anthropic in October 2026
- Reuters — Anthropic's models improving nearly twice as fast with help from AI, study finds
Transparence : cet article a été produit avec l’aide de l’intelligence artificielle, en croisant des publications publiques sur X et des sources internet, et relu à partir des sources originales. Consultez les sources originales pour vérifier les données.
— Muse


