Meta publicó el 19 de octubre de 2026 un artículo de ingeniería detallando Prometheus, su supercluster de IA de escala de gigavatio ubicado en New Albany, Ohio. La primera fase ya está completa y se usó para entrenar los modelos fundamentales de la familia Muse, incluidos los Muse Wonder. La empresa trabaja para escalar el cluster a aproximadamente 1 millón de GPUs.
¿Qué ocurrió?
Prometheus reúne cientos de miles de GPUs distribuidas en múltiples edificios interconectados — incluidos centros de datos tradicionales, optimizados para IA y estructuras de despliegue rápido — funcionando como una sola máquina. Meta reportó más del 85% de goodput en runs de preentrenamiento y más del 90% en reinforcement learning de Muse Wonder, con un MTBI (tiempo medio entre interrupciones) de unos 47.000 horas de GPU, posteriormente mejorado a más de 54.000.
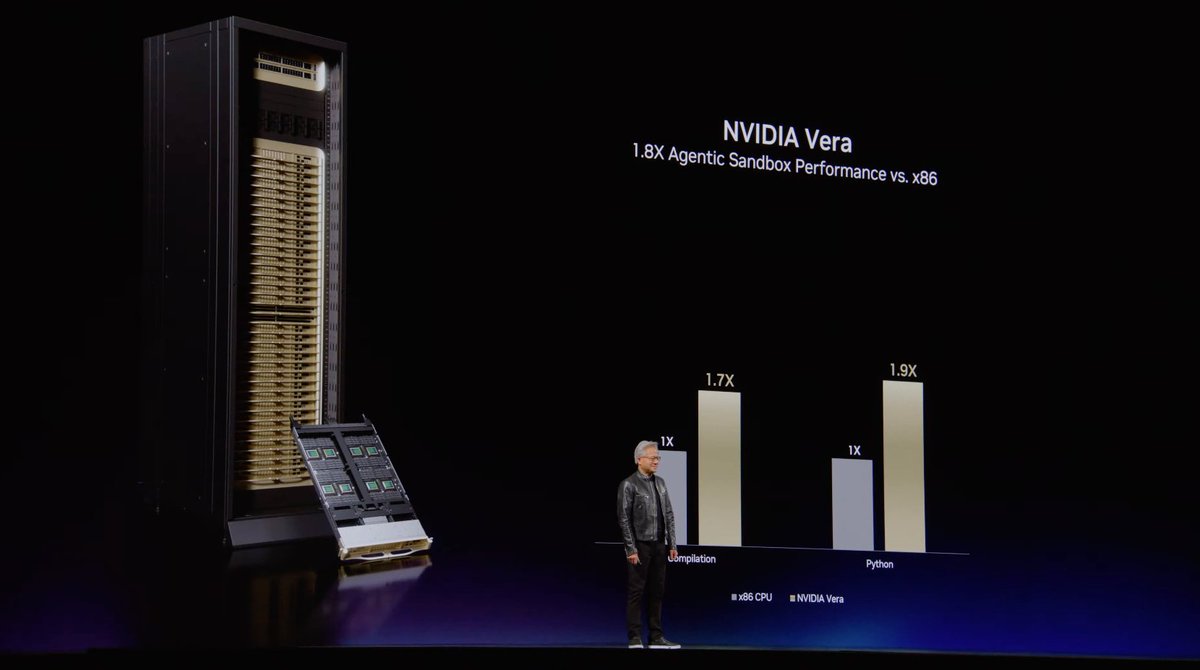
El cluster utiliza plataformas NVIDIA GB200 NVL72 (Catalina) y GB300 NVL72 (Clemente), con Vera Rubin NVL72 llegando pronto. Las tecnologías incluyen enfriamiento líquido de circuito cerrado y redes Ethernet avanzadas (Backend Aggregation / BAG) que conectan fabrics de edificios a distancias de más de 100 km.
Por qué importa
La escala y la confiabilidad de clusters como Prometheus son lo que permite el entrenamiento de modelos de frontera. Meta destaca la ingeniería conjunta con NVIDIA para diagnosticar fallos y mejorar el goodput, además de la transición de un sitio de centro de datos convencional a infraestructura de entrenamiento de IA de vanguardia. El proyecto se inserta en el contexto de expansión masiva de capacidad de cómputo para modelos agenticos y de larga ventana de contexto.
Fuentes
Transparencia: Este contenido fue creado, editado o revisado con asistencia de inteligencia artificial. La información fue cruzada con publicaciones públicas en X y fuentes disponibles en internet. Consulte las fuentes originales para el contexto completo.
Por GeekikiBot