O desenvolvedor Vaibhaav Tiwari recriou a arquitetura do DeepSeek V3 JAX em apenas 190 linhas de JAX puro e treinou o modelo do zero em um MacBook Air. O projeto, publicado no GitHub e apresentado no Hacker News em 14 de novembro, condensa as principais ideias do relatório técnico do DeepSeek-V3 em um arquivo legível de ponta a ponta, sem Flax, Equinox ou PyTorch.
O que cabe nas 190 linhas
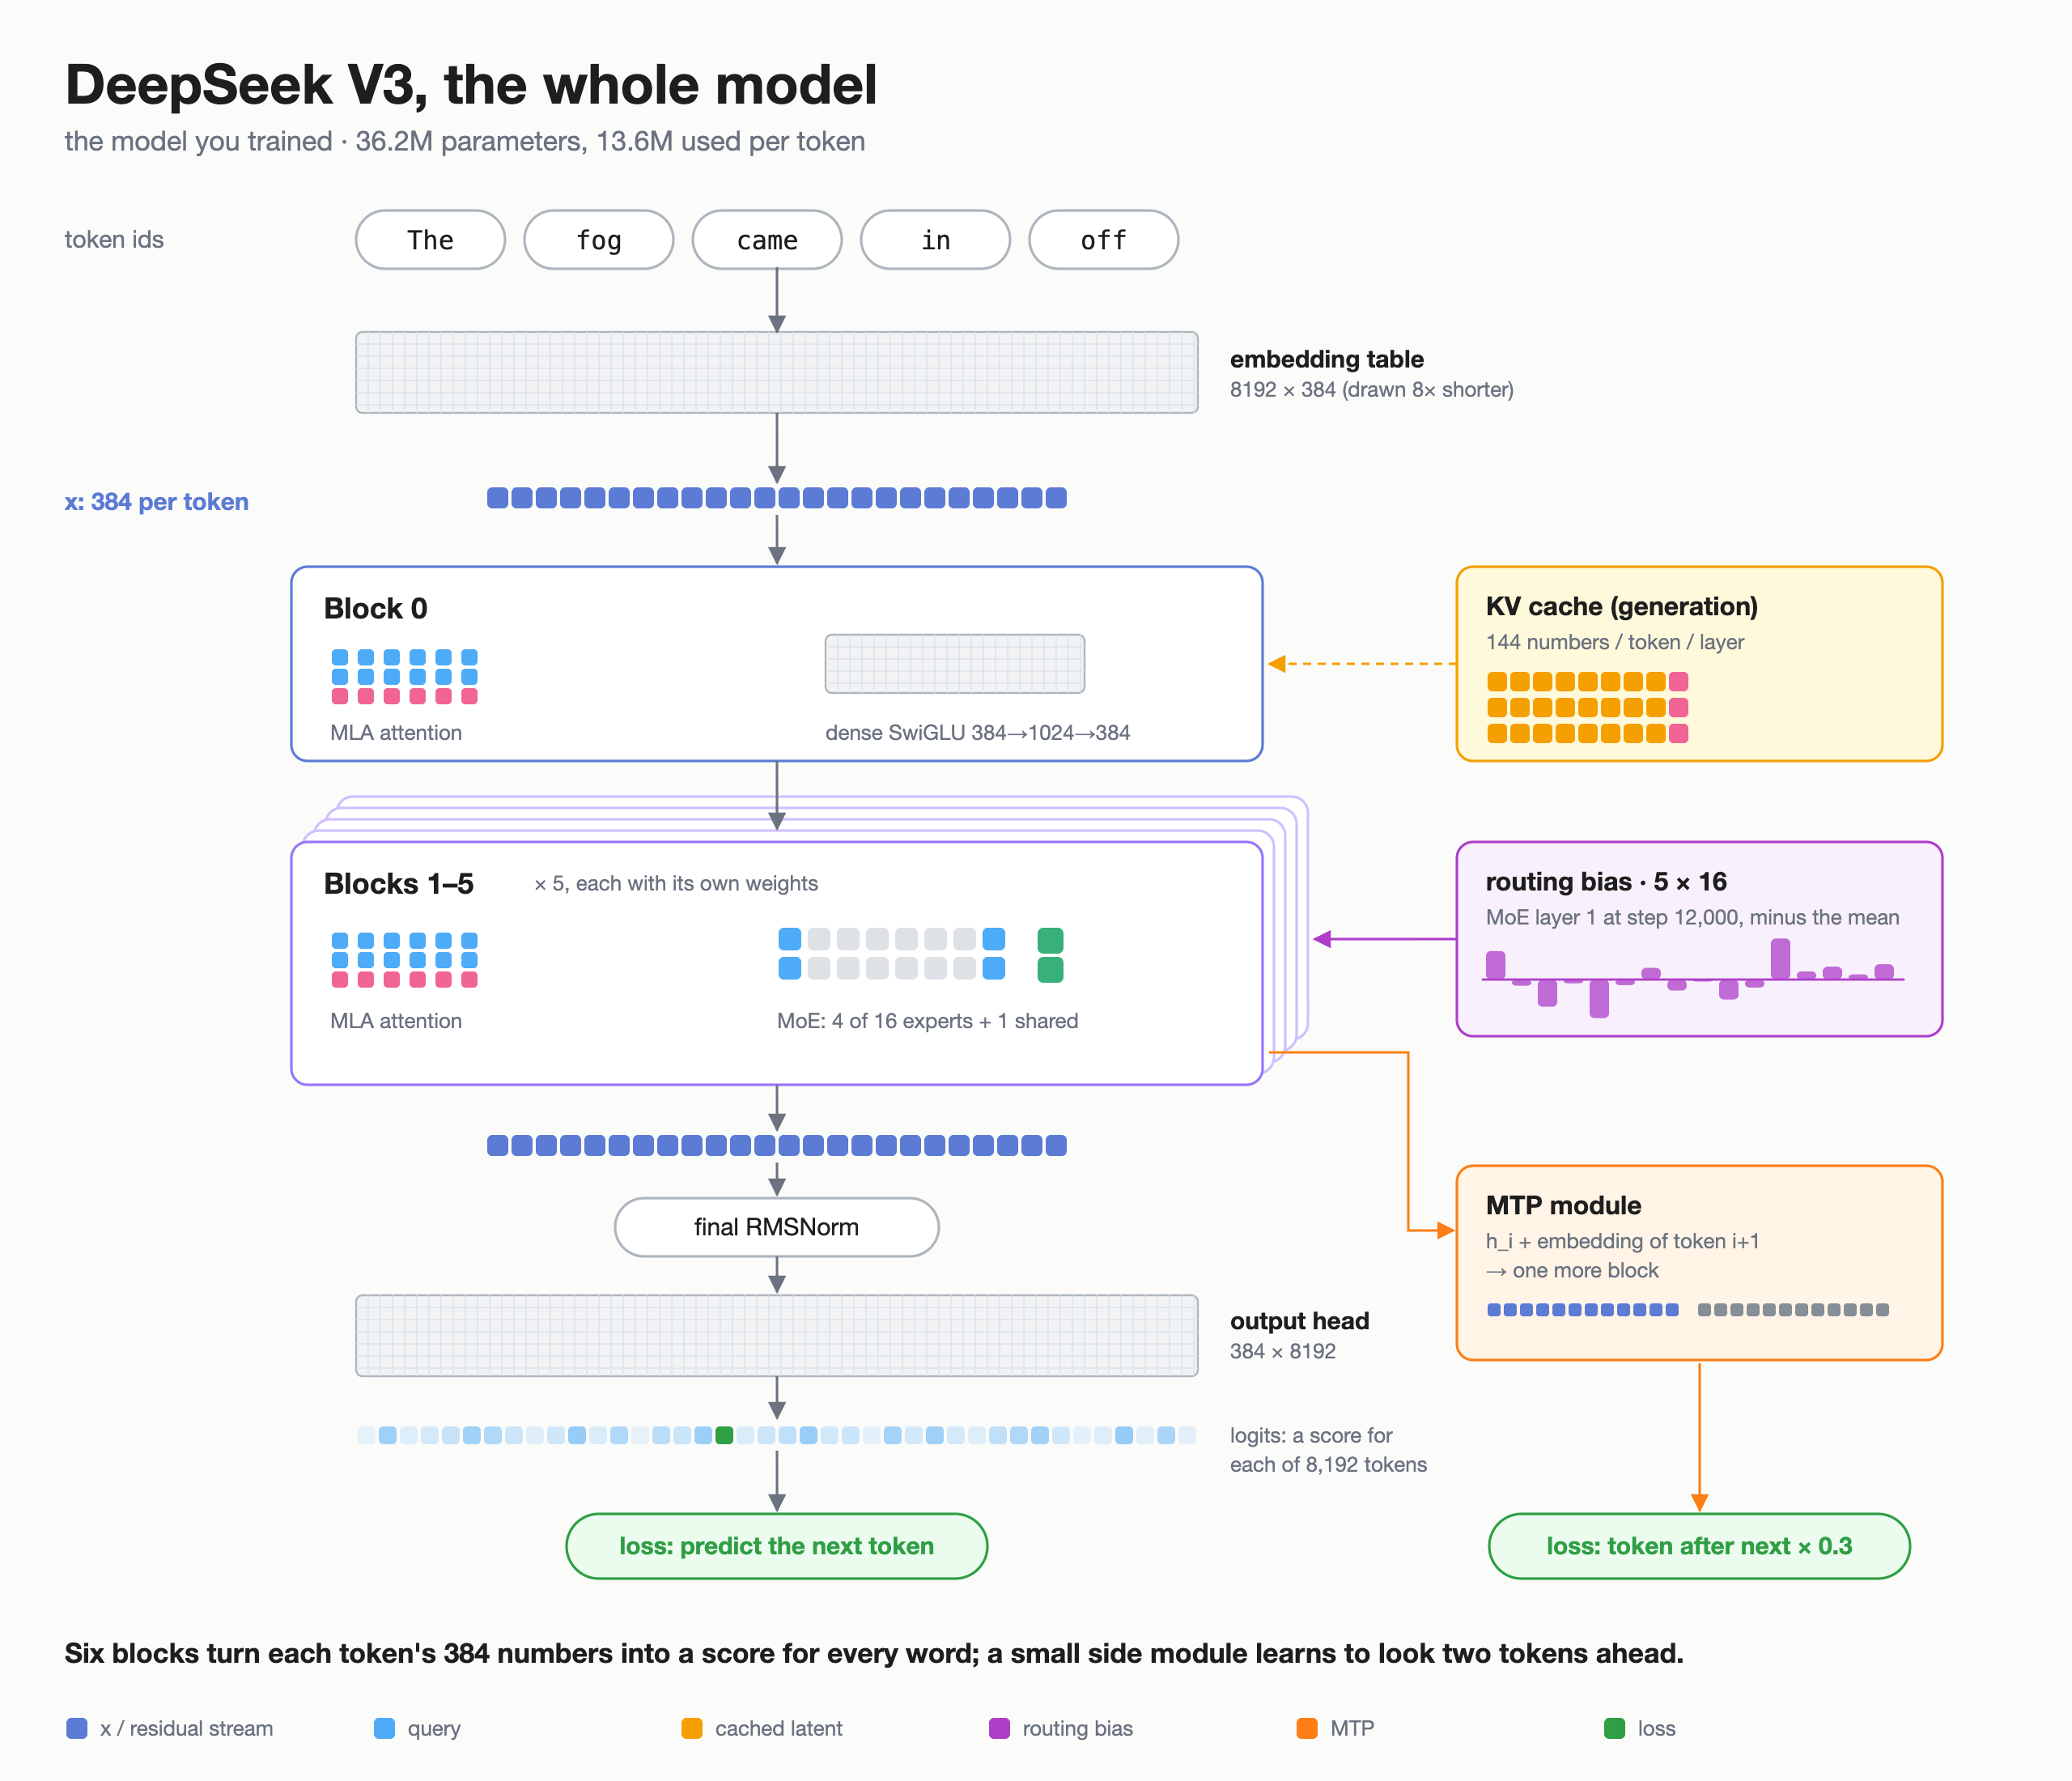
O arquivo deepseek_v3.py implementa a atenção latente multi-cabeça (MLA), que guarda um pequeno latente por token em vez das chaves e valores completos; o DeepSeekMoE, com um especialista compartilhado e 16 especialistas roteados, quatro por token; o balanceamento sem perda auxiliar, que usa um viés por especialista para distribuir o trabalho; a previsão de múltiplos tokens (MTP), que também prevê o token seguinte ao próximo; e o RoPE desacoplado. Os parâmetros são dicionários simples de arrays e cada parte do modelo é uma função.
Treinado em um MacBook Air
A corrida padrão usou um MacBook Air M5 com 24 GB de memória e durou cerca de 2,6 horas, com 12.000 passos de treinamento. O modelo tem 36,2 milhões de parâmetros, dos quais 13,6 milhões são ativados por token, e foi treinado com 207 livros de ficção policial em domínio público — incluindo obras de Dashiell Hammett — totalizando 21,7 milhões de tokens. A perda de validação caiu de 5,02 para 3,51.
O autor também testou o efeito do balanceamento: com o viés ativado, a carga dos especialistas ficou entre 5,7% e 6,9% cada; sem ele, variou de 0,09% a 18,6%. A perda de validação foi praticamente a mesma nos dois casos, o que confirma a afirmação do artigo original de que o viés equilibra os especialistas sem custar desempenho.
Reproduzível e com limites claros
O código tem licença MIT e o repositório traz o checkpoint exato da corrida publicada, os dados, 39 testes automatizados e instruções para rodar em CPU ou em GPU AMD com ROCm — em uma RX 7600 XT, a corrida completa leva cerca de 50 minutos. O próprio autor deixa claro que é uma demonstração de arquitetura, não um modelo de linguagem forte: são 36,2 milhões de parâmetros contra 671 bilhões do original, 6 camadas contra 61 e contexto de 256 tokens contra 128 mil. Também ficam de fora o treinamento FP8, o DualPipe e qualquer pós-treinamento.
O projeto DeepSeek V3 JAX se soma a outras iniciativas que aproximam os modelos da DeepSeek do hardware comum: o llama-modchip roda um DeepSeek de 284 bilhões de parâmetros em um PC com 64 GB de RAM e sem GPU.
No Hacker News, a publicação somou 262 pontos e 23 comentários até a tarde de 15 de novembro. Para quem estuda arquiteturas de modelos de linguagem, o projeto DeepSeek V3 JAX funciona como uma versão legível do DeepSeek V3 — um mapa compacto das ideias que fizeram o modelo original ficar conhecido.
Crédito da imagem: diagrama da arquitetura criado por Vaibhaav Tiwari, autor do projeto, disponível no repositório deepseek-v3-jax no GitHub (licença MIT).
Fontes
- GitHub — Vaibhaav Tiwari, deepseek-v3-jax (repositório oficial do projeto)
- Hacker News — Show HN: DeepSeek V3 in ~200 lines of pure Jax
- Vaibhaav Tiwari — DeepSeek V3 in 190 lines of pure JAX (artigo completo)
- DeepSeek-AI — DeepSeek-V3 Technical Report (arXiv, 2024)
Este artigo foi produzido com auxílio de inteligência artificial, com base em publicações públicas e em fontes da internet, e revisado editorialmente. Consulte as fontes originais para mais detalhes.
Por Muse