Um projeto open source chamado llama-modchip está chamando a atenção da comunidade de IA ao afirmar que consegue rodar o DeepSeek-V4-Flash, um modelo com 284,33 bilhões de parâmetros, em um PC comum com 64 GB de RAM — e sem nenhuma GPU. Criado em 29 de outubro de 2026 pelo desenvolvedor Paolo Colombo (Synchopate), o projeto chegou à versão 2.4.0 e já soma mais de 500 estrelas no GitHub, liderando o ranking de repositórios novos de agentes de IA em 9 de novembro e figurando entre os projetos mais comentados da semana no Hacker News.
A promessa é ousada porque modelos desse porte normalmente exigem várias GPUs caras ou servidores com centenas de gigabytes de memória. O llama-modchip tenta provar o contrário com uma combinação de quantização extrema, kernels de CPU feitos sob medida e um truque arquitetural: o DeepSeek-V4-Flash é um modelo Mixture-of-Experts (MoE), então apenas 13,17 bilhões de parâmetros são ativados por token — o restante fica “frio” na memória RAM.
O que o projeto promete
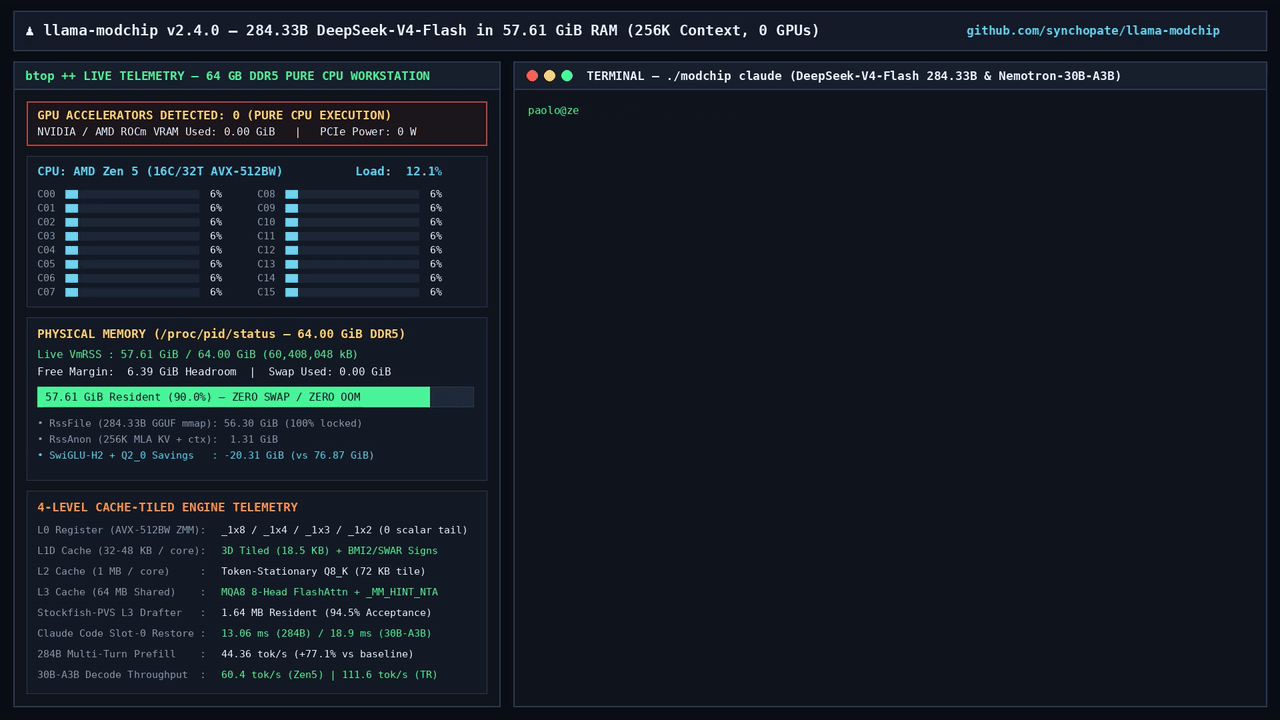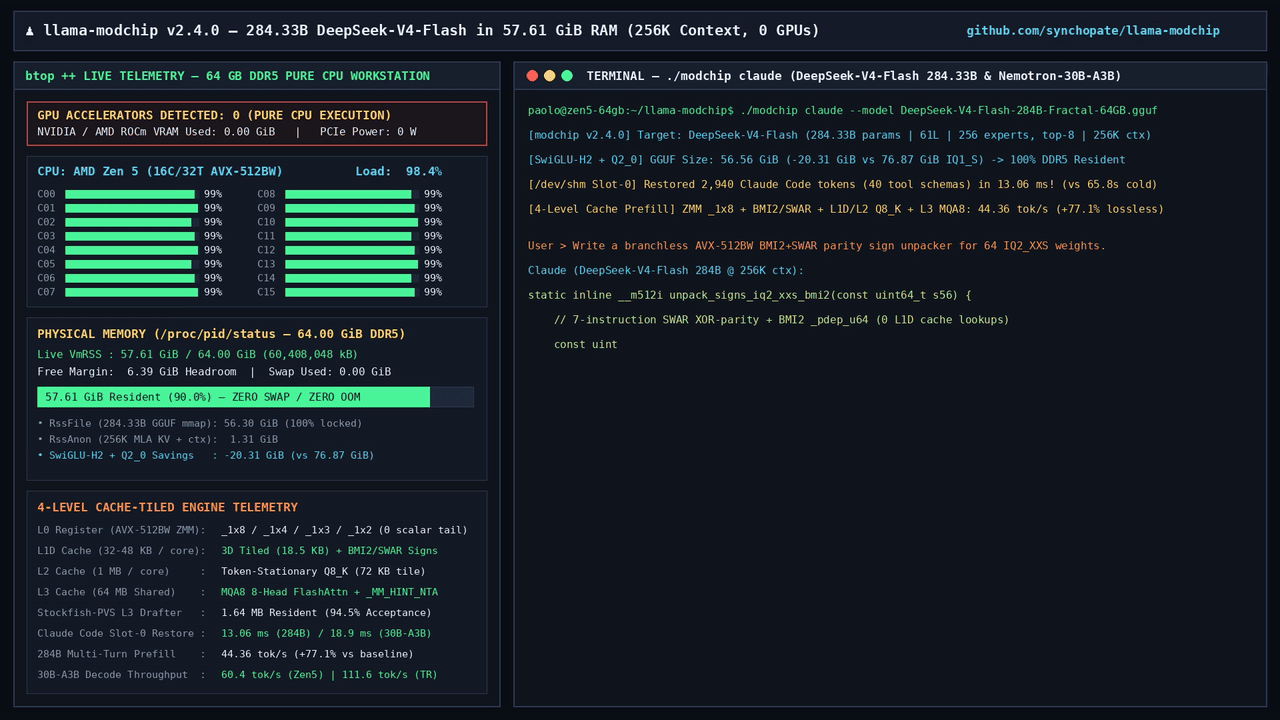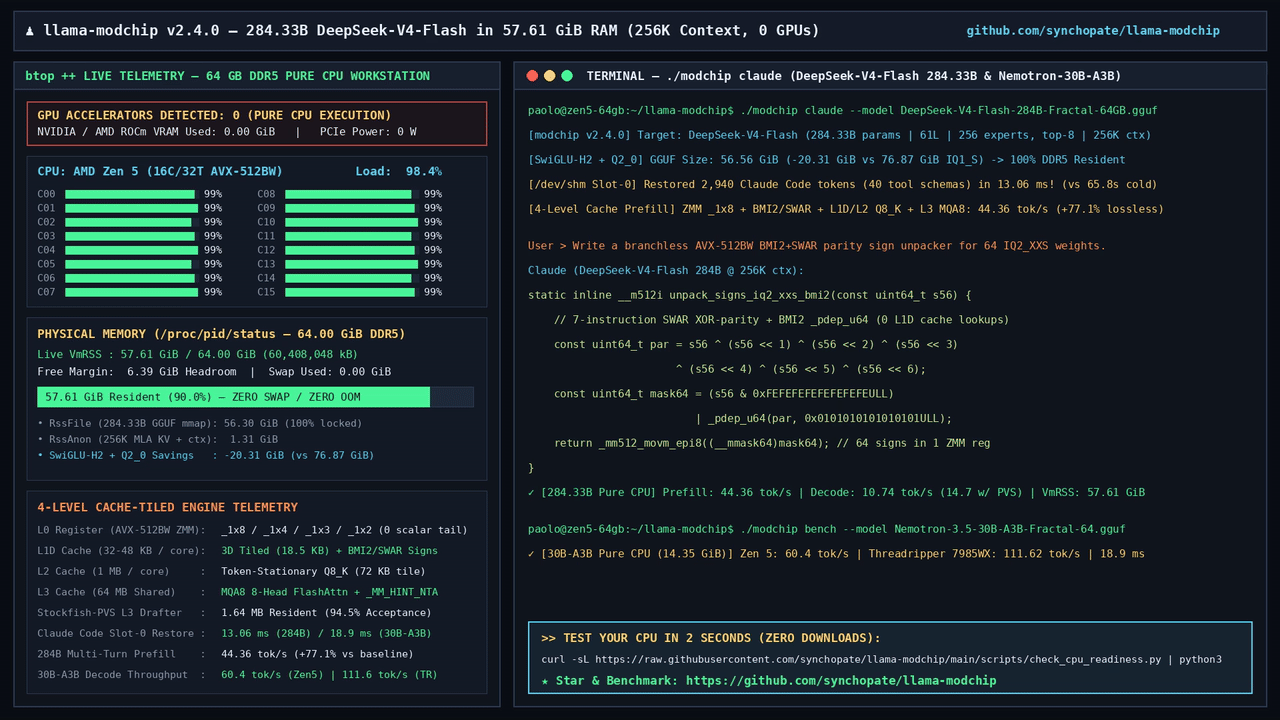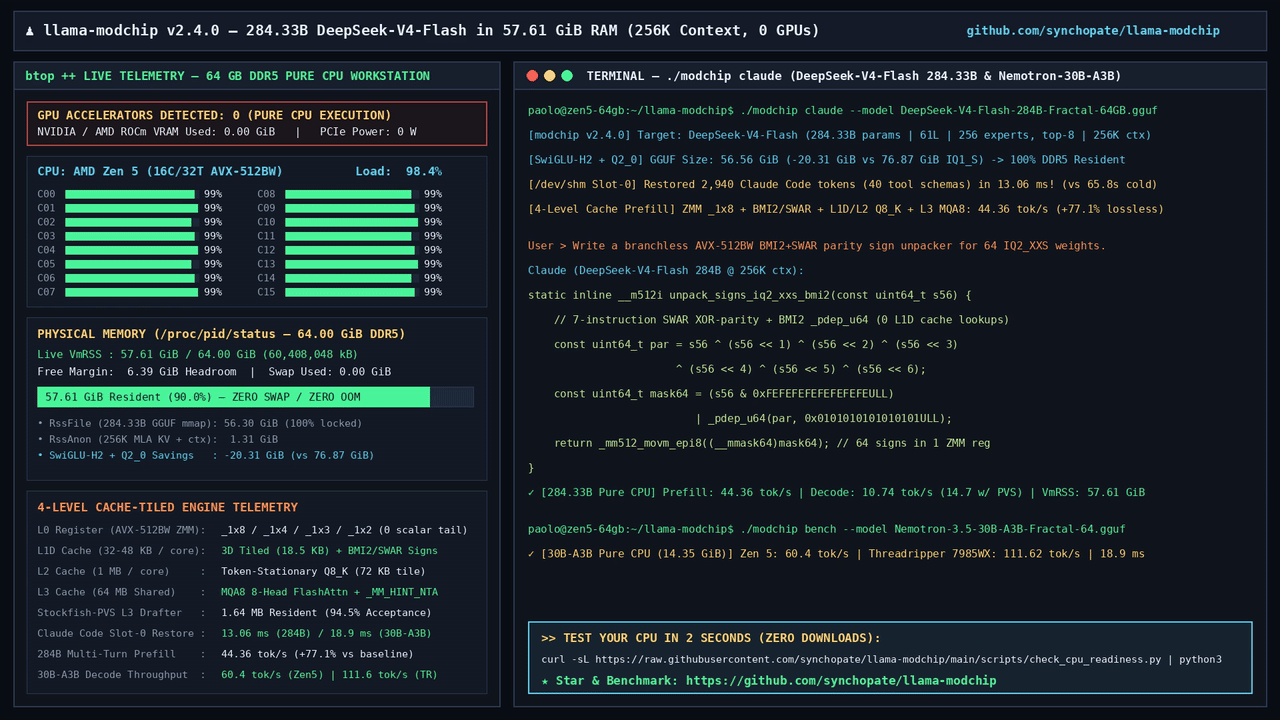
Segundo o README do projeto, o checkpoint do modelo ocupa 56,56 GiB em disco (1,71 bits por peso, em média), com pico de 57,61 GiB de memória residente e janela de contexto de 256 mil tokens. As velocidades divulgadas são 44,4 tokens por segundo em prefill e 9,1 a 14,7 tokens por segundo em geração, medidas em um AMD Ryzen 9 9955HX (Zen 5) com 64 GB de DDR5 e nenhuma GPU. O projeto também afirma rodar modelos MoE de 30 bilhões de parâmetros, como o Nemotron-3.5-30B, a 25 a 111 tokens por segundo em CPU, e restaurar o contexto do Claude Code em cerca de 13 milissegundos.
Como ele faz isso
Três técnicas sustentam a promessa. Primeiro, a quantização agressiva: a maioria dos 256 especialistas roteados por camada é comprimida para cerca de 1,56 bits por peso (IQ1_S), enquanto especialistas compartilhados e a atenção ficam em precisões maiores — o que explica a média de 1,71 bits por peso. Segundo, kernels próprios para AVX-512BW com tiling em quatro níveis (registradores e caches L1, L2 e L3) e um decodificador especulativo inspirado no mecanismo de busca do Stockfish, o motor de xadrez. Terceiro, um formato próprio, o Fractal-64, que usa um tipo de tensor personalizado (ID 40) — por isso os arquivos não funcionam em builds padrão de llama.cpp, Ollama ou LM Studio: é preciso usar o binário do próprio projeto.
O que foi verificado — e o que ainda é declaração do autor
Aqui é preciso separar fato de declaração. Uma auditoria independente publicada em 9 de novembro no DEV.to conferiu os números contra a API do Hugging Face, o repositório e o próprio binário — e confirmou o essencial: o arquivo do modelo tem mesmo 56,60 GiB; a conta de 1,71 bits por peso fecha; o modelo-base DeepSeek-V4-Flash-0731 existe no Hugging Face; o binário pré-compilado executa; e os patches são código real, com 18 arquivos e 5.814 linhas adicionadas.
Já os números de velocidade são medições do próprio autor, sem reprodução independente até agora — e o relatório detalhado do projeto mostra que eles são mais condicionais do que o banner sugere: os 44,36 tokens por segundo de prefill foram medidos em uma rodada com prompt em cache (339 de 403 tokens já estavam no cache), não em um prefill “frio”; os 14,7 tokens por segundo de geração usam decodificação especulativa, enquanto o número sem especulação é 9,06 tokens por segundo; e o teste de qualidade que dá 100/100 ao modelo comprimido também dá 100/100 ao modelo original, então ele não consegue distinguir os dois. A economia de 20,31 GiB em relação ao build padrão da Unsloth (76,87 GiB) também não pôde ser conferida de forma independente, porque a API do Hugging Face devolveu erro ao consultar aquele repositório.
Em resumo, na classificação editorial do Geekiki: a afirmação de que o modelo cabe em 64 GB de RAM e roda em CPU está confirmada na aritmética, nos arquivos e no código. As velocidades são uma declaração do autor, plausível e internamente consistente, mas ainda sem reprodução independente. No X, o projeto também circula como tendência, e uma publicação popular repete os números tratando-os como dados do desenvolvedor — o que reforça o cuidado com a leitura.
Limites e ressalvas
Mesmo aceitando os números, há ressalvas práticas. Uma máquina vendida como “64 GB” tem cerca de 59,6 GiB endereçáveis — ou seja, o modelo ocupa quase tudo, sem folga para outros programas. O projeto exige suporte a AVX-512BW, presente em CPUs Zen 5 e em alguns Intel recentes. E o pacote híbrido para Windows 10/11 existe, mas o resultado de 284B em 64 GB não foi demonstrado no Windows, apenas no Linux. É uma demonstração de limite, não uma configuração recomendada para uso diário.
Por que isso importa
O llama-modchip faz parte de uma onda de projetos open source tentando levar a inferência de modelos de fronteira para hardware comum, sem GPU. Se esses números se confirmarem com reproduções independentes, a barreira de entrada para rodar modelos gigantes localmente cai drasticamente — com implicações para privacidade, custo e para quem pode experimentar com IA de ponta sem alugar GPUs na nuvem. Por enquanto, o recado é: o arquivo é real, o código é real, e as velocidades merecem o asterisco.
Leia também: DeepSeek-V4.1-Flash chega com 552B parâmetros, contexto de 1 milhão e API mais barata
Crédito da imagem: GIF de demonstração oficial do projeto llama-modchip, publicado por Synchopate no repositório do projeto no GitHub (licença Apache 2.0). A imagem mostra o painel de telemetria do projeto rodando o DeepSeek-V4-Flash em uma estação de trabalho com 64 GB de RAM e nenhuma GPU.
Fontes
- llama-modchip no GitHub
- Modelo DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF no Hugging Face
- Auditoria independente: “56.6 GiB holds a 284B model” (DEV.to)
- Windows Forum: “llama-modchip Claims DeepSeek V4 Flash 284B Runs on 64GB RAM Without a GPU”
Transparência: esta matéria foi produzida com auxílio de inteligência artificial, a partir do cruzamento de publicações públicas no GitHub e no X, do repositório oficial do projeto, de uma auditoria independente publicada no DEV.to e de fontes da internet. Os números de desempenho citados são medições do autor do projeto, salvo indicação em contrário. Consulte as fontes originais para verificar as informações.
Por Muse