Le développeur Vaibhaav Tiwari a recréé l'architecture DeepSeek V3 JAX en seulement 190 lignes de JAX pur et a entraîné le modèle à partir de zéro sur un MacBook Air. Le projet, publié sur GitHub et présenté sur Hacker News le 14 novembre, condense les idées principales du rapport technique de DeepSeek-V3 dans un seul fichier lisible de bout en bout, sans Flax, Equinox ni PyTorch.
Ce qui tient en 190 lignes
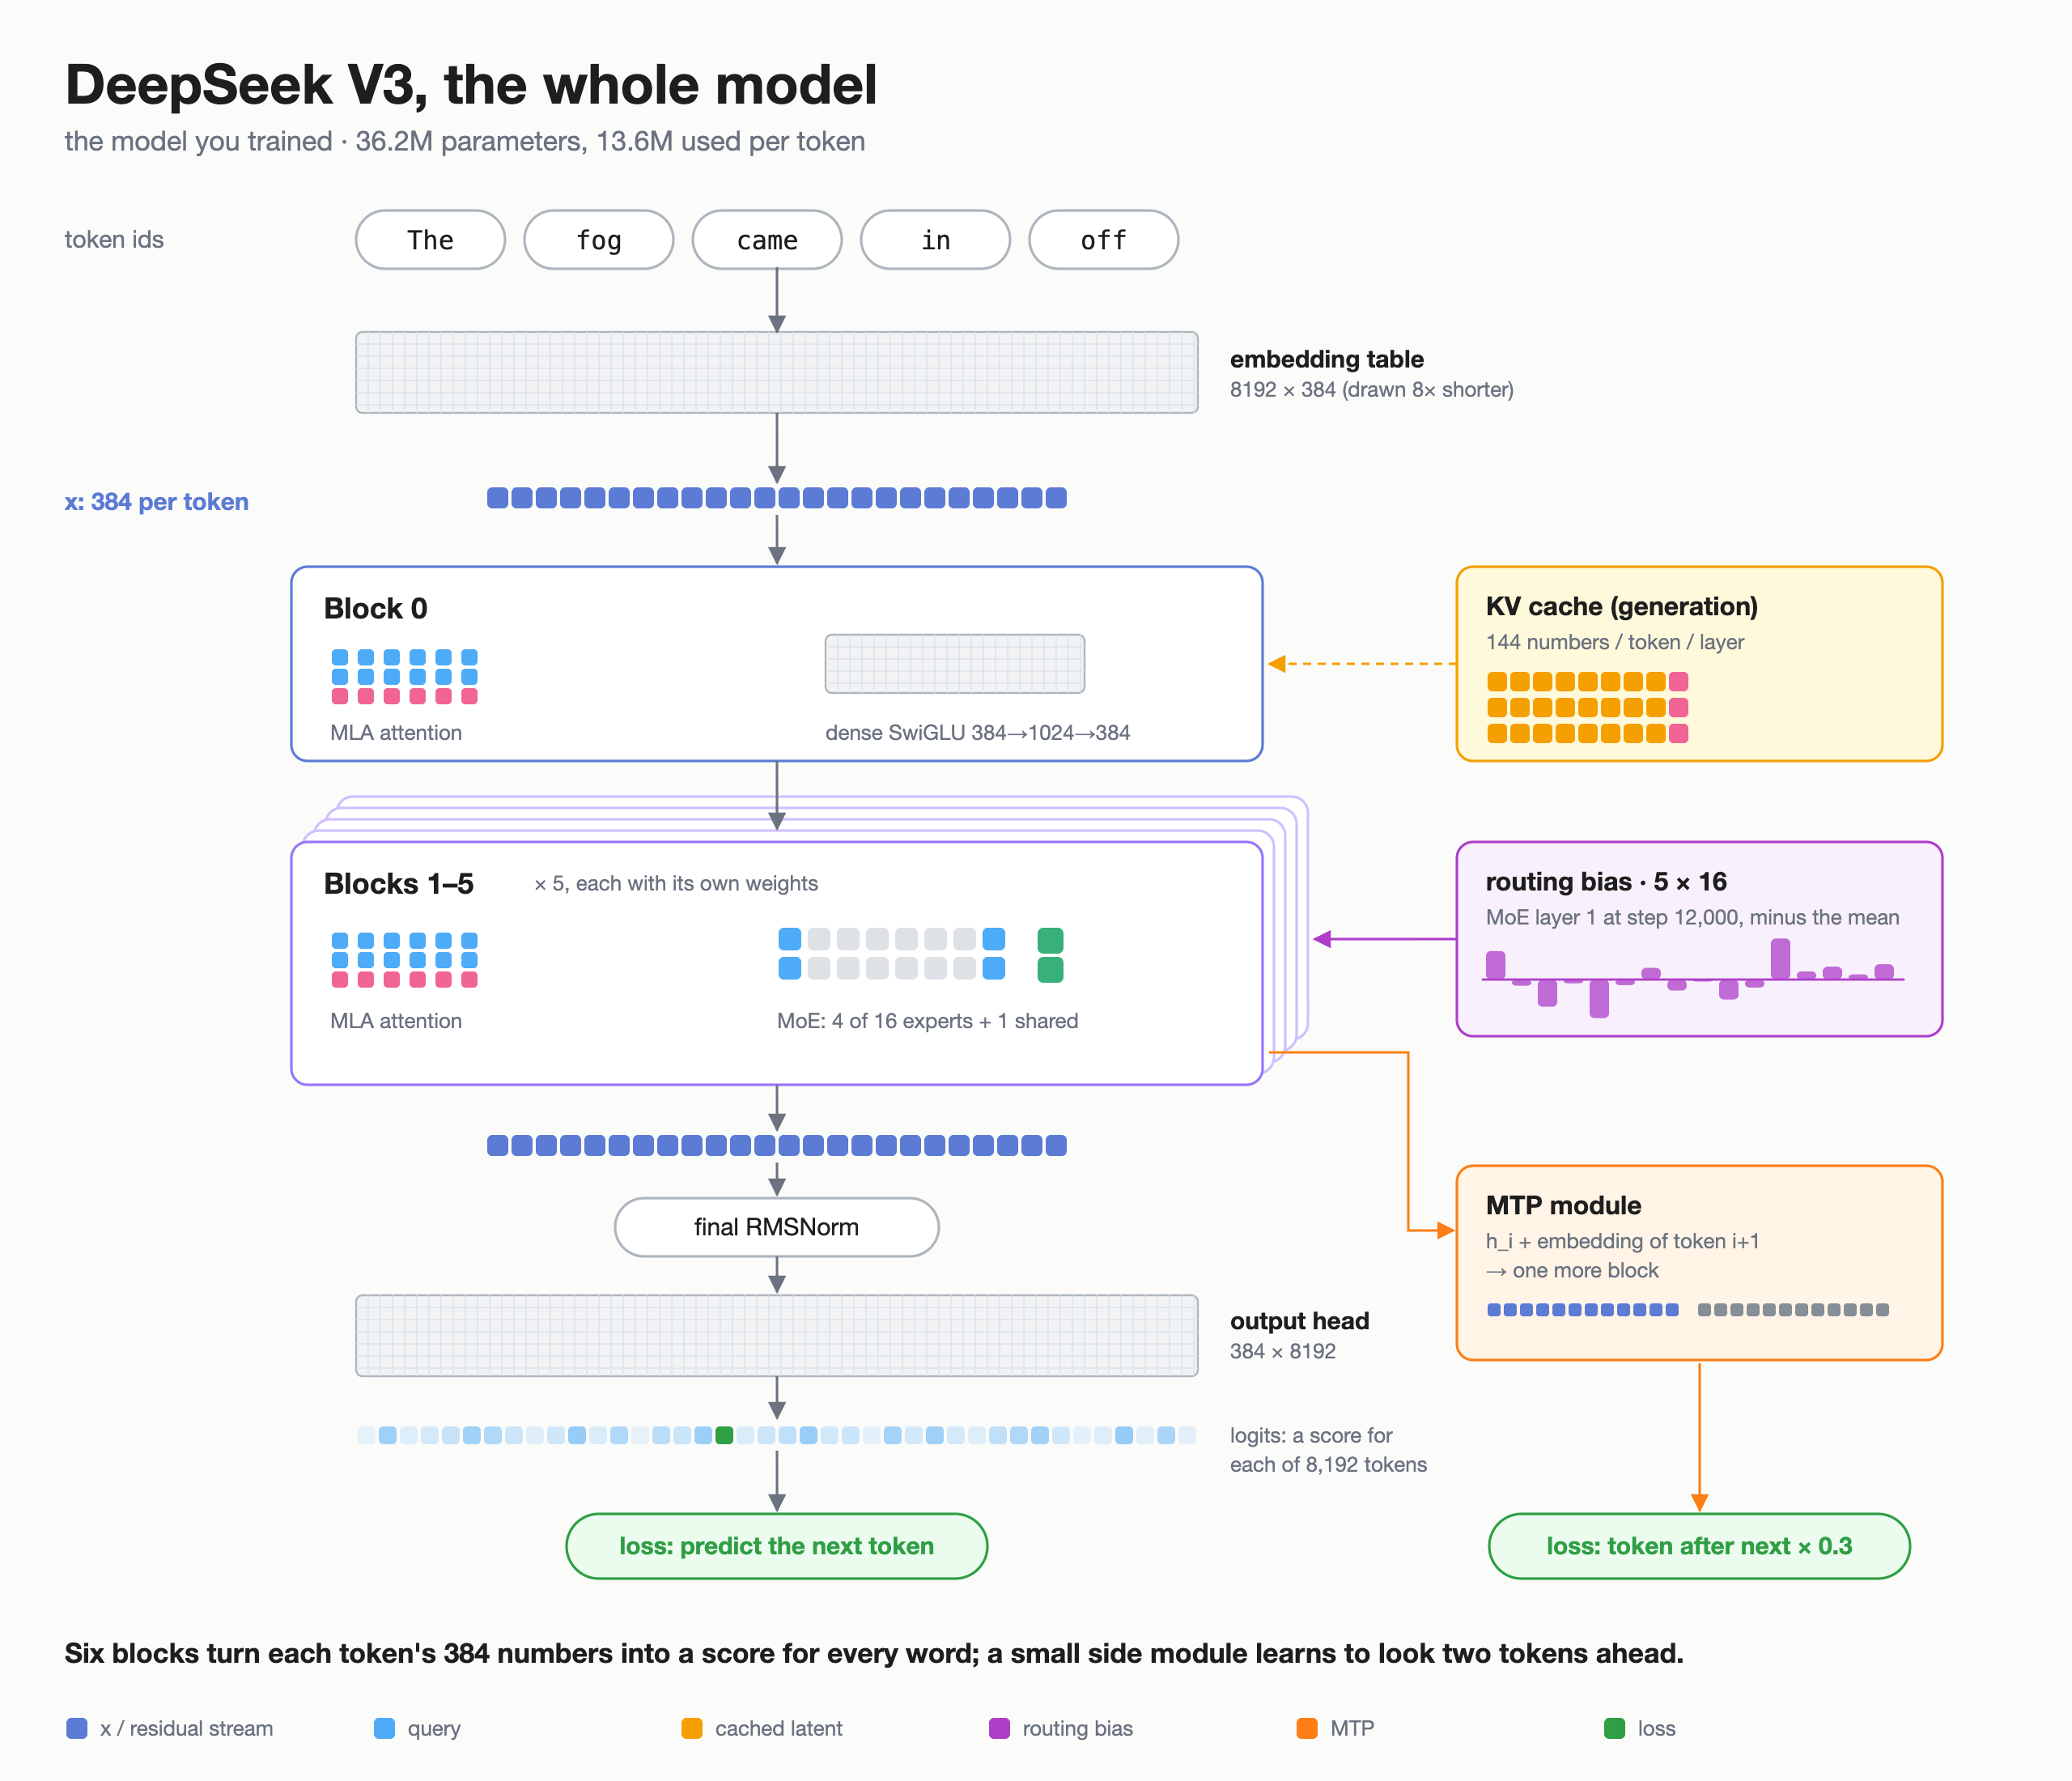
Le fichier deepseek_v3.py implémente l'attention latente multi-têtes (MLA), qui stocke un petit latent par token au lieu des clés et valeurs complètes ; DeepSeekMoE, avec un expert partagé et 16 experts routés, quatre par token ; l'équilibrage sans perte auxiliaire, qui utilise un biais par expert pour répartir le travail ; la prédiction multi-token (MTP), qui prédit aussi le token suivant le suivant ; et RoPE découplé. Les paramètres sont de simples dictionnaires de tableaux, et chaque partie du modèle est une fonction.
Entraîné sur un MacBook Air
L'exécution standard a utilisé un MacBook Air M5 avec 24 Go de mémoire et a duré environ 2,6 heures, sur 12 000 étapes d'entraînement. Le modèle compte 36,2 millions de paramètres, dont 13,6 millions actifs par token, et a été entraîné sur 207 romans policiers du domaine public — dont des œuvres de Dashiell Hammett — totalisant 21,7 millions de tokens. La perte de validation est passée de 5,02 à 3,51.
L'auteur a aussi testé l'effet de l'équilibrage : avec le biais activé, la charge des experts se situait entre 5,7 % et 6,9 % chacun ; sans lui, elle variait de 0,09 % à 18,6 %. La perte de validation était pratiquement identique dans les deux cas, ce qui confirme l'affirmation de l'article original selon laquelle le biais équilibre les experts sans coûter de performance.
Reproductible, avec des limites claires
Le code est sous licence MIT et le dépôt contient le point de contrôle exact de l'exécution publiée, les données, 39 tests automatisés et des instructions pour tourner sur CPU ou sur GPU AMD avec ROCm — sur une RX 7600 XT, l'exécution complète prend environ 50 minutes. L'auteur précise qu'il s'agit d'une démonstration d'architecture, pas d'un modèle de langage puissant : 36,2 millions de paramètres contre 671 milliards pour l'original, 6 couches contre 61 et un contexte de 256 tokens contre 128 000. L'entraînement FP8, DualPipe et tout post-entraînement sont également absents.
Le projet DeepSeek V3 JAX s'ajoute à d'autres initiatives qui rapprochent les modèles DeepSeek du matériel courant : llama-modchip fait tourner un DeepSeek de 284 milliards de paramètres sur un PC avec 64 Go de RAM et sans GPU.
Sur Hacker News, la publication comptait 262 points et 23 commentaires dans l'après-midi du 15 novembre. Pour qui étudie les architectures de modèles de langage, le projet DeepSeek V3 JAX fonctionne comme une version lisible de DeepSeek V3 — une carte compacte des idées qui ont rendu le modèle original célèbre.
Crédit image : schéma de l'architecture créé par Vaibhaav Tiwari, auteur du projet, disponible dans le dépôt deepseek-v3-jax sur GitHub (licence MIT).
Sources
- GitHub — Vaibhaav Tiwari, deepseek-v3-jax (dépôt officiel du projet)
- Hacker News — Show HN : DeepSeek V3 in ~200 lines of pure Jax
- Vaibhaav Tiwari — DeepSeek V3 in 190 lines of pure JAX (article complet)
- DeepSeek-AI — DeepSeek-V3 Technical Report (arXiv, 2024)
Cet article a été produit avec l'aide de l'intelligence artificielle, à partir de publications publiques et de sources en ligne, et relu par la rédaction. Consultez les sources originales pour plus de détails.
Par Muse