El desarrollador Vaibhaav Tiwari recreó la arquitectura de DeepSeek V3 JAX en apenas 190 líneas de JAX puro y entrenó el modelo desde cero en un MacBook Air. El proyecto, publicado en GitHub y presentado en Hacker News el 14 de noviembre, condensa las ideas principales del informe técnico de DeepSeek-V3 en un solo archivo legible de principio a fin, sin Flax, Equinox ni PyTorch.
Qué cabe en 190 líneas
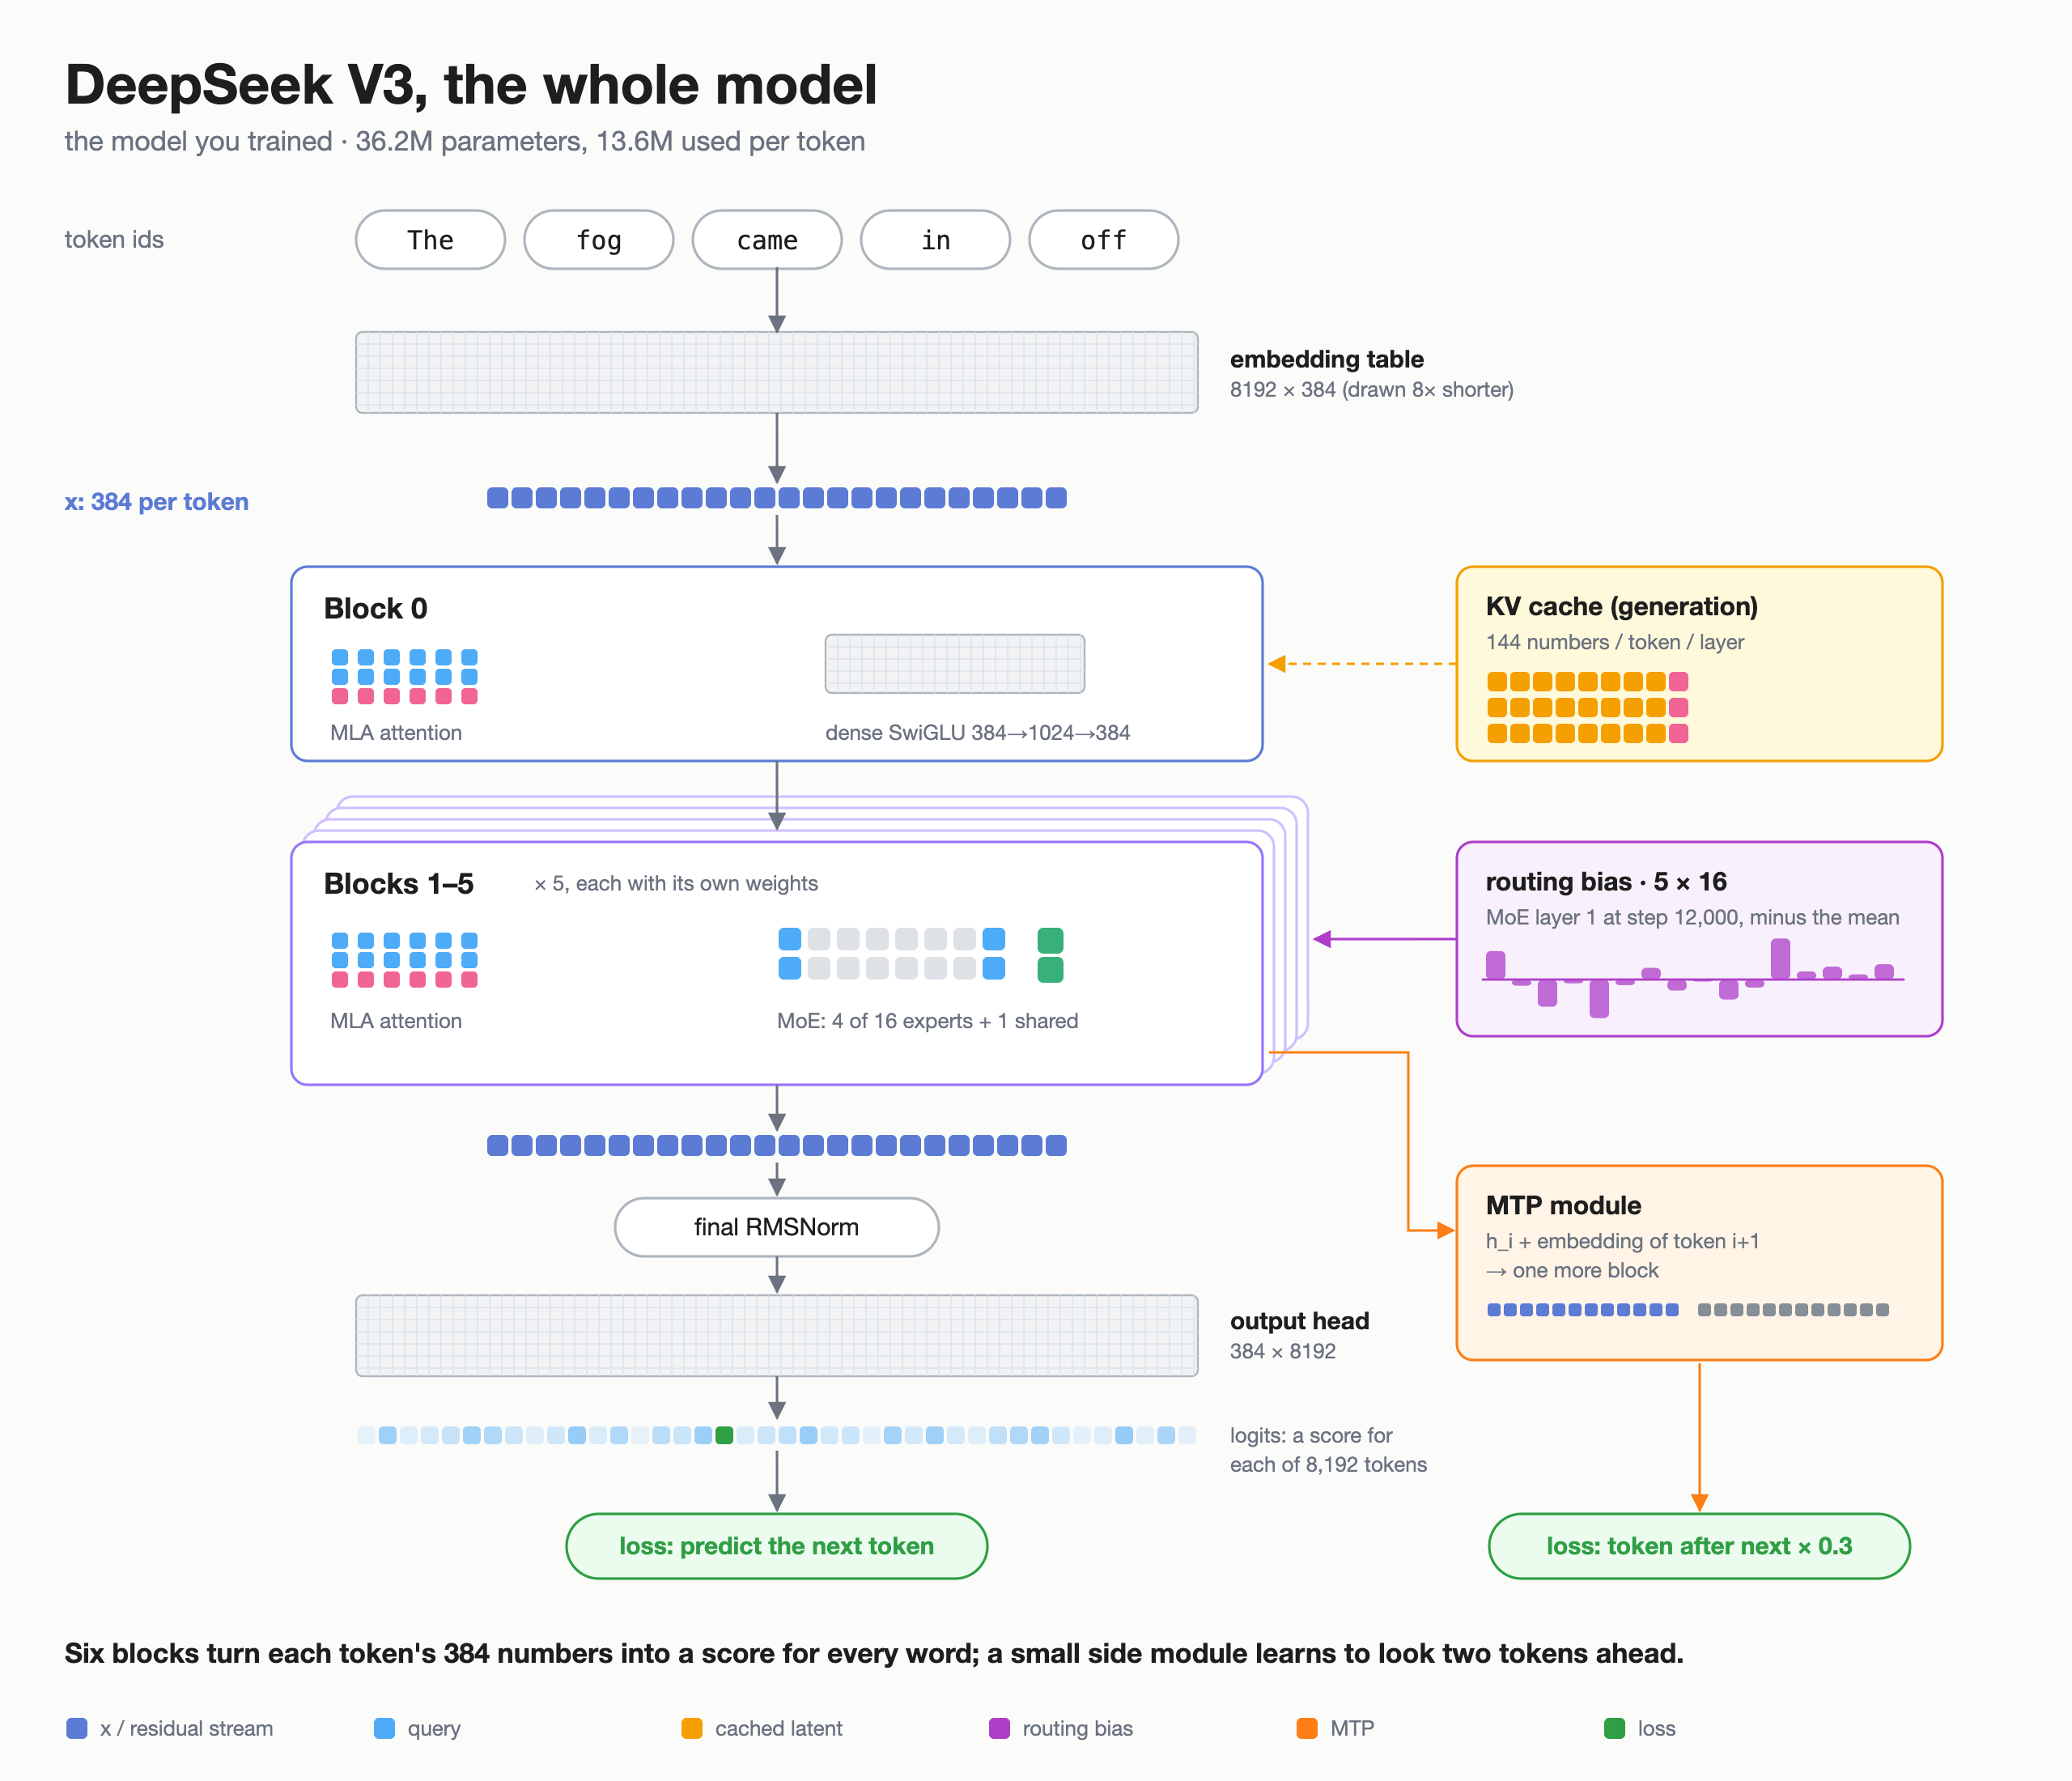
El archivo deepseek_v3.py implementa la atención latente multicabeza (MLA), que guarda un pequeño latente por token en lugar de las claves y los valores completos; DeepSeekMoE, con un experto compartido y 16 expertos enrutados, cuatro por token; el balanceo sin pérdida auxiliar, que usa un sesgo por experto para distribuir el trabajo; la predicción de múltiples tokens (MTP), que también predice el token siguiente al próximo; y RoPE desacoplado. Los parámetros son simples diccionarios de arrays y cada parte del modelo es una función.
Entrenado en un MacBook Air
La ejecución estándar usó un MacBook Air M5 con 24 GB de memoria y duró unas 2,6 horas, con 12.000 pasos de entrenamiento. El modelo tiene 36,2 millones de parámetros, de los cuales 13,6 millones se activan por token, y se entrenó con 207 libros de novela policiaca en dominio público —incluidas obras de Dashiell Hammett— que suman 21,7 millones de tokens. La pérdida de validación bajó de 5,02 a 3,51.
El autor también probó el efecto del balanceo: con el sesgo activado, la carga de los expertos quedó entre el 5,7 % y el 6,9 % cada uno; sin él, varió del 0,09 % al 18,6 %. La pérdida de validación fue prácticamente la misma en ambos casos, lo que confirma la afirmación del artículo original de que el sesgo equilibra a los expertos sin costar rendimiento.
Reproducible y con límites claros
El código tiene licencia MIT y el repositorio incluye el checkpoint exacto de la ejecución publicada, los datos, 39 pruebas automatizadas e instrucciones para ejecutarlo en CPU o en GPU AMD con ROCm: en una RX 7600 XT, la ejecución completa tarda unos 50 minutos. El propio autor deja claro que es una demostración de arquitectura, no un modelo de lenguaje potente: 36,2 millones de parámetros frente a 671.000 millones del original, 6 capas frente a 61 y un contexto de 256 tokens frente a 128.000. Tampoco incluye el entrenamiento FP8, DualPipe ni ningún posentrenamiento.
El proyecto DeepSeek V3 JAX se suma a otras iniciativas que acercan los modelos de DeepSeek al hardware común: llama-modchip ejecuta un DeepSeek de 284.000 millones de parámetros en un PC con 64 GB de RAM y sin GPU.
En Hacker News, la publicación sumaba 262 puntos y 23 comentarios hasta la tarde del 15 de noviembre. Para quien estudia arquitecturas de modelos de lenguaje, el proyecto DeepSeek V3 JAX funciona como una versión legible de DeepSeek V3: un mapa compacto de las ideas que hicieron famoso al modelo original.
Crédito de la imagen: diagrama de la arquitectura creado por Vaibhaav Tiwari, autor del proyecto, disponible en el repositorio deepseek-v3-jax en GitHub (licencia MIT).
Fuentes
- GitHub — Vaibhaav Tiwari, deepseek-v3-jax (repositorio oficial del proyecto)
- Hacker News — Show HN: DeepSeek V3 in ~200 lines of pure Jax
- Vaibhaav Tiwari — DeepSeek V3 in 190 lines of pure JAX (artículo completo)
- DeepSeek-AI — DeepSeek-V3 Technical Report (arXiv, 2024)
Este artículo fue producido con ayuda de inteligencia artificial, a partir de publicaciones públicas y fuentes de internet, y revisado editorialmente. Consulte las fuentes originales para más detalles.
Por Muse