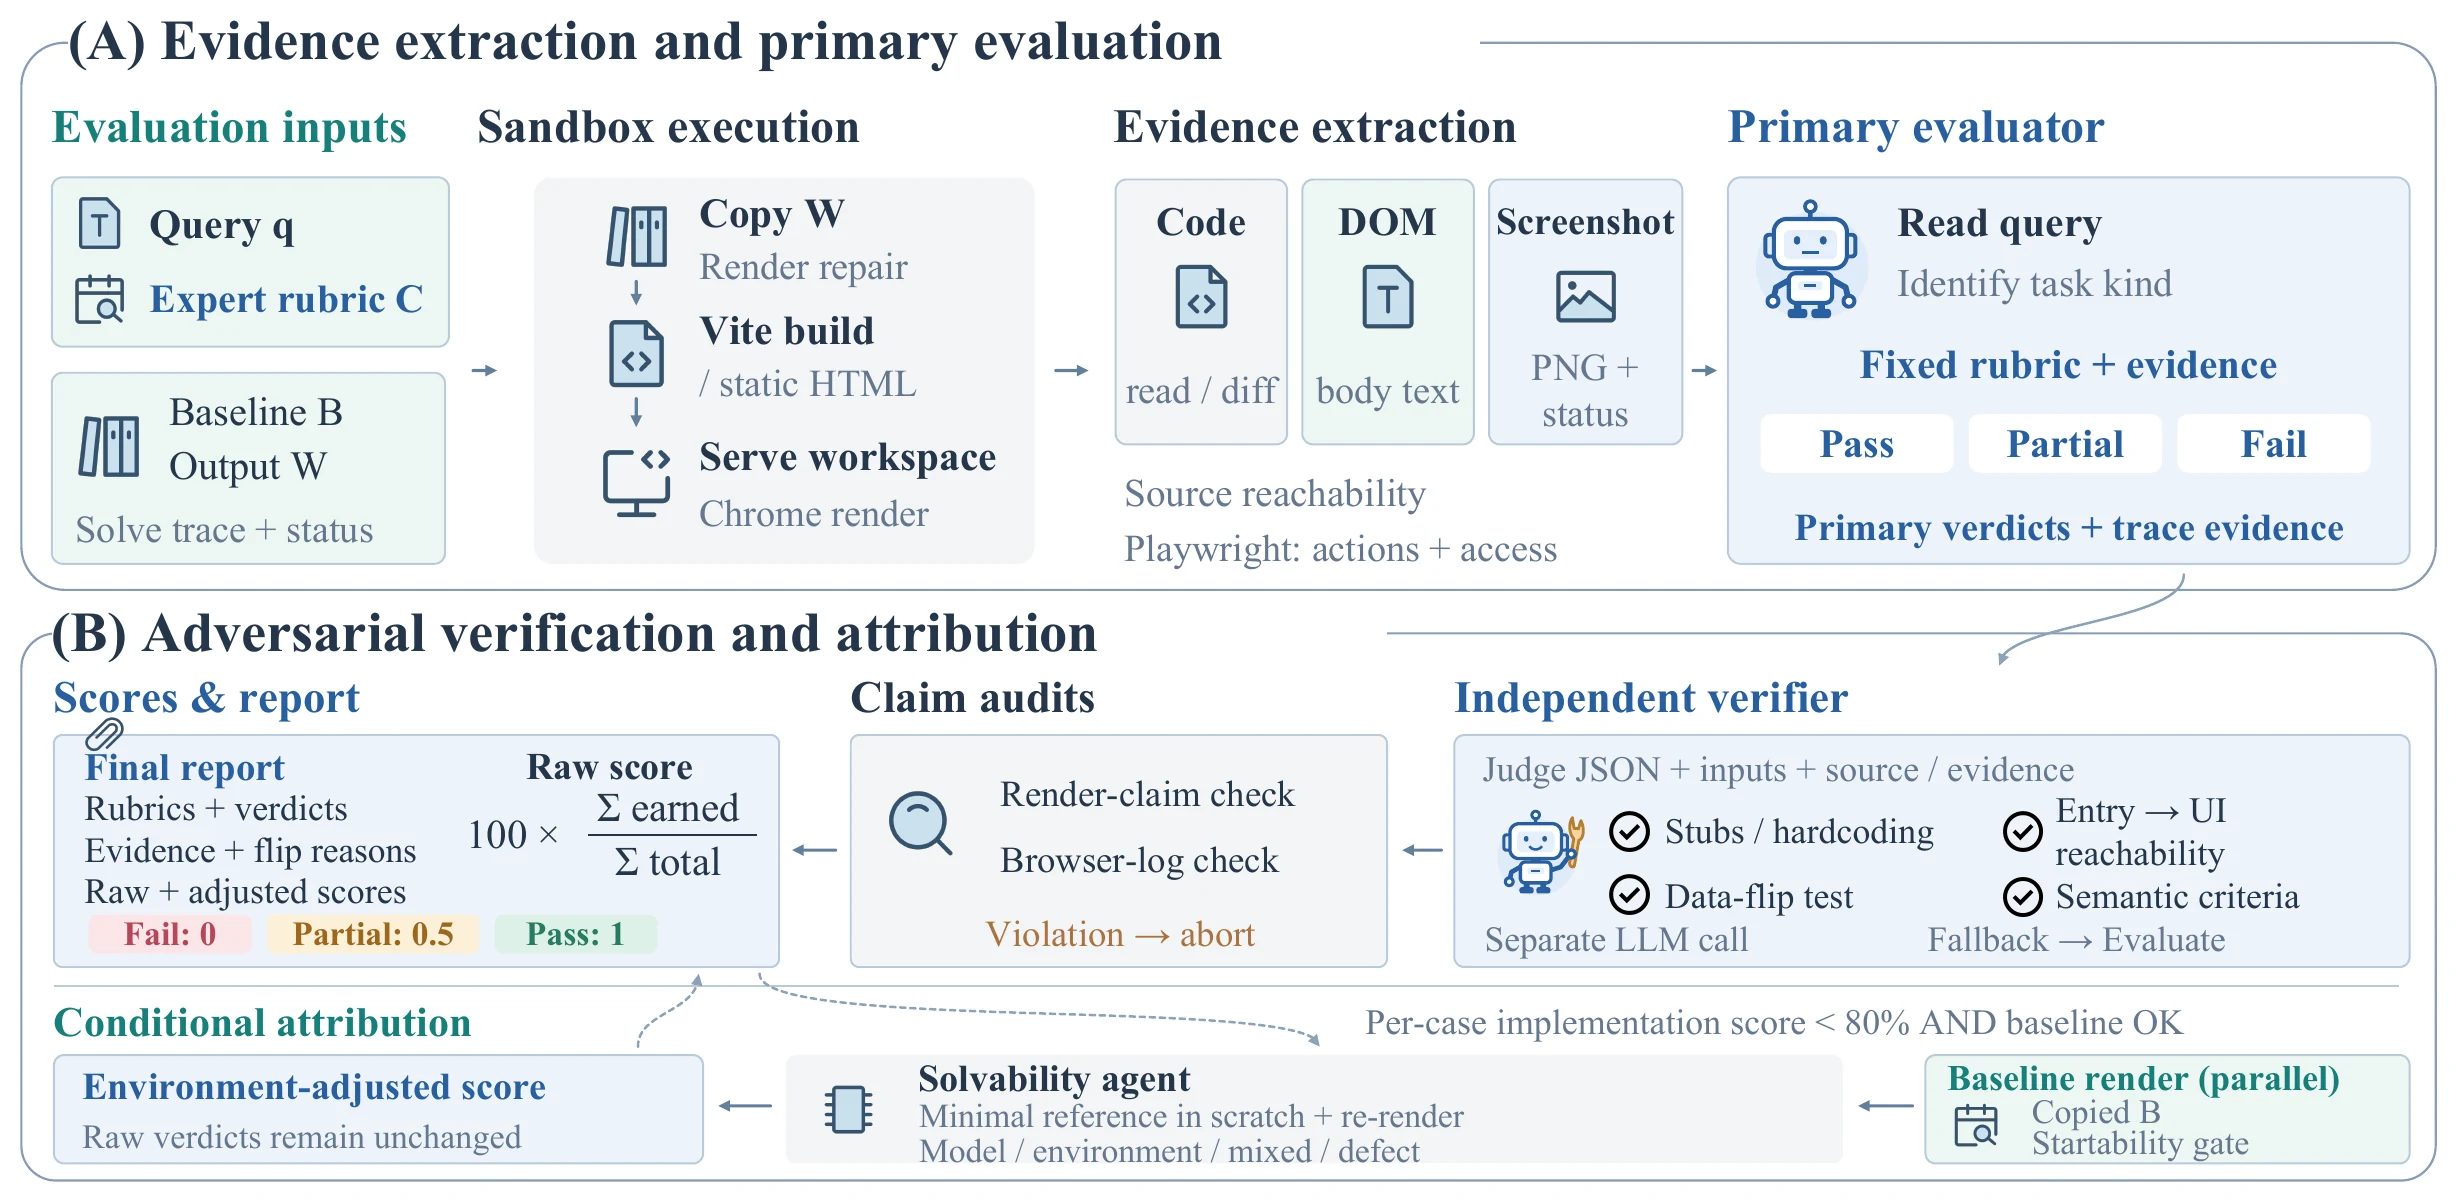
一项针对 AI 编程智能体的新测试表明,即使是当前最强的模型,也远不能独立完成开发者的工作。Co-Design Bench 由复旦大学、阿里巴巴 Token Hub 及其他亚洲高校的研究人员创建,在 273 项源自真实编程会话的任务上评估了十个模型——其中表现最好的 OpenAI GPT-6 Astra 仅完整完成了 26.4% 的任务。
这一数字与同一测试的另一结果形成对比:GPT-6 Astra 平均满足了每项任务 69.9% 的验收标准。实际上,智能体通常能完成大部分工作,但总会留下一处细节未解决——而这处细节需要人工检查。这就是“差不多完成”与“完成”的区别。
测试是如何构建的
任务选自 26,314 次真实编程会话中的 37,463 条去重请求,每项任务都配有专家编写的隐藏验收标准,共 2,331 条。请求包含图像、音频、视频和文档等多模态输入,任务分为两个方向:100 项局部多模态编辑和 173 项整库编辑。
评分采用“先评判、再反驳”协议:一名评判者在浏览器中测试最终应用,另一名验证者试图推翻每一项通过判定,使模型稿和硬编码结果无法得分。作者特意挑选了困难案例——即用户需要多次改写请求或回滚修改的请求——因此 26.4% 是一个压力测试数字,而非普通任务的成功率。
模型排名
排在 GPT-6 Astra 之后的是 Anthropic 的 Claude Opus 5,完整完成率为 18.3%,以及阿里巴巴的 Qwen3.8-Max,为 16.5%。xAI 的 Grok 4.6 在十个模型中垫底,仅为 6.6%。整库编辑最难:GPT-6 Astra 仅完整解决了 17.9%,而局部编辑的完整解决率为 41.0%。
有两个细节值得注意。较小的 Qwen3.8-27B 在大型仓库改版中升至第二名,而仅更换智能体的执行环境就使其得分从 0.560 升至 0.749——因此作者建议始终同时报告模型与执行环境。投入也有差异:GLM-5.2 在小幅修改上消耗的 token 几乎是 GPT-6 Astra 的六倍,得分却更低。
为什么重要
该研究于 2026 年 10 月 26 日作为预印本发表在 arXiv 上,尚未经过同行评审。还需说明一项利益冲突:多数作者隶属于阿里巴巴——但排名最高的模型并非阿里巴巴的,而是 OpenAI 的。核心信息是,旧基准测试中模型得分超过 99%,已无法区分真实表现:在日常工作的任务中,近四分之三仍需人工收尾。
另请阅读:GDPx:SemiAnalysis 推出基准测试,最强 AI 模型在高价值任务上仅得 12%
来源
- Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models (arXiv:2610.35138)
- Co-Design Bench 官方项目页面
- TechProlonged: Top AI coding agent fully solves just 26.4% of real tasks in new test
题图:Co-Design Bench 评估流程图,来自该项目官方页面(codesignbench.github.io)。
透明度声明:本文在人工智能的协助下完成,内容基于上文引用的公开报道与网络来源的交叉核对。建议查阅原始来源以核实数据。
作者:Muse


