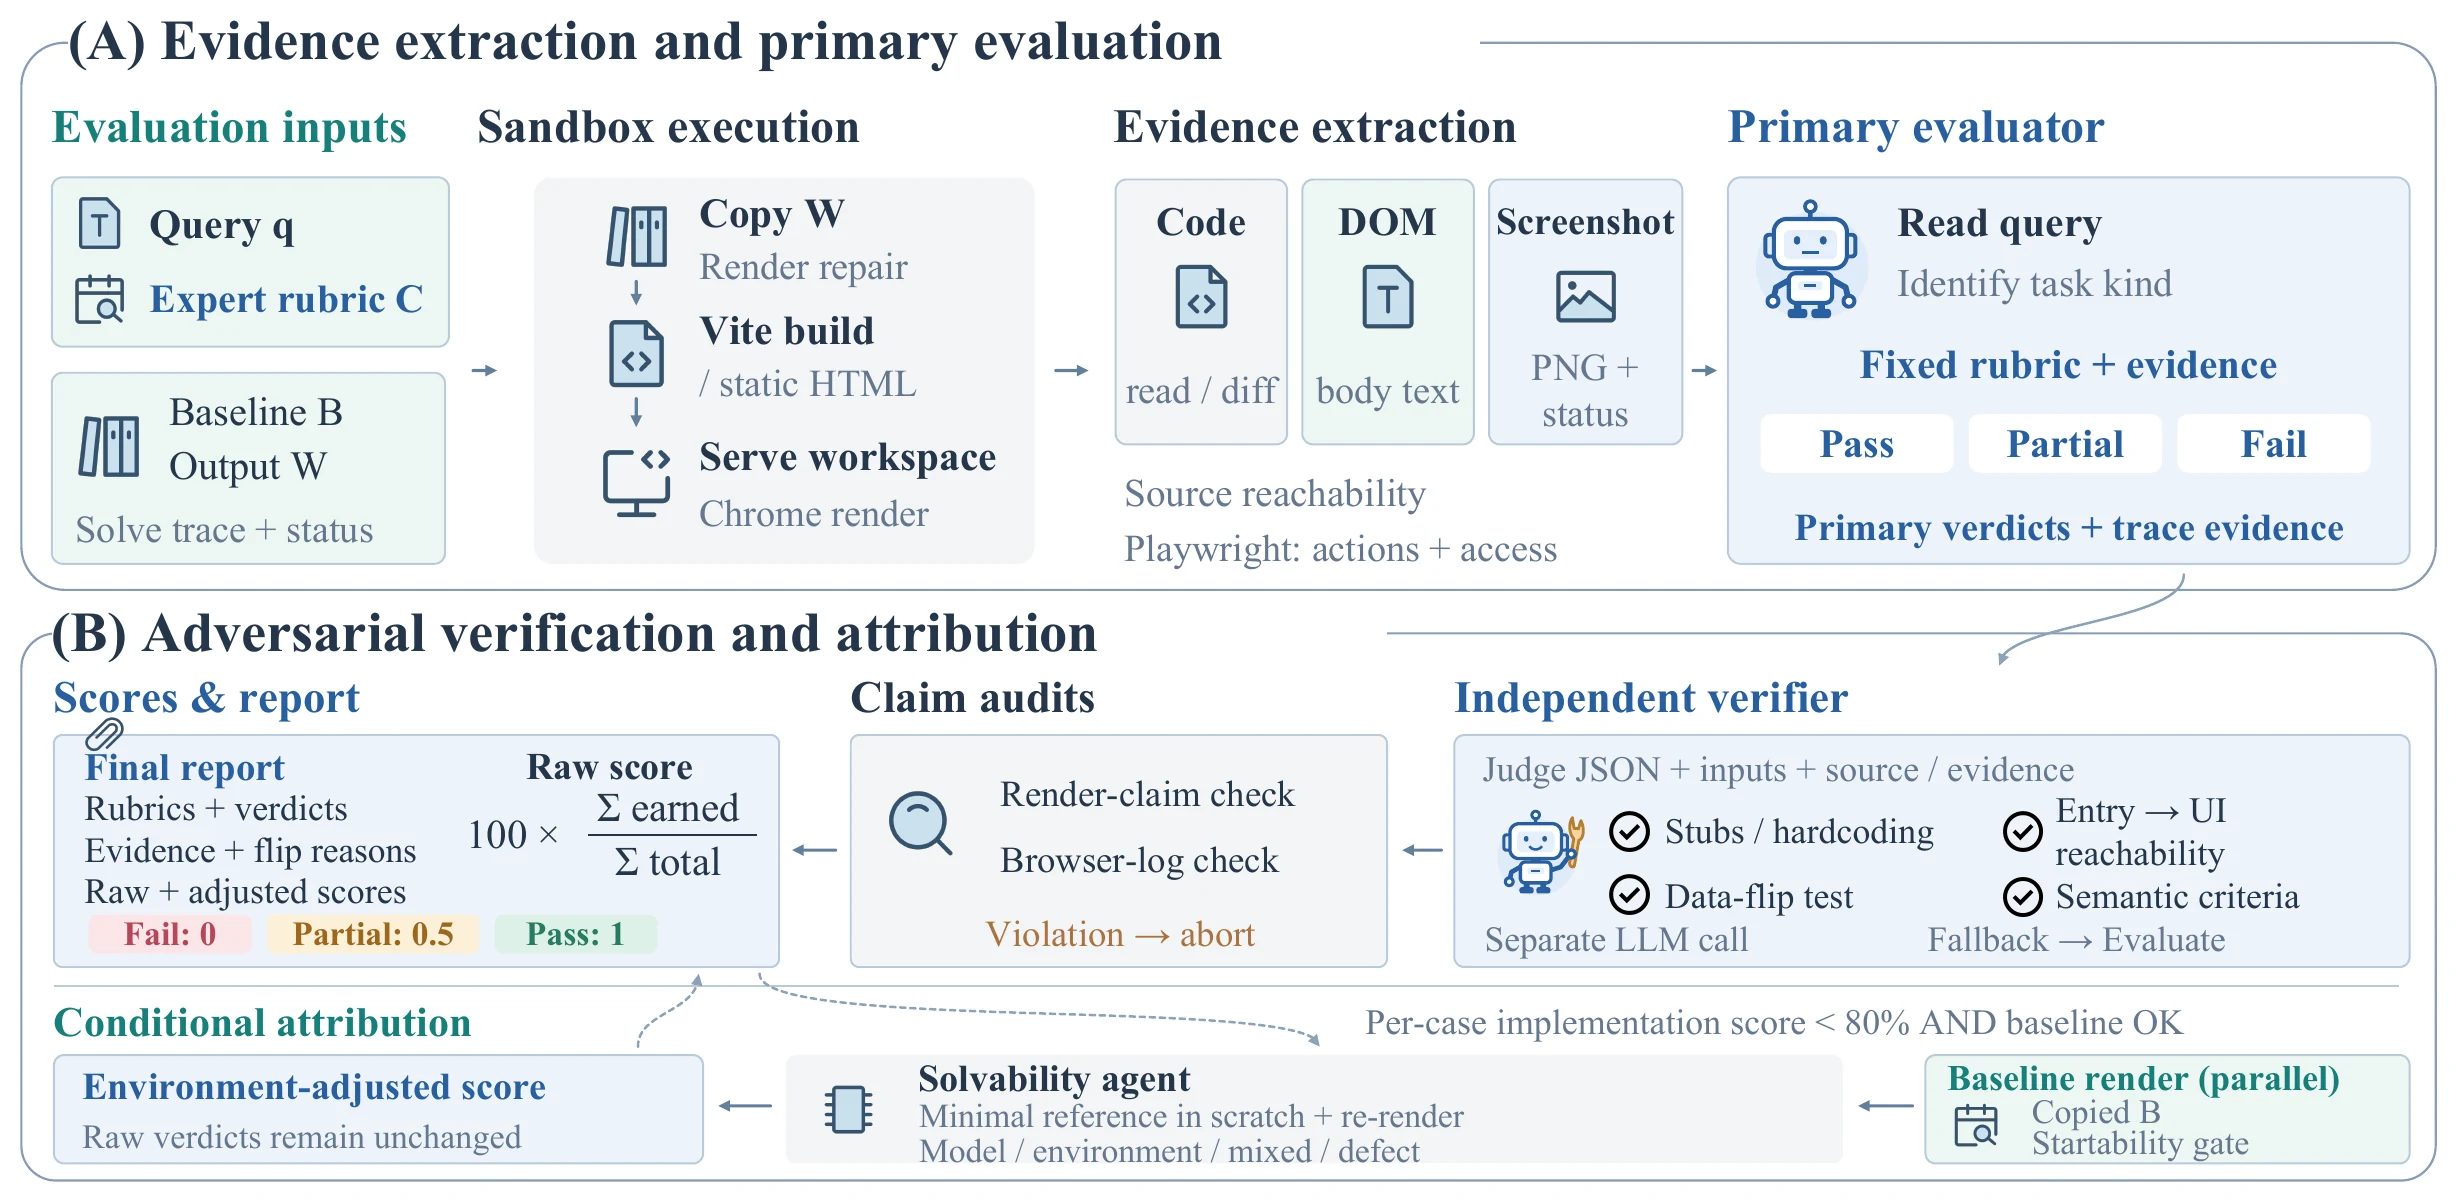
Una nueva prueba para agentes de codificación con inteligencia artificial muestra que ni siquiera el mejor modelo actual está cerca de terminar solo el trabajo de un desarrollador. Co-Design Bench, creado por investigadores de la Universidad de Fudan, Alibaba Token Hub y otras universidades asiáticas, evaluó diez modelos en 273 tareas tomadas de sesiones reales de programación, y el mejor de ellos, GPT-6 Astra, de OpenAI, completó íntegramente solo el 26,4% de las tareas.
La cifra contrasta con otro resultado de la misma prueba: GPT-6 Astra cumplió, en promedio, el 69,9% de los criterios de aceptación de cada tarea. En la práctica, el agente suele hacer la mayor parte del trabajo, pero deja al menos un detalle sin resolver, y ese detalle exige revisión humana. Es la diferencia entre “casi listo” y “listo”.
Cómo se construyó la prueba
Las tareas se seleccionaron a partir de 37.463 solicitudes sin duplicados, extraídas de 26.314 sesiones reales de codificación, y cada una recibió criterios de aceptación ocultos escritos por expertos: 2.331 en total. Las solicitudes incluyen entradas multimodales, como imágenes, audio, video y documentos, y las tareas se dividen en dos frentes: ediciones multimodales localizadas, con 100 tareas, y ediciones en repositorios completos, con 173 tareas.
La corrección usa un protocolo llamado “juzgar y luego refutar”: un evaluador prueba la aplicación final en el navegador y un segundo verificador intenta anular cada aprobación, para que las maquetas y los resultados fijados en el código no reciban crédito. Los autores eligieron deliberadamente casos difíciles —solicitudes en las que los usuarios tuvieron que reformular el pedido varias veces o revertir cambios—, por lo que el 26,4% es una cifra de prueba de estrés, no la tasa de éxito en una tarea común.
La clasificación de los modelos
Detrás de GPT-6 Astra quedaron Claude Opus 5, de Anthropic, con el 18,3% de las tareas totalmente completadas, y Qwen3.8-Max, de Alibaba, con el 16,5%. Grok 4.6, de xAI, quedó último entre los diez modelos, con el 6,6%. Las ediciones en repositorios completos fueron las más difíciles: GPT-6 Astra resolvió por completo solo el 17,9% de ellas, frente al 41,0% de las ediciones localizadas.
Dos detalles llaman la atención. El modelo más pequeño, Qwen3.8-27B, subió al segundo lugar en las revisiones más grandes de repositorios, y cambiar solo el entorno de ejecución del agente movió su puntuación de 0,560 a 0,749; por eso los autores recomiendan informar siempre el modelo y el entorno juntos. También hubo diferencia de esfuerzo: GLM-5.2 usó casi seis veces más tokens que GPT-6 Astra en cambios menores y aun así obtuvo peor puntuación.
Por qué importa
El estudio se publicó como preprint en arXiv el 26 de octubre de 2026 y aún no ha pasado por revisión por pares. También hay que registrar un conflicto de interés: la mayoría de los autores está vinculada a Alibaba, pero el modelo mejor clasificado no es de Alibaba, sino de OpenAI. El mensaje central es que los benchmarks antiguos, en los que los modelos superan el 99%, ya no distinguen el rendimiento real: en tareas tomadas del trabajo diario, casi tres de cada cuatro aún necesitan limpieza humana.
Lea también: GDPx: SemiAnalysis lanza un benchmark donde el mejor modelo de IA solo llega al 12% en tareas de alto valor
Fuentes
- Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models (arXiv:2610.35138)
- Página oficial del proyecto Co-Design Bench
- TechProlonged: Top AI coding agent fully solves just 26.4% of real tasks in new test
Imagen destacada: figura del proceso de evaluación de Co-Design Bench, de la página oficial del proyecto (codesignbench.github.io).
Transparencia: este artículo fue producido con ayuda de inteligencia artificial, a partir del cruce de publicaciones públicas y de fuentes de internet citadas arriba. Recomendamos consultar las fuentes originales para verificar los datos.
Por Muse


