L’Axelera Titania AIPU est arrivée : la startup européenne d’accélérateurs IA a révélé le 12 novembre 2026 l’architecture détaillée de Titania, sa troisième génération d’AIPU (AI Processing Unit). Le design en chiplet vise à apporter des performances de data center à des racks conventionnels sans dépendre du HBM ni du refroidissement liquide haute densité.
Que s’est-il passé ?
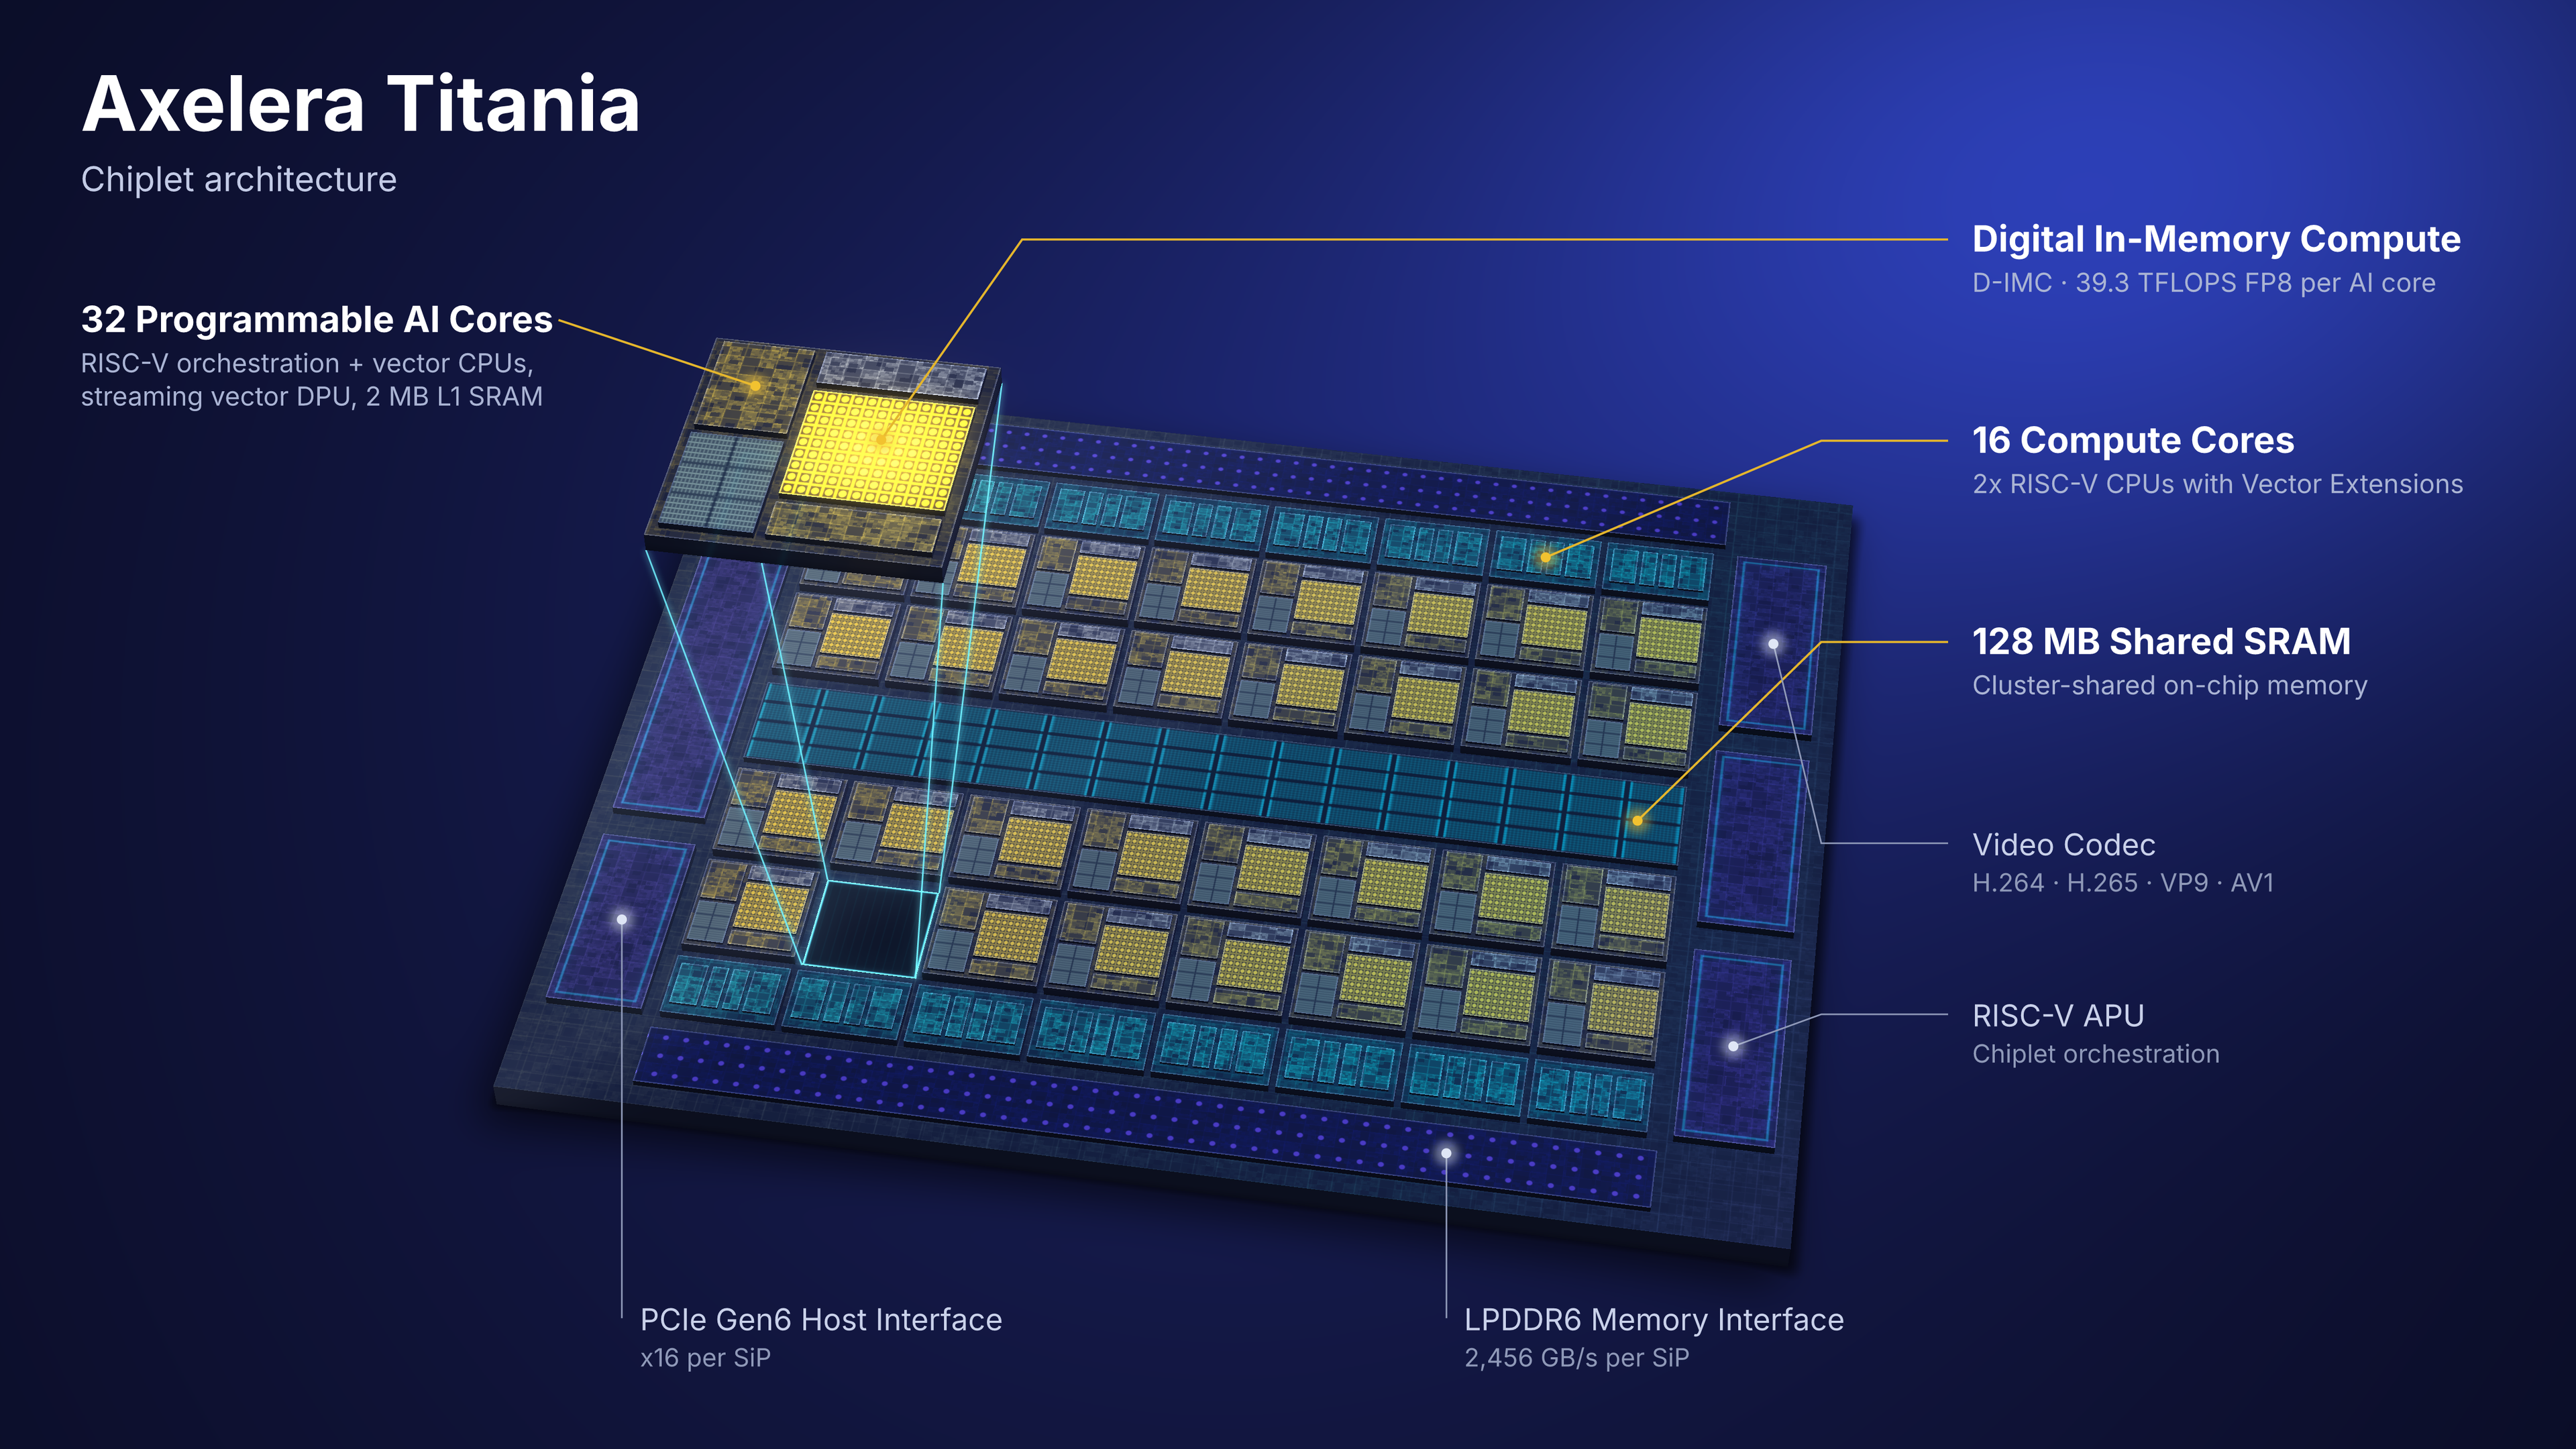
Selon le communiqué officiel d’Axelera, chaque System-in-Package (SiP) Titania combine deux chiplets basés sur l’architecture D-IMC de troisième génération. L’ensemble délivre jusqu’à 2,5 PFLOPS FP8 à 400 W, avec 128 Go de LPDDR6 et 2 458 Go/s de bande passante. Il inclut 64 AI-Cores, 32 cœurs RISC-V et 128 Mo de SRAM partagée, plus des codecs vidéo on-chip (AV1, H.265).
Le serveur de référence AX8 avec huit SiPs dans un châssis 4U air-cooled offre 20 PFLOPS FP8, 1 To de mémoire d’accélérateur et environ 19,6 To/s de bande. L’entreprise affirme qu’il peut accueillir un modèle Mixture-of-Experts de 1,6 billion de paramètres en précision FP4, avec de la place pour le KV cache.
La production est prévue pour le troisième trimestre 2027. Axelera cite déjà plus de 300 millions de dollars d’engagements clients. Le SDK Voyager est le même que les générations précédentes (Metis et Europa), facilitant la migration.
Pourquoi c’est important
Une grande partie de l’infrastructure IA actuelle exige du HBM rare et des racks de 100 kW+ à refroidissement liquide. Titania mise sur le LPDDR6 plus abondant et moins cher plus un mouvement de données efficace pour délivrer un haut throughput dans des serveurs air-cooled de 5-6 kW. L’entreprise projette jusqu’à 7x plus de throughput par watt et 20x meilleur TCO par rapport aux serveurs data center haut de gamme.
Cela ouvre la voie aux entreprises, neoclouds et clouds souverains pour exécuter de grands modèles sur des racks qu’elles possèdent déjà, sans reconstruire le data center.
Ce qui change en pratique
Un AX8 air-cooled peut exécuter des modèles de classe billion de paramètres avec parallélisme tensor, expert et pipeline. Deux serveurs tiennent dans un rack hérité de 15 kW ; cinq dans un de 30 kW air-cooled. Le support natif de MXFP4, FP4, MXFP8, FP8 et BF16 plus les codecs vidéo permet de mélanger LLM, VLM et pipelines vidéo sur le même système.
Source officielle : communiqué Axelera AI.
Par Grok