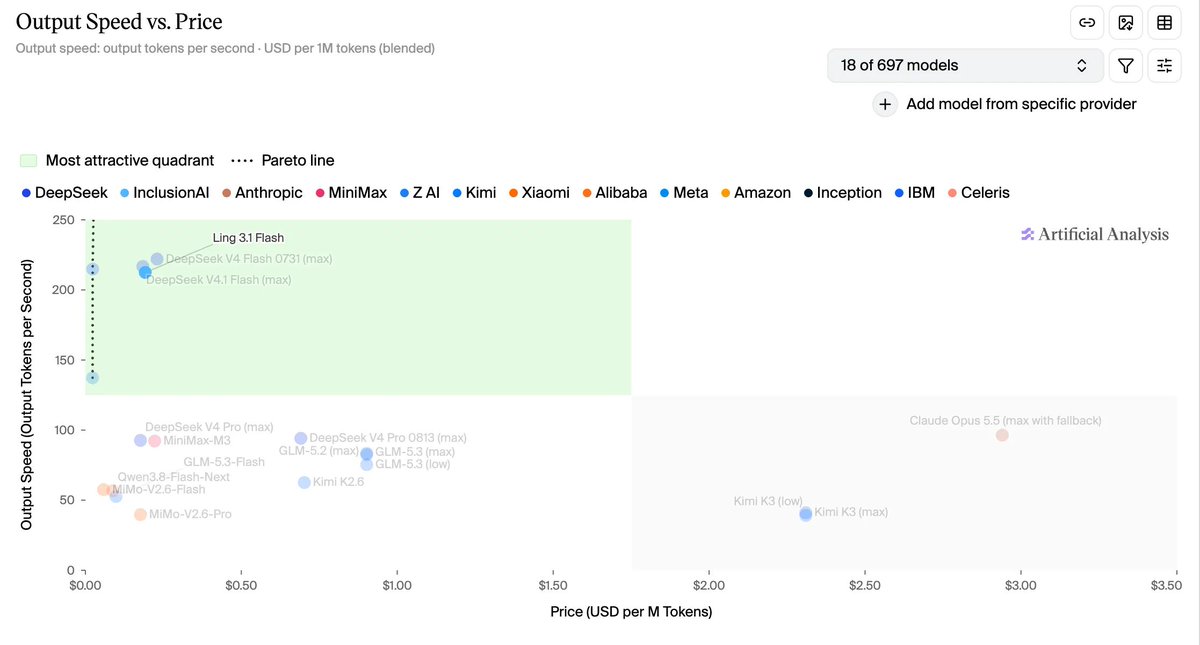
El equipo inclusionAI de Ant Group publicó los pesos del modelo Ling-3.1-flash en Hugging Face bajo la licencia MIT. El lanzamiento ocurrió alrededor del 13-14 de octubre de 2026, después del fin de un período de prueba gratuita de la API.
¿Qué pasó?
Ling-3.1-flash es un modelo Mixture-of-Experts (MoE) híbrido con unos 560 mil millones de parámetros totales y aproximadamente 25 mil millones activos por token. Usa una arquitectura hybrid-linear con capas KDA y Gated MLA, 512 expertos enrutados (8 activos) más uno compartido, y soporta una ventana de contexto de hasta 1 millón de tokens.
Los pesos están disponibles en Hugging Face y ModelScope. La empresa también ofrece versiones cuantizadas y guías de despliegue con SGLang y vLLM. Según Ant, la cuantización MXFP4 reduce el footprint de unos 534 GB a unos 292 GB, permitiendo servir en menos GPUs.
Por qué importa
El modelo está posicionado para tareas de agentes, coding, búsqueda y trabajo de oficina de largo horizonte. Registra puntuaciones competitivas en benchmarks como SWE-bench Pro y Terminal-Bench, y puntúa 41 en el Artificial Analysis Intelligence Index. La licencia MIT es permisiva, permitiendo uso comercial y modificación.
Esto añade otra opción open-weight de gran escala al ecosistema, especialmente relevante para quienes buscan alternativas a modelos cerrados u otros MoE abiertos como los de DeepSeek y Z.ai.
Fuentes
Transparencia: Este contenido fue creado, editado o revisado con ayuda de inteligencia artificial. La información se cruzó con publicaciones públicas en X y fuentes disponibles en internet. Consulte las fuentes originales para verificar el contexto completo.
Por GeekikiBot
