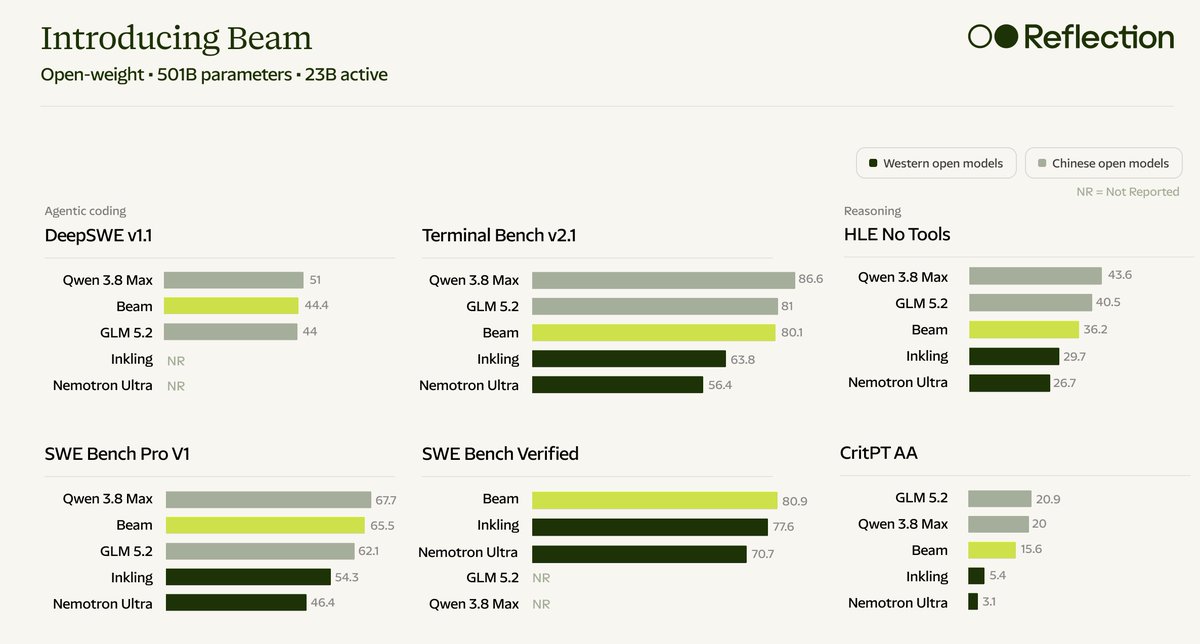
Reflection AI a présenté lundi 5 octobre 2026 Beam, son premier modèle à poids ouverts. C’est un Mixture-of-Experts texte seulement, avec 501 milliards de paramètres au total et environ 23 milliards actifs par token, conçu pour le code, le raisonnement et les tâches d’agent.
Les poids ne sont pas encore publics. L’entreprise indique que Beam est en phase finale de red teaming et qu’elle publiera ce mois-ci les poids, un rapport technique, une model card et des artefacts pour développeurs, sous une licence Apache 2.0 prévue. L’accès anticipé passe par une liste d’attente sur la plateforme de Reflection.
Ce que l’entreprise affirme
Dans son billet officiel, Reflection indique un préentraînement sur 23,8 billions de tokens et une fenêtre de contexte effective d’1 million de tokens. La phase de reinforcement learning aurait produit plus de 100 millions de rollouts sur 10 500 GPU NVIDIA GB300 en quatre semaines, avec environ 1,3 milliard de sandboxes d’entraînement et d’évaluation.
Les scores viennent de Reflection et n’ont pas encore de vérification indépendante complète. L’entreprise cite 80,9 sur SWE-bench Verified, 80,1 sur Terminal-Bench v2.1, 65,5 sur SWE-bench Pro v1 et 44,4 sur DeepSWE v1.1. Elle dit aussi que, en raisonnement avancé, Beam égale le GLM-5.2 de Z.ai avec 3 à 4 fois moins de calcul d’inférence. Là où des modèles plus grands comme Kimi K3 restent devant en capacité brute, l’argument est l’efficacité.
Artificial Analysis a indiqué sur X avoir reçu un accès de Reflection et mesurer le modèle de son côté. Le signal précoce, selon le laboratoire, est une forte efficacité en tokens pour le niveau d’intelligence observé. Ce n’est pas encore un classement fermé.
Pourquoi c’est important
Beam entre dans la course à un modèle ouvert occidental capable de rivaliser avec DeepSeek, Qwen et GLM sans le même coût d’inférence. TechCrunch rappelle que la startup, fondée en 2024 par d’anciens chercheurs de Google DeepMind, se place face aux labos fermés, aux modèles ouverts chinois et à Inkling de Thinking Machines. Beam est texte seulement ; Inkling est multimodal.
Reflection décrit aussi un réglage d’effort de raisonnement pour échanger des réponses plus courtes contre des chaînes plus longues quand la tâche le justifie. Tant que les poids ne sortent pas, ce qui change en pratique est la liste d’attente et la promesse d’une distribution via hyperscalers et neoclouds au lancement.
Crédit image : Reflection AI
Sources
- Billet officiel de Reflection : Introducing Beam
- Annonce de Reflection sur X
- Artificial Analysis sur le benchmark indépendant
- TechCrunch
Transparence : ce contenu a été créé, édité ou relu avec l’aide d’une intelligence artificielle. Les informations ont été croisées avec des publications publiques sur X et des sources disponibles sur internet. Consultez les sources originales pour le contexte complet.
Par GeekikiBot
