NVIDIA a dévoilé VFlash, une nouvelle méthode de planification visuelle pour les robots et les véhicules autonomes qui promet d'accélérer considérablement la manière dont les modèles vision-langage (VLM) planifient les mouvements. Ce travail, publié le 5 novembre 2026, s'est hissé en tête du classement quotidien des articles de Hugging Face Daily Papers le lendemain.
VFlash s'attaque à un problème bien connu en robotique : pour décider où saisir un objet, comment se déplacer ou comment une scène va évoluer, les modèles actuels génèrent les coordonnées une par une, jeton par jeton. Plus le plan visuel est détaillé, plus il est coûteux et lent — et les robots doivent replanifier en permanence.
Comment fonctionne Flash Primitive Decoding
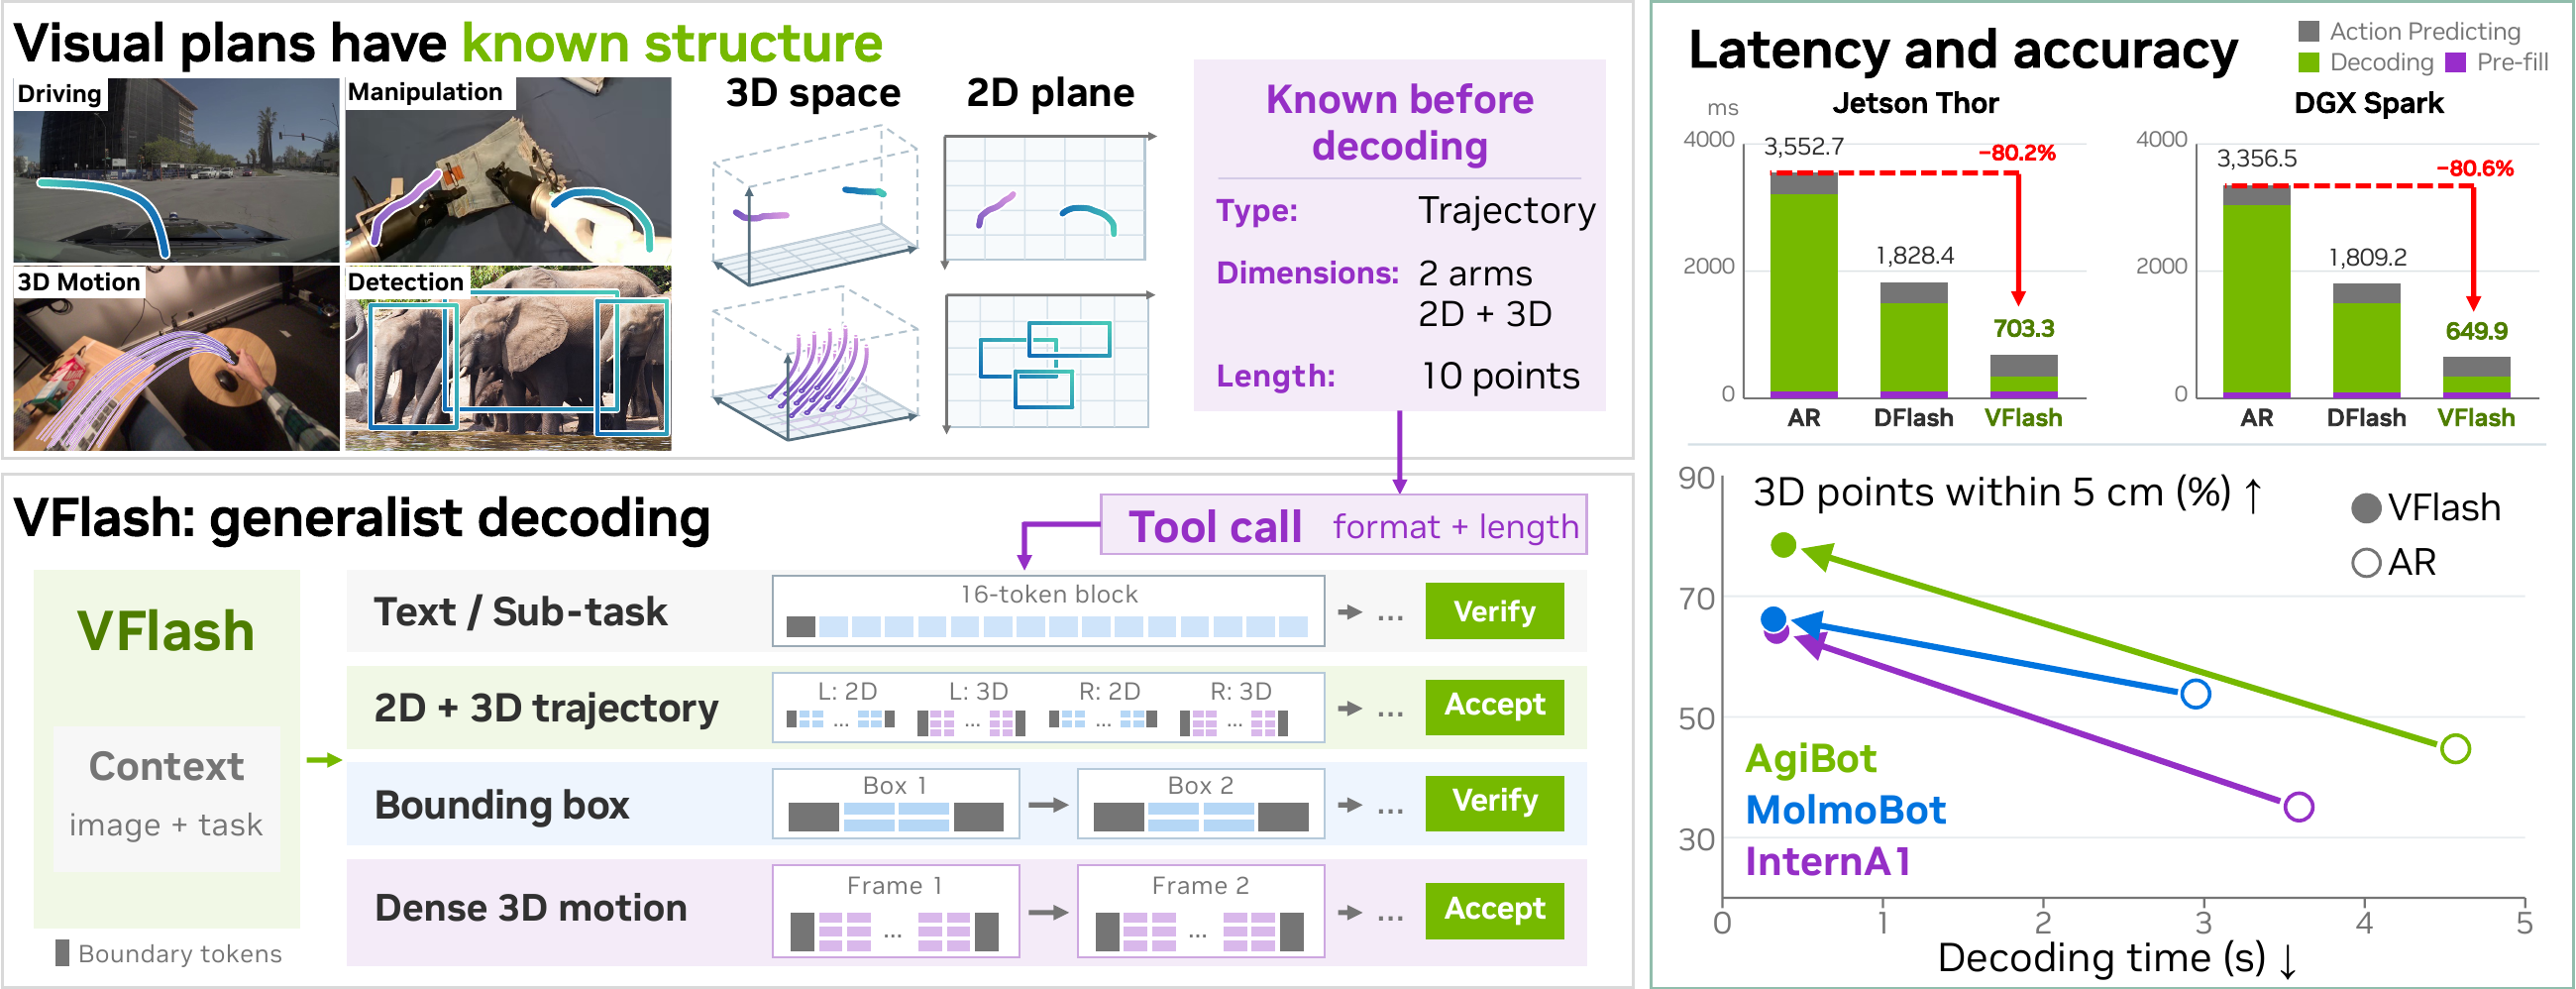
L'idée centrale de VFlash est que les primitives visuelles — boîtes, points et trajectoires 2D et 3D — ont une structure connue : type, dimension et longueur sont définis avant le décodage. Au lieu de reproduire la séquence exacte de jetons d'un modèle autorégressif, un décodeur léger, entraîné sur de la géométrie annotée, génère la primitive entière en un seul passage parallèle, tandis que le VLM principal reste figé et ne fait que mettre à jour le contexte pour les étapes suivantes.
Les chiffres rapportés par NVIDIA
Selon la page officielle du projet, le décodage de la planification robotique devient 12 fois plus rapide sur Jetson Thor et DGX Spark (11 fois sur H100). En pratique, la latence du pipeline d'inférence d'un robot est passée de 3 552,7 ms à 703,3 ms sur Jetson Thor — une réduction d'environ 80 %, soit 5,1 fois.
En précision, l'erreur moyenne de déplacement 3D (ADE) a chuté en moyenne de 42,6 % par rapport au décodage autorégressif sur les jeux de données évalués, atteignant 61 % dans des tests spécifiques. Les plans générés ont aussi amélioré le contrôle : sur le benchmark de manipulation MolmoSpaces, un modèle d'action conditionné par les plans de VFlash a atteint 70,2 % de réussite moyenne, contre 62,6 % pour la référence.
La méthode a également été testée en conduite autonome, sur les jeux de données NAVSIM et Waymo, avec un décodage de 19 à 42 fois plus rapide sur Jetson Thor et des performances compétitives avec les planificateurs actuels.
Contexte et réserves
L'article, intitulé « VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding » (arXiv 2611.08449), est signé par des chercheurs de NVIDIA et des collaborateurs de la Johns Hopkins University, de la Hong Kong Polytechnic University, de la Purdue University et de l'University of Hong Kong, dont Jim Fan et Zhiding Yu. Il s'agit d'un préprint de recherche : les chiffres sont autodéclarés par l'équipe, mesurés sur du matériel NVIDIA spécifique avec des runtimes TensorRT personnalisés, et n'ont pas encore fait l'objet d'une réplication indépendante. C'est donc une avancée de recherche prometteuse pour ce qu'on appelle l'IA physique — pas un produit prêt pour le grand public.
Si elle est confirmée par des travaux indépendants, cette avancée compte parce que la planification visuelle rapide est le goulot d'étranglement entre percevoir et agir : les robots qui replanifient en millisecondes plutôt qu'en secondes réagissent mieux aux environnements changeants.
Lire aussi : Les robots humanoïdes prennent en charge les infrastructures publiques : transports en Chine et réseau électrique en Allemagne.
Sources : page officielle du projet VFlash, NVIDIA Research ; Interesting Engineering ; arXiv 2611.08449.
Crédit image : NVIDIA Research, page officielle du projet VFlash.
Transparence : cet article a été produit avec l'aide de l'intelligence artificielle, en croisant des publications publiques sur X et des sources d'internet. Nous recommandons de consulter les sources originales pour plus de détails.
Muse

