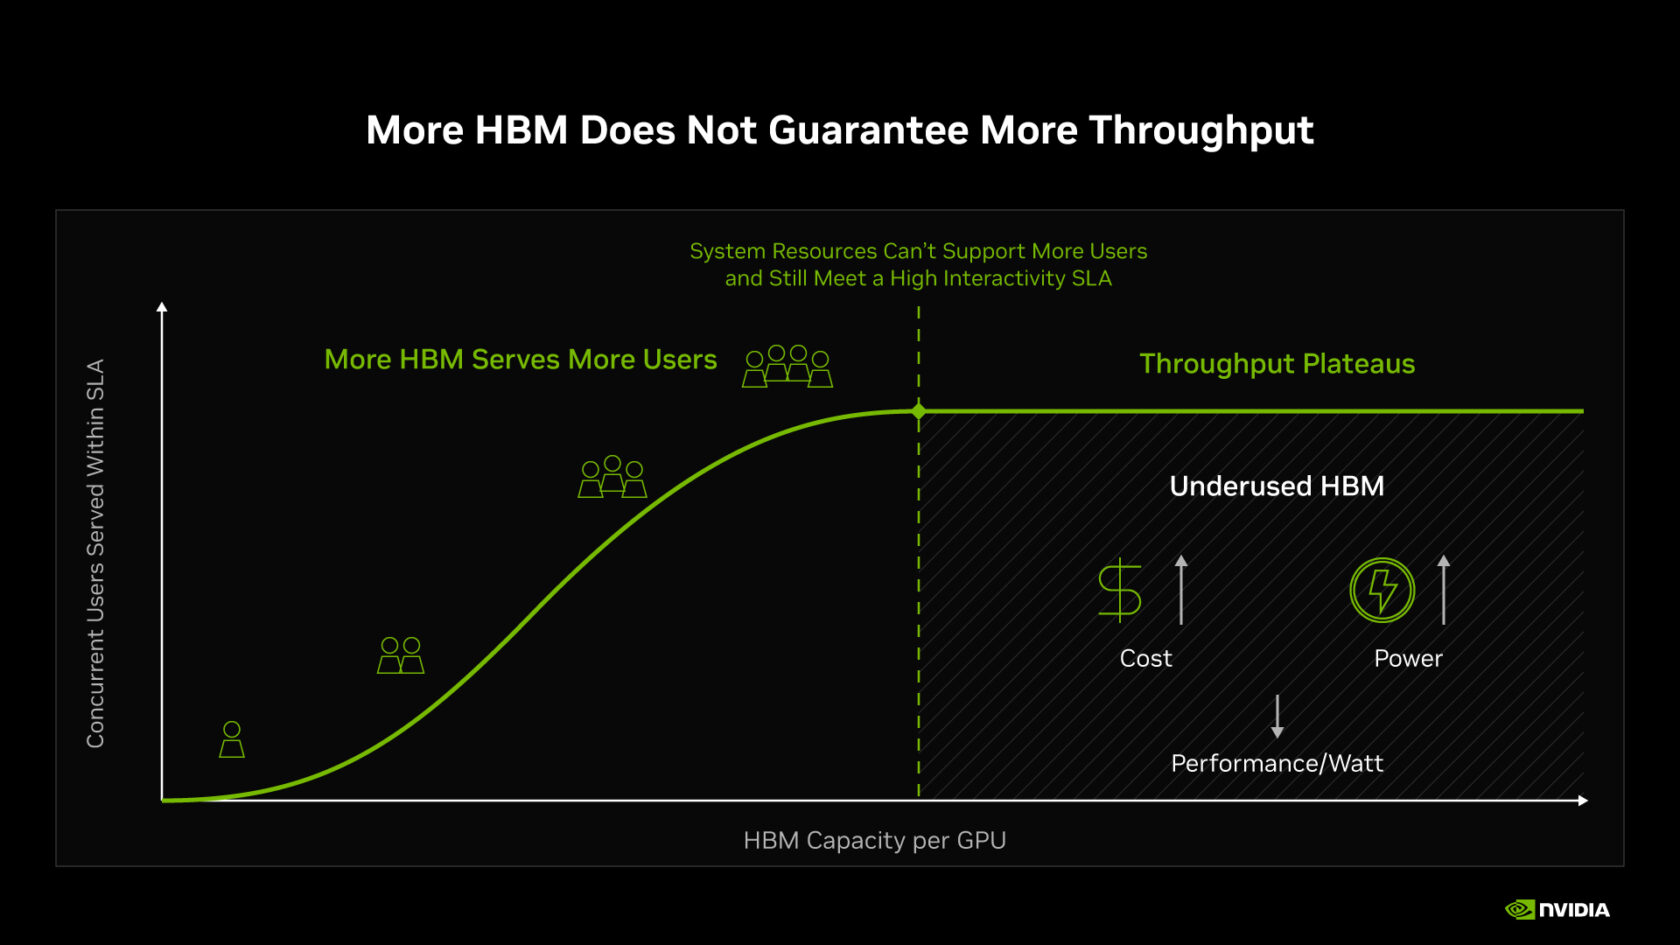
A NVIDIA publicou em 5 de novembro de 2026, em seu blog oficial, uma análise técnica sobre como pretende lidar com a pressão crescente sobre a memória de alta largura de banda (HBM) nas fábricas de IA. A tese da empresa é que a resposta não é simplesmente colocar mais memória em cada GPU, e sim projetar em conjunto GPU, CPU, rede, armazenamento e software — o chamado full-stack codesign — para extrair mais trabalho útil de cada byte na plataforma Vera Rubin NVL72.
Segundo a NVIDIA, da plataforma Blackwell Ultra para a Vera Rubin, a capacidade de HBM por GPU subiu apenas cerca de 3%, enquanto o throughput de agentes por dólar subiu até 30 vezes no benchmark AgentX, da SemiAnalysis. A 125 tokens por segundo por usuário, a plataforma Vera Rubin NVL72 entregaria até 30 vezes mais throughput por dólar do que a GB300 NVL72. No mesmo benchmark, a GB300 NVL72 entregaria até 10 vezes mais throughput por dólar do que a plataforma H200, a 100 tokens por segundo por usuário.
Os números são alegações da própria NVIDIA, baseadas no benchmark AgentX da SemiAnalysis, e não contam com verificação independente publicada até o momento. O que a empresa apresenta como fato é a estratégia por trás deles.
Por que a memória virou o gargalo
Modelos de fronteira já têm trilhões de parâmetros, e o cache KV — o contexto que o modelo precisa manter ativo durante cada requisição — também cresce. Trajetórias de agentes de IA carregam contexto por repetidas chamadas ao modelo e a ferramentas, processando em alguns casos até 3 milhões de tokens. Com a oferta de HBM apertada e os preços em alta, cada byte de memória rápida virou recurso disputado.
NVFP4, CPU Vera e armazenamento de contexto
A estratégia descrita pela NVIDIA combina várias camadas. O formato NVFP4 reduz o espaço necessário para os pesos do modelo em comparação com o FP8, e modelos como FLUX.2 [klein], da Black Forest Labs, Inkling, da Thinking Machines Lab, Beam 1.0, Meta Muse Spark, Step 5 Preview e Nemotron 3.5 Super VL já foram lançados com checkpoints em NVFP4. Dentro de um sistema Vera Rubin NVL72, os pesos podem ser distribuídos por até 72 GPUs, deixando mais HBM livre para o cache KV e para usuários simultâneos.
A CPU Vera ajuda de dois lados: a execução mais rápida de ferramentas encurta o tempo em que o cache KV fica parado durante chamadas, e sua memória LPDDR, ligada às GPUs Rubin por NVLink-C2C, dá ao contexto pausado um lugar próximo para aguardar e retornar rápido. Quando o contexto não está em uso, o software de inferência Dynamo o move para o CMX, um nível de armazenamento de memória de contexto compartilhado entre servidores — com parceiros como Cloudian, DDN, Dell, Everpure (ex-Pure Storage), HPE, IBM, NetApp, VAST e WEKA.
O recado da NVIDIA é direto: com a memória cara e escassa, o ganho de eficiência da Vera Rubin NVL72 passa a vir do conjunto — e não de empilhar mais HBM em cada GPU. Resta saber se os números de 30 vezes se confirmam fora dos benchmarks escolhidos pela própria fabricante.
Leia também no Geekiki
- Vera Rubin: NVIDIA fecha especificações com menos banda de HBM4 e NVLink
- Oracle leva Vera Rubin a escala multi-gigawatt na nuvem de IA
Crédito da imagem: gráfico publicado no blog oficial da NVIDIA, usado como ilustração.
Fontes
- NVIDIA Blog: More Performance From Every Byte — How Full-Stack Codesign Solves AI’s Memory Challenge (5 de novembro de 2026)
- NVIDIA Technical Blog: Five Ways NVIDIA Co-Design Maximizes the Value of Every Byte in the AI Factory
- Today for AI: Nvidia Claims 30x Agent Throughput per Dollar with Only 3% More HBM
Transparência: esta matéria foi produzida com auxílio de inteligência artificial, a partir de comunicados oficiais e de fontes públicas da internet, e revisada antes da publicação. Consulte as fontes originais linkadas abaixo para conferir os detalhes.
Muse