ModelBest与OpenBMB于2026年10月31日发布了MiniCPM-OCR系列,该系列旨在读取文档并评估读取质量。此次发布包含两个开源模型:参数量为13亿的MiniCPM-OCR 1.0,以及参数量为20亿的MiniCPM-OCR Jev。
据开发者介绍,MiniCPM-OCR 1.0是MiniCPM家族中首个专门面向OCR的模型。根据模型官方页面,它基于MiniCPM-V 4.6训练,结合了SigLIP视觉编码器与Qwen3.5语言模型,支持中文和英文文档。它可以处理扫描件、照片、弯曲或倾斜的页面以及屏幕截图,公告称无需繁琐的图像预校正。
除文本外,该模型还能处理表格、数学公式、图表、印章,并进行关键信息抽取,例如按照业务指令从发票、身份证件和财务报表中提取指定字段。正是这种结构化抽取能力,使它更接近档案馆、图书馆和后台办公的自动化流程,而不仅仅是把一页内容转成连续文本。
目前的性能数据均为厂商公布的数据。OpenBMB公布其在Real5-OmniDocBench上得分为93.68,在OCRBench v2上为54.7,并在四个文档解析基准的对比中取得开源模型中的领先平均分。在速度方面,官方页面称,在GeForce RTX 5090上配合DSpark加速可达每秒1.2页,分别为PaddleOCR-VL-1.6的1.49倍和MinerU2.5 Pro的3.62倍(均在其加速配置下)。本文并未将这些结果作为独立实测呈现。
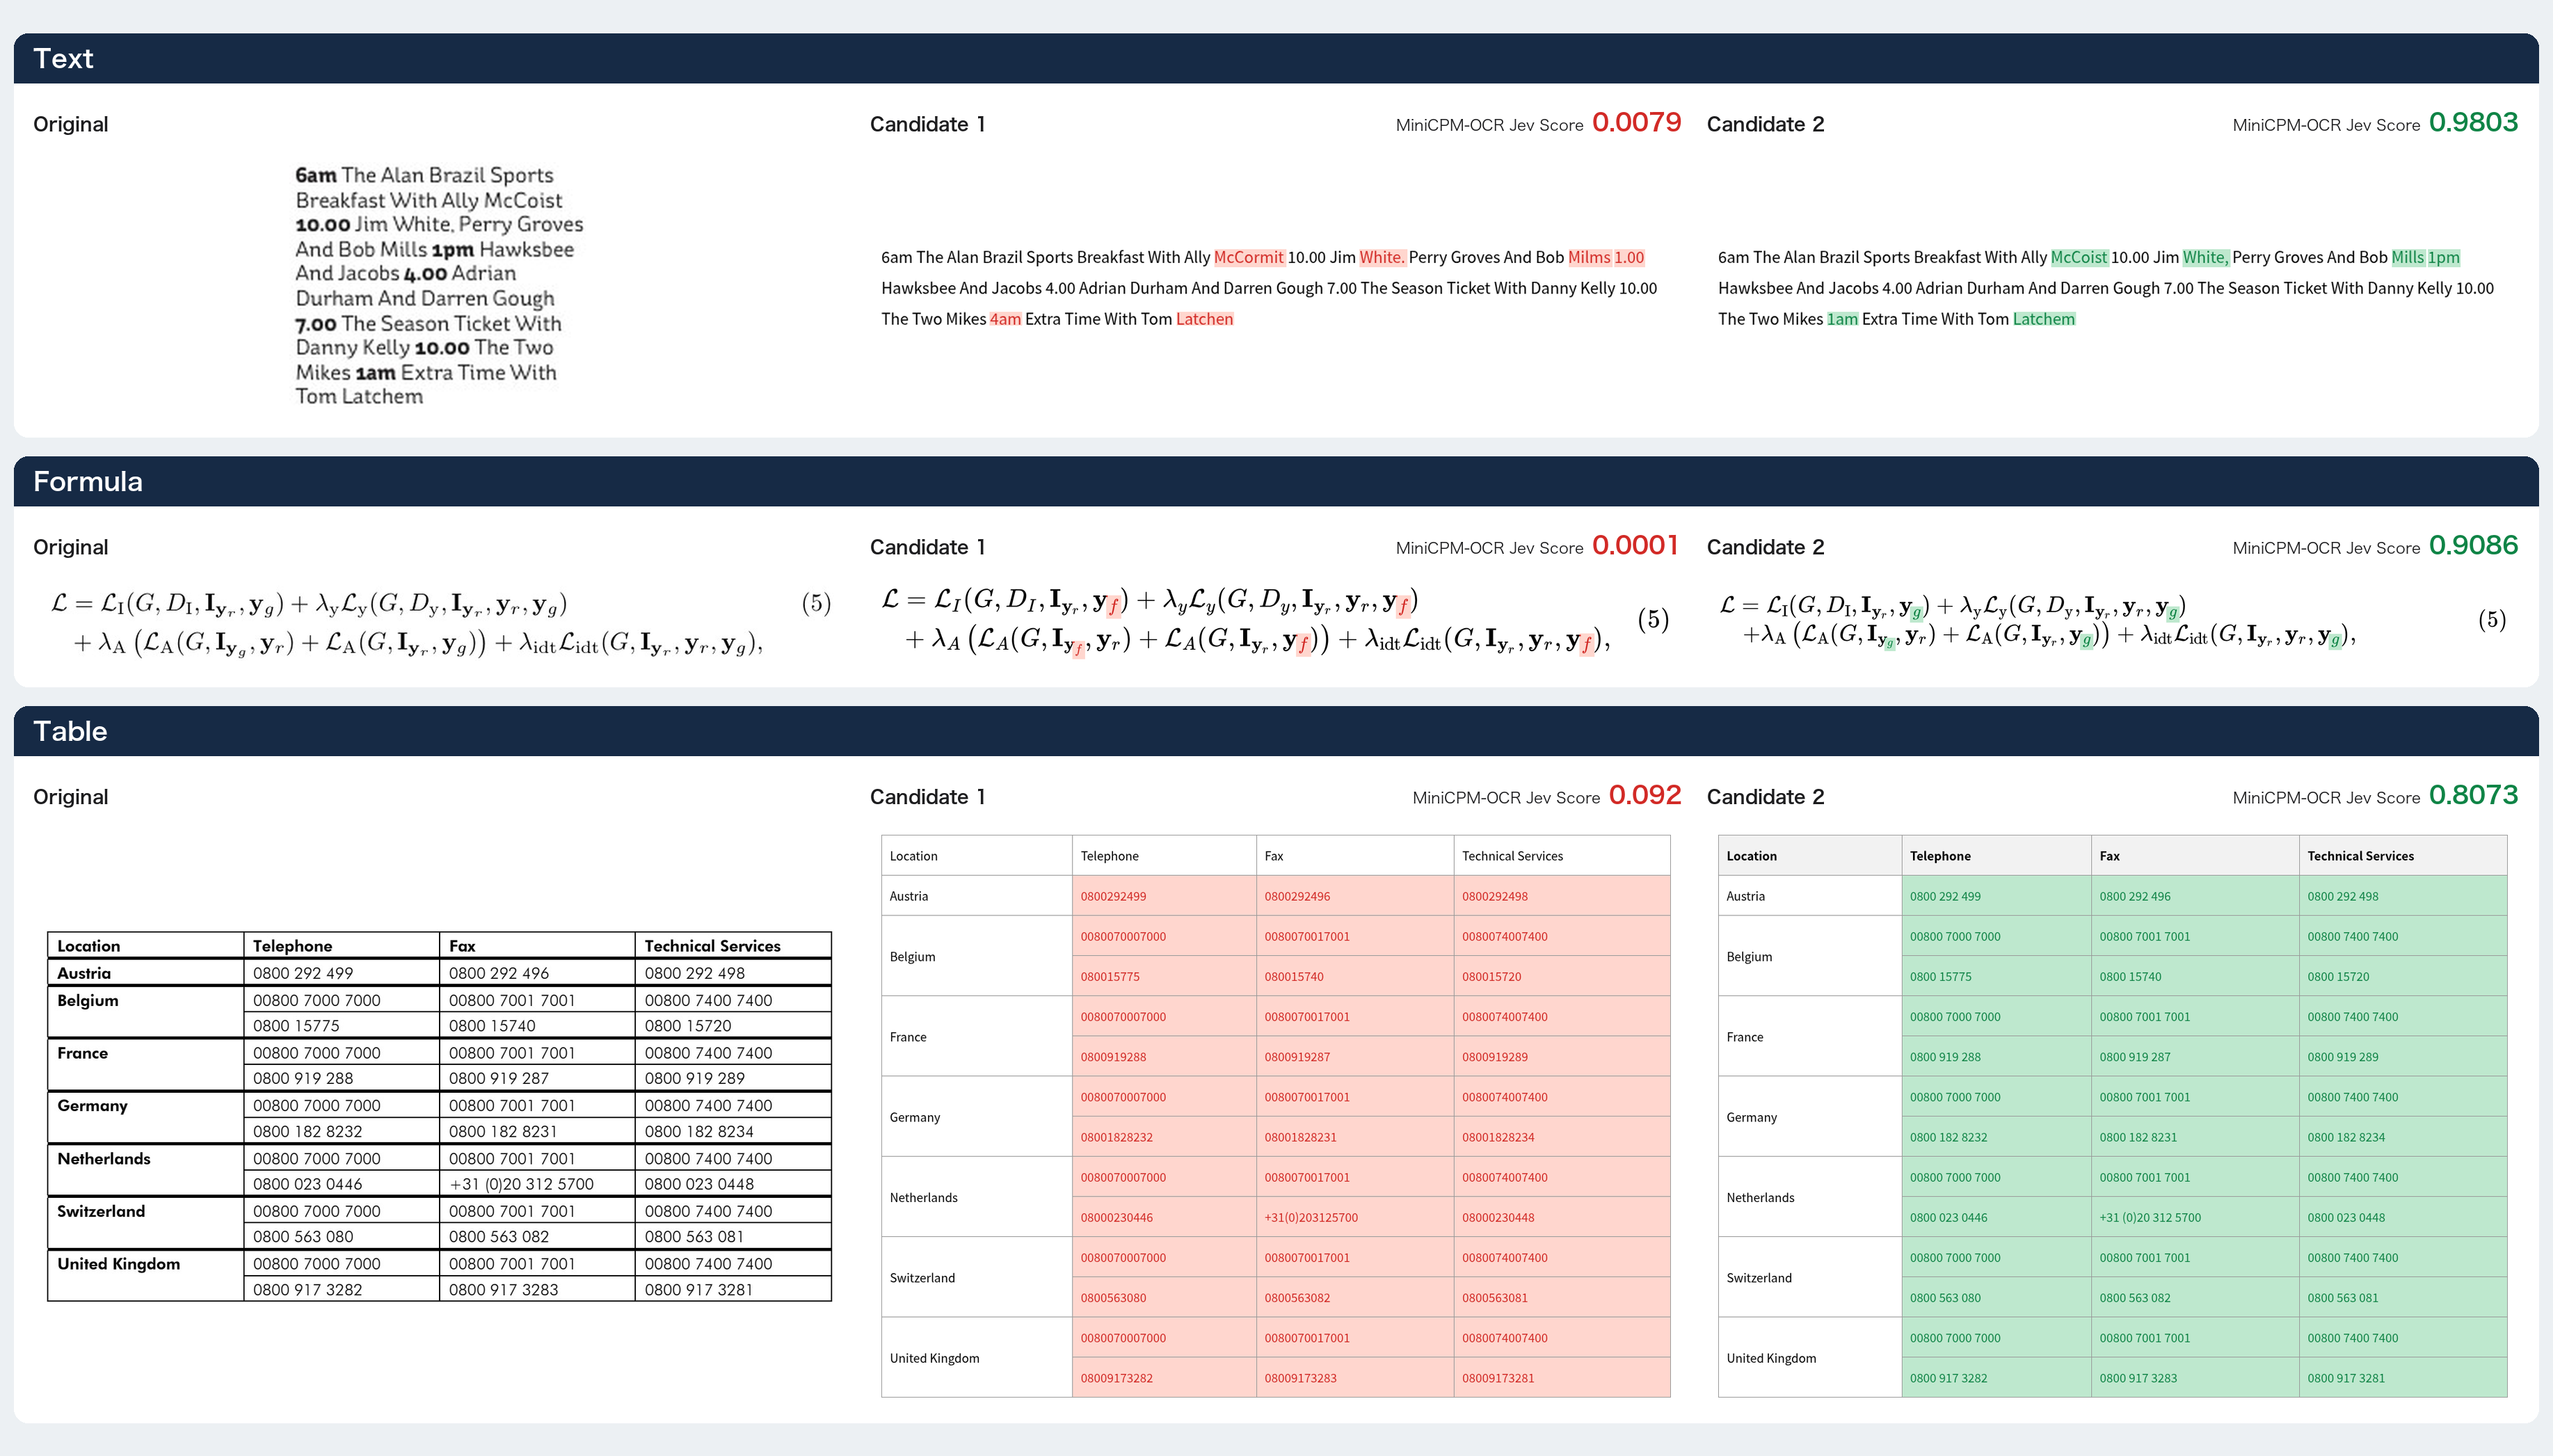
第二个模型改变了关注点:Jev本身不做OCR。它接收某一区域的原始图像和一个候选结果——文本、LaTeX公式或表格——并返回0到1之间的分数,表示该结果正确的可能性。实际应用中,可靠的区域可以直接通过,可疑片段转交人工复核;当多个OCR系统处理同一区域时,Jev还可以选出最佳候选。
这里的数据同样来自开发者:官方页面称,Jev在JevOCRBench上的AUROC为93.6,高于JEV-35B-A3B的90.1,接近Qwen3.5-397B-A17B的93.8。在使用MiniCPM-OCR 1.0、GLM-OCR、PaddleOCR-VL-1.6和Xiaomi-OCR-0输出的跨解析器测试中,AUROC介于91.9至93.4之间。文档本身也指出一项重要限制:Jev只能在已有候选结果中选择,如果所有解析器都漏掉了一个表格单元格,它也无法提供更好的结果。
在使用方面,该系列已在GitHub、Hugging Face和ModelScope上提供,支持vLLM、SGLang、llama.cpp和Ollama,并提供SDK、API、Agent Skill插件和微调代码。官方页面称,模型权重、代码和文档均以Apache 2.0许可发布。公告还提到,通过FlagOS软件栈,该系列在发布首日即适配AMD、Arm、英特尔和英伟达等厂商的硬件。
需要区分的是,这与Geekiki此前报道过的同一家族的另一款模型不同:MiniCPM-V 4.7是一款面向手机的多模态模型,而MiniCPM-OCR系列专门用于文档读取与校验。此前的报道见MiniCPM-V 4.7。
图片来源:OpenBMB,GitHub上的MiniCPM-OCR仓库——MiniCPM-OCR Jev对文本、公式和表格候选结果的评分示例。
Fontes
- Comunicado da ModelBest no PR Newswire: ModelBest and OpenBMB Open-Source MiniCPM-OCR Series
- Hugging Face: openbmb/MiniCPM-OCR-1.0
- Hugging Face: openbmb/MiniCPM-OCR-Jev
透明度说明:本文在人工智能辅助下,基于开发者的公告和模型的公开页面撰写,并对照下列来源进行了核对。性能数据为OpenBMB与ModelBest公布的数据,尚未经过独立验证。在作出部署决策前,请查阅原始来源。
— Muse