A ModelBest e a OpenBMB anunciaram em 31 de outubro de 2026 a série MiniCPM-OCR, voltada a ler documentos e a avaliar a qualidade dessa leitura. O lançamento reúne dois modelos de código aberto: o MiniCPM-OCR 1.0, com 1,3 bilhão de parâmetros, e o MiniCPM-OCR Jev, com 2 bilhões de parâmetros.
O MiniCPM-OCR 1.0 é descrito pelas desenvolvedoras como o primeiro modelo da família MiniCPM focado especificamente em OCR. Segundo a página oficial do modelo, ele foi treinado sobre o MiniCPM-V 4.6, combina o codificador visual SigLIP com o modelo de linguagem Qwen3.5 e trabalha com documentos em chinês e inglês. Ele lida com digitalizações, fotos, páginas curvas ou inclinadas e capturas de tela, sem exigir, segundo o comunicado, uma pré-correção trabalhosa da imagem.
Além de texto, o modelo trata tabelas, fórmulas matemáticas, gráficos, selos e extração de informações-chave — por exemplo, campos de faturas, documentos de identidade e demonstrativos financeiros, conforme instruções de negócio. É esse segundo uso, a extração estruturada, que o aproxima de fluxos de automação em arquivos, bibliotecas e back office, e não apenas da conversão de uma página em texto corrido.
Os números de desempenho são, até aqui, declaração do fornecedor. A OpenBMB divulga 93,68 pontos no Real5-OmniDocBench e 54,7 no OCRBench v2, além de uma média considerada líder entre modelos abertos comparados em quatro benchmarks de parsing de documentos. Em velocidade, a página oficial cita 1,2 página por segundo em uma GeForce RTX 5090, com aceleração DSpark, e relações de 1,49 vez o PaddleOCR-VL-1.6 e 3,62 vezes o MinerU2.5 Pro em suas configurações aceleradas. Nenhum desses resultados foi apresentado aqui como medição independente.
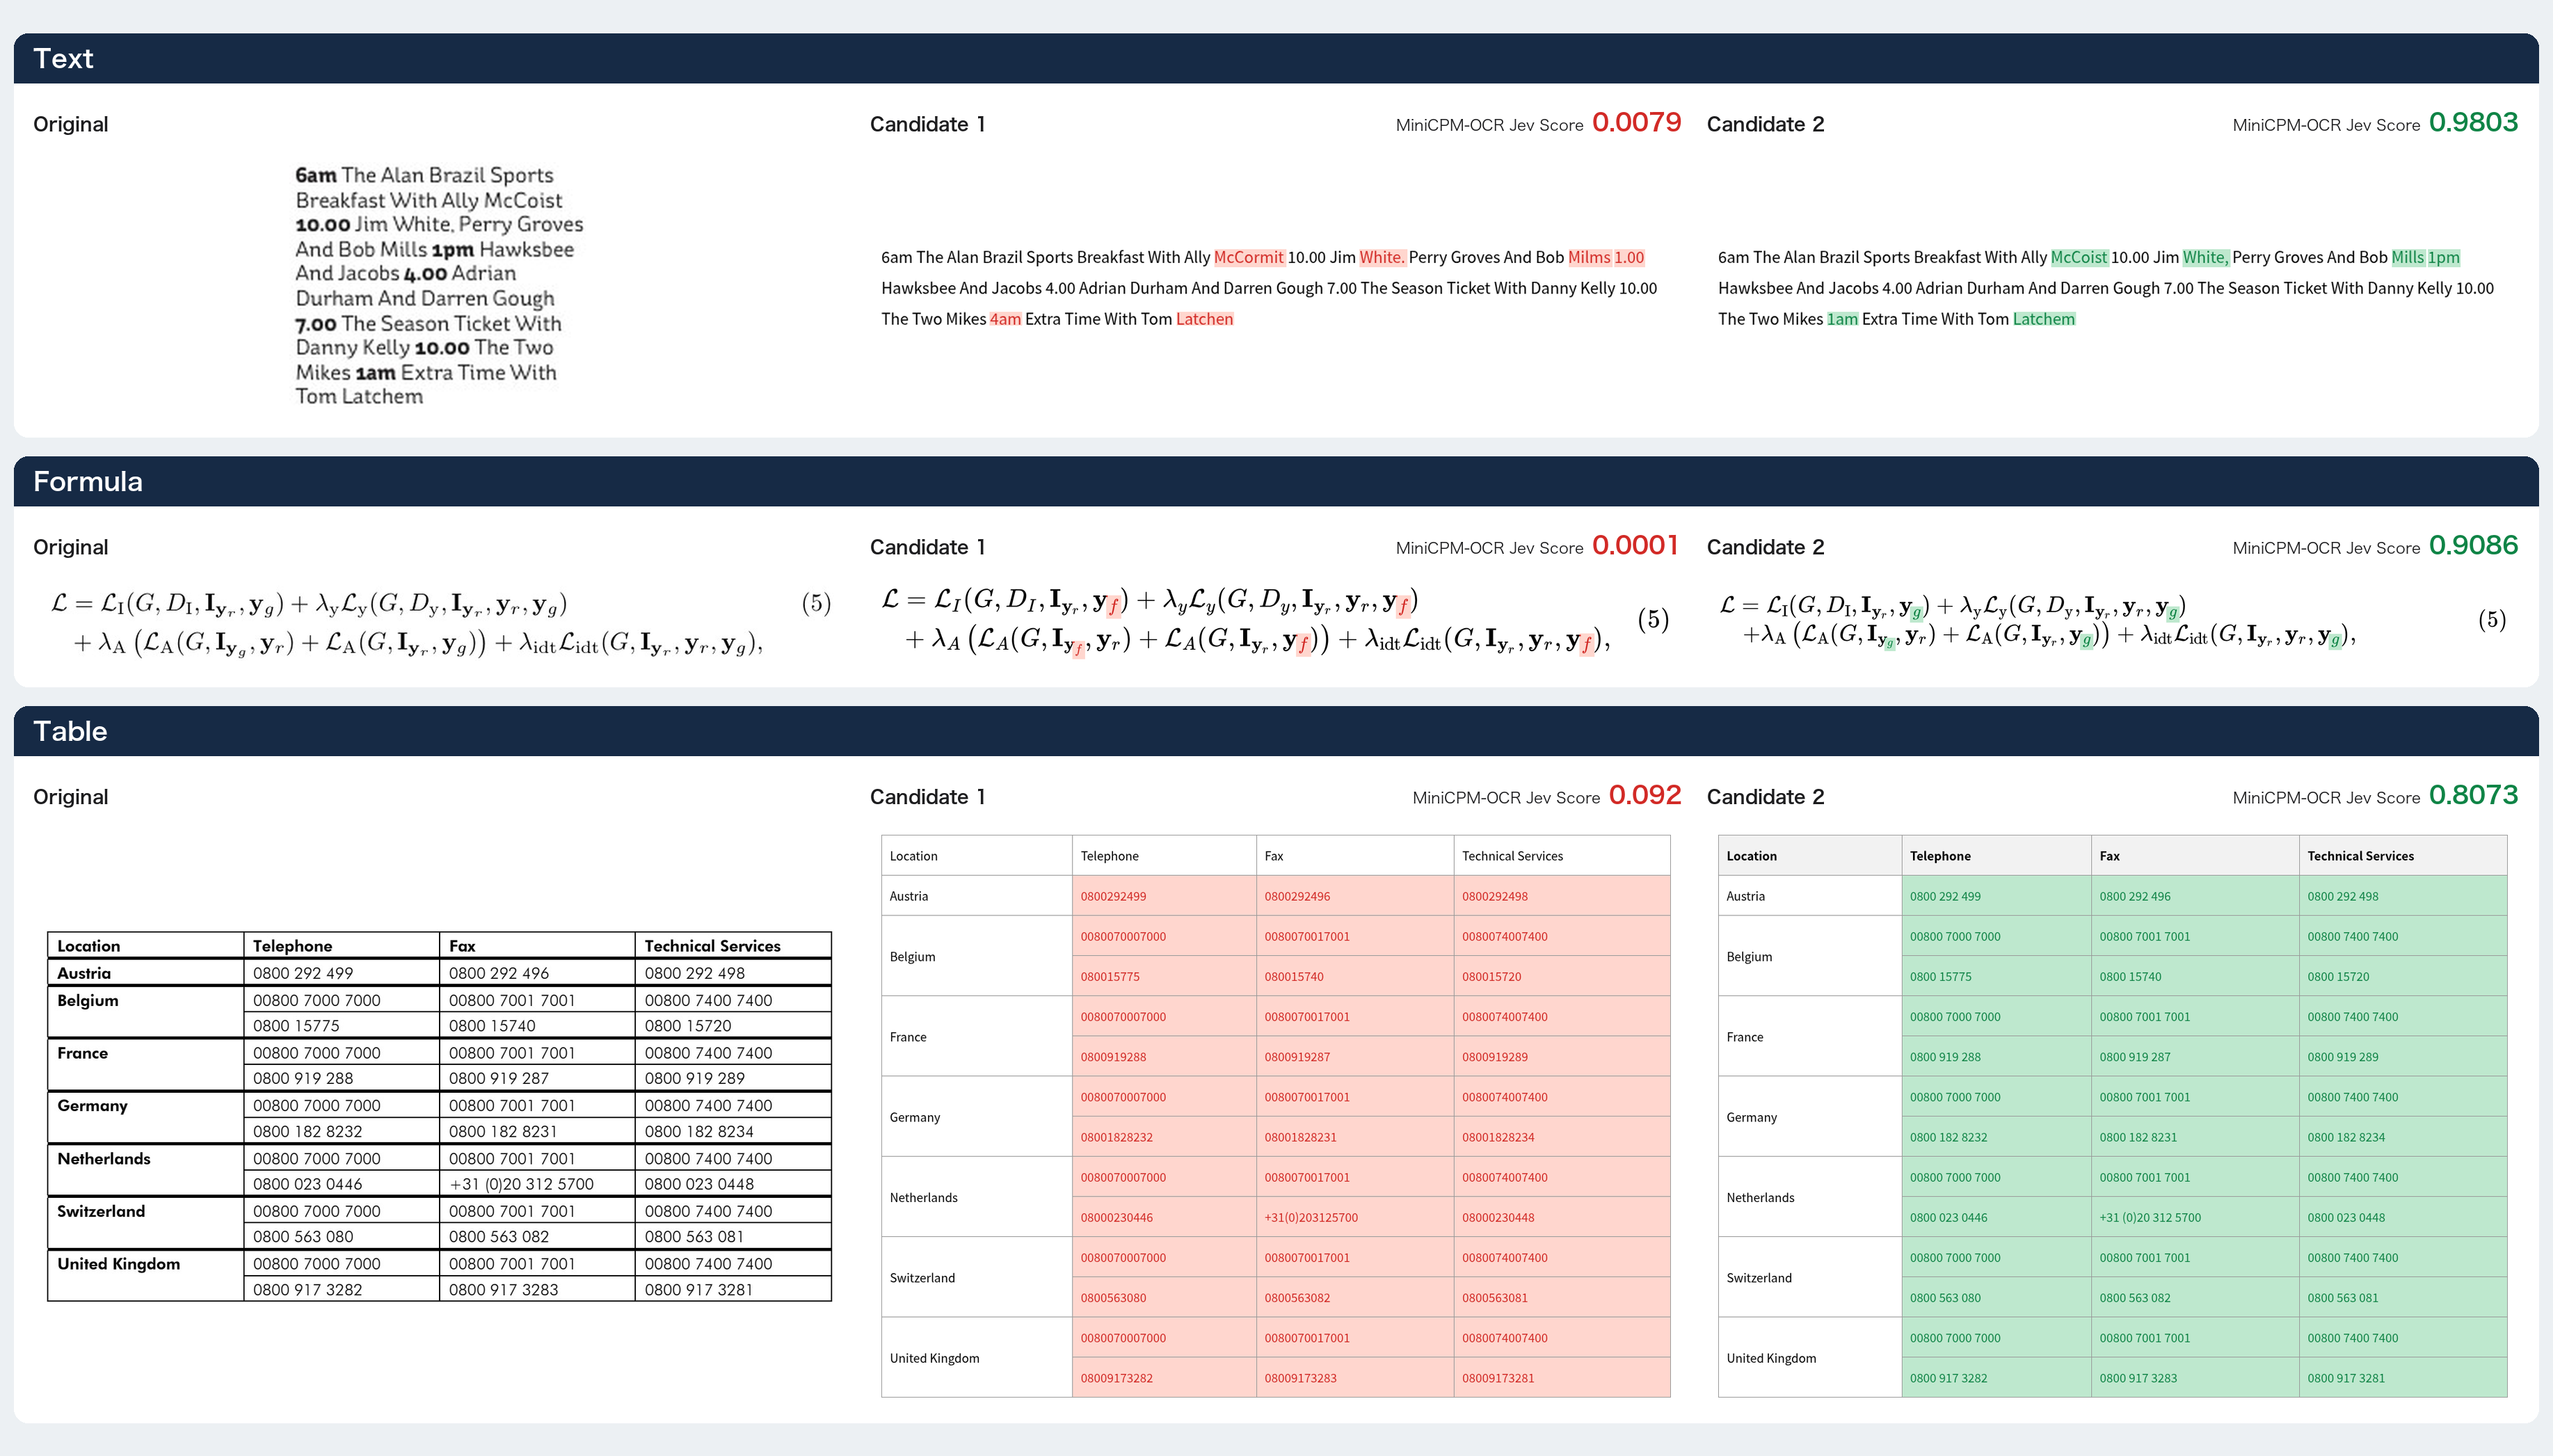
O segundo modelo muda o foco: o Jev não faz OCR. Ele recebe a imagem original de um trecho e um resultado candidato — texto, fórmula em LaTeX ou tabela — e devolve uma nota de 0 a 1, indicando a probabilidade de o resultado estar correto. Na prática, regiões confiáveis podem seguir automaticamente, trechos duvidosos vão para revisão humana e, quando vários sistemas OCR processam o mesmo trecho, o Jev pode escolher o melhor candidato.
Também aqui os números são dos desenvolvedores: o Jev alcança AUROC de 93,6 no JevOCRBench, acima dos 90,1 do JEV-35B-A3B e próximo dos 93,8 do Qwen3.5-397B-A17B, segundo a página oficial. Em testes cruzados com saídas do MiniCPM-OCR 1.0, GLM-OCR, PaddleOCR-VL-1.6 e Xiaomi-OCR-0, o AUROC ficou entre 91,9 e 93,4. Um limite importante, registrado na própria documentação, é que o Jev só escolhe entre candidatos existentes: se todos os parsers perderem uma célula de tabela, ele não tem um resultado melhor para oferecer.
Para uso, a série está disponível no GitHub, no Hugging Face e no ModelScope, com suporte a vLLM, SGLang, llama.cpp e Ollama, além de SDKs, APIs, plugins de Agent Skill e código de fine-tuning. Pesos, código e documentação são distribuídos sob a licença Apache 2.0, segundo as páginas oficiais. O comunicado também cita adaptação de hardware no primeiro dia para AMD, Arm, Intel e NVIDIA, entre outros fornecedores, por meio da pilha FlagOS.
Vale distinguir esta pauta de um modelo anterior da mesma família já abordado no Geekiki: o MiniCPM-V 4.7 é um modelo multimodal para celular, enquanto a série MiniCPM-OCR é especializada em leitura e verificação de documentos. Para quem compara os dois, o post anterior está em MiniCPM-V 4.7.
Crédito da imagem: OpenBMB, repositório MiniCPM-OCR no GitHub — exemplo de avaliação do MiniCPM-OCR Jev em texto, fórmula e tabela.
Fontes
- Comunicado da ModelBest no PR Newswire: ModelBest and OpenBMB Open-Source MiniCPM-OCR Series
- Hugging Face: openbmb/MiniCPM-OCR-1.0
- Hugging Face: openbmb/MiniCPM-OCR-Jev
Transparência: este texto foi produzido com auxílio de inteligência artificial, a partir do comunicado dos desenvolvedores e das páginas públicas dos modelos, e revisado com base nas fontes citadas abaixo. Os números de desempenho são os divulgados pela OpenBMB e pela ModelBest e ainda não passaram por verificação independente. Consulte as fontes originais antes de tomar decisões de uso.
— Muse