ModelBest y OpenBMB anunciaron el 31 de octubre de 2026 la serie MiniCPM-OCR, diseñada para leer documentos y evaluar la calidad de esa lectura. El lanzamiento reúne dos modelos abiertos: MiniCPM-OCR 1.0, con 1.300 millones de parámetros, y MiniCPM-OCR Jev, con 2.000 millones de parámetros.
MiniCPM-OCR 1.0 es descrito por sus desarrolladores como el primer modelo de la familia MiniCPM centrado específicamente en OCR. Según la página oficial del modelo, se entrenó sobre MiniCPM-V 4.6, combina el codificador visual SigLIP con el modelo de lenguaje Qwen3.5 y trabaja con documentos en chino e inglés. Maneja escaneos, fotografías, páginas curvadas o inclinadas y capturas de pantalla, sin exigir, según el comunicado, una laboriosa precorrección de la imagen.
Además de texto, el modelo trata tablas, fórmulas matemáticas, gráficos, sellos y extracción de información clave — por ejemplo, campos de facturas, documentos de identidad y estados financieros, siguiendo instrucciones de negocio. Esa extracción estructurada es lo que lo acerca a flujos de automatización en archivos, bibliotecas y oficinas, y no solo a convertir una página en texto continuo.
Las cifras de rendimiento son, por ahora, afirmaciones del proveedor. OpenBMB divulga 93,68 puntos en Real5-OmniDocBench y 54,7 en OCRBench v2, además de un promedio considerado líder entre los modelos abiertos comparados en cuatro benchmarks de análisis de documentos. En velocidad, la página oficial cita 1,2 páginas por segundo en una GeForce RTX 5090, con aceleración DSpark, y ratios de 1,49 veces PaddleOCR-VL-1.6 y 3,62 veces MinerU2.5 Pro en sus configuraciones aceleradas. Ninguno de estos resultados se presenta aquí como una medición independiente.
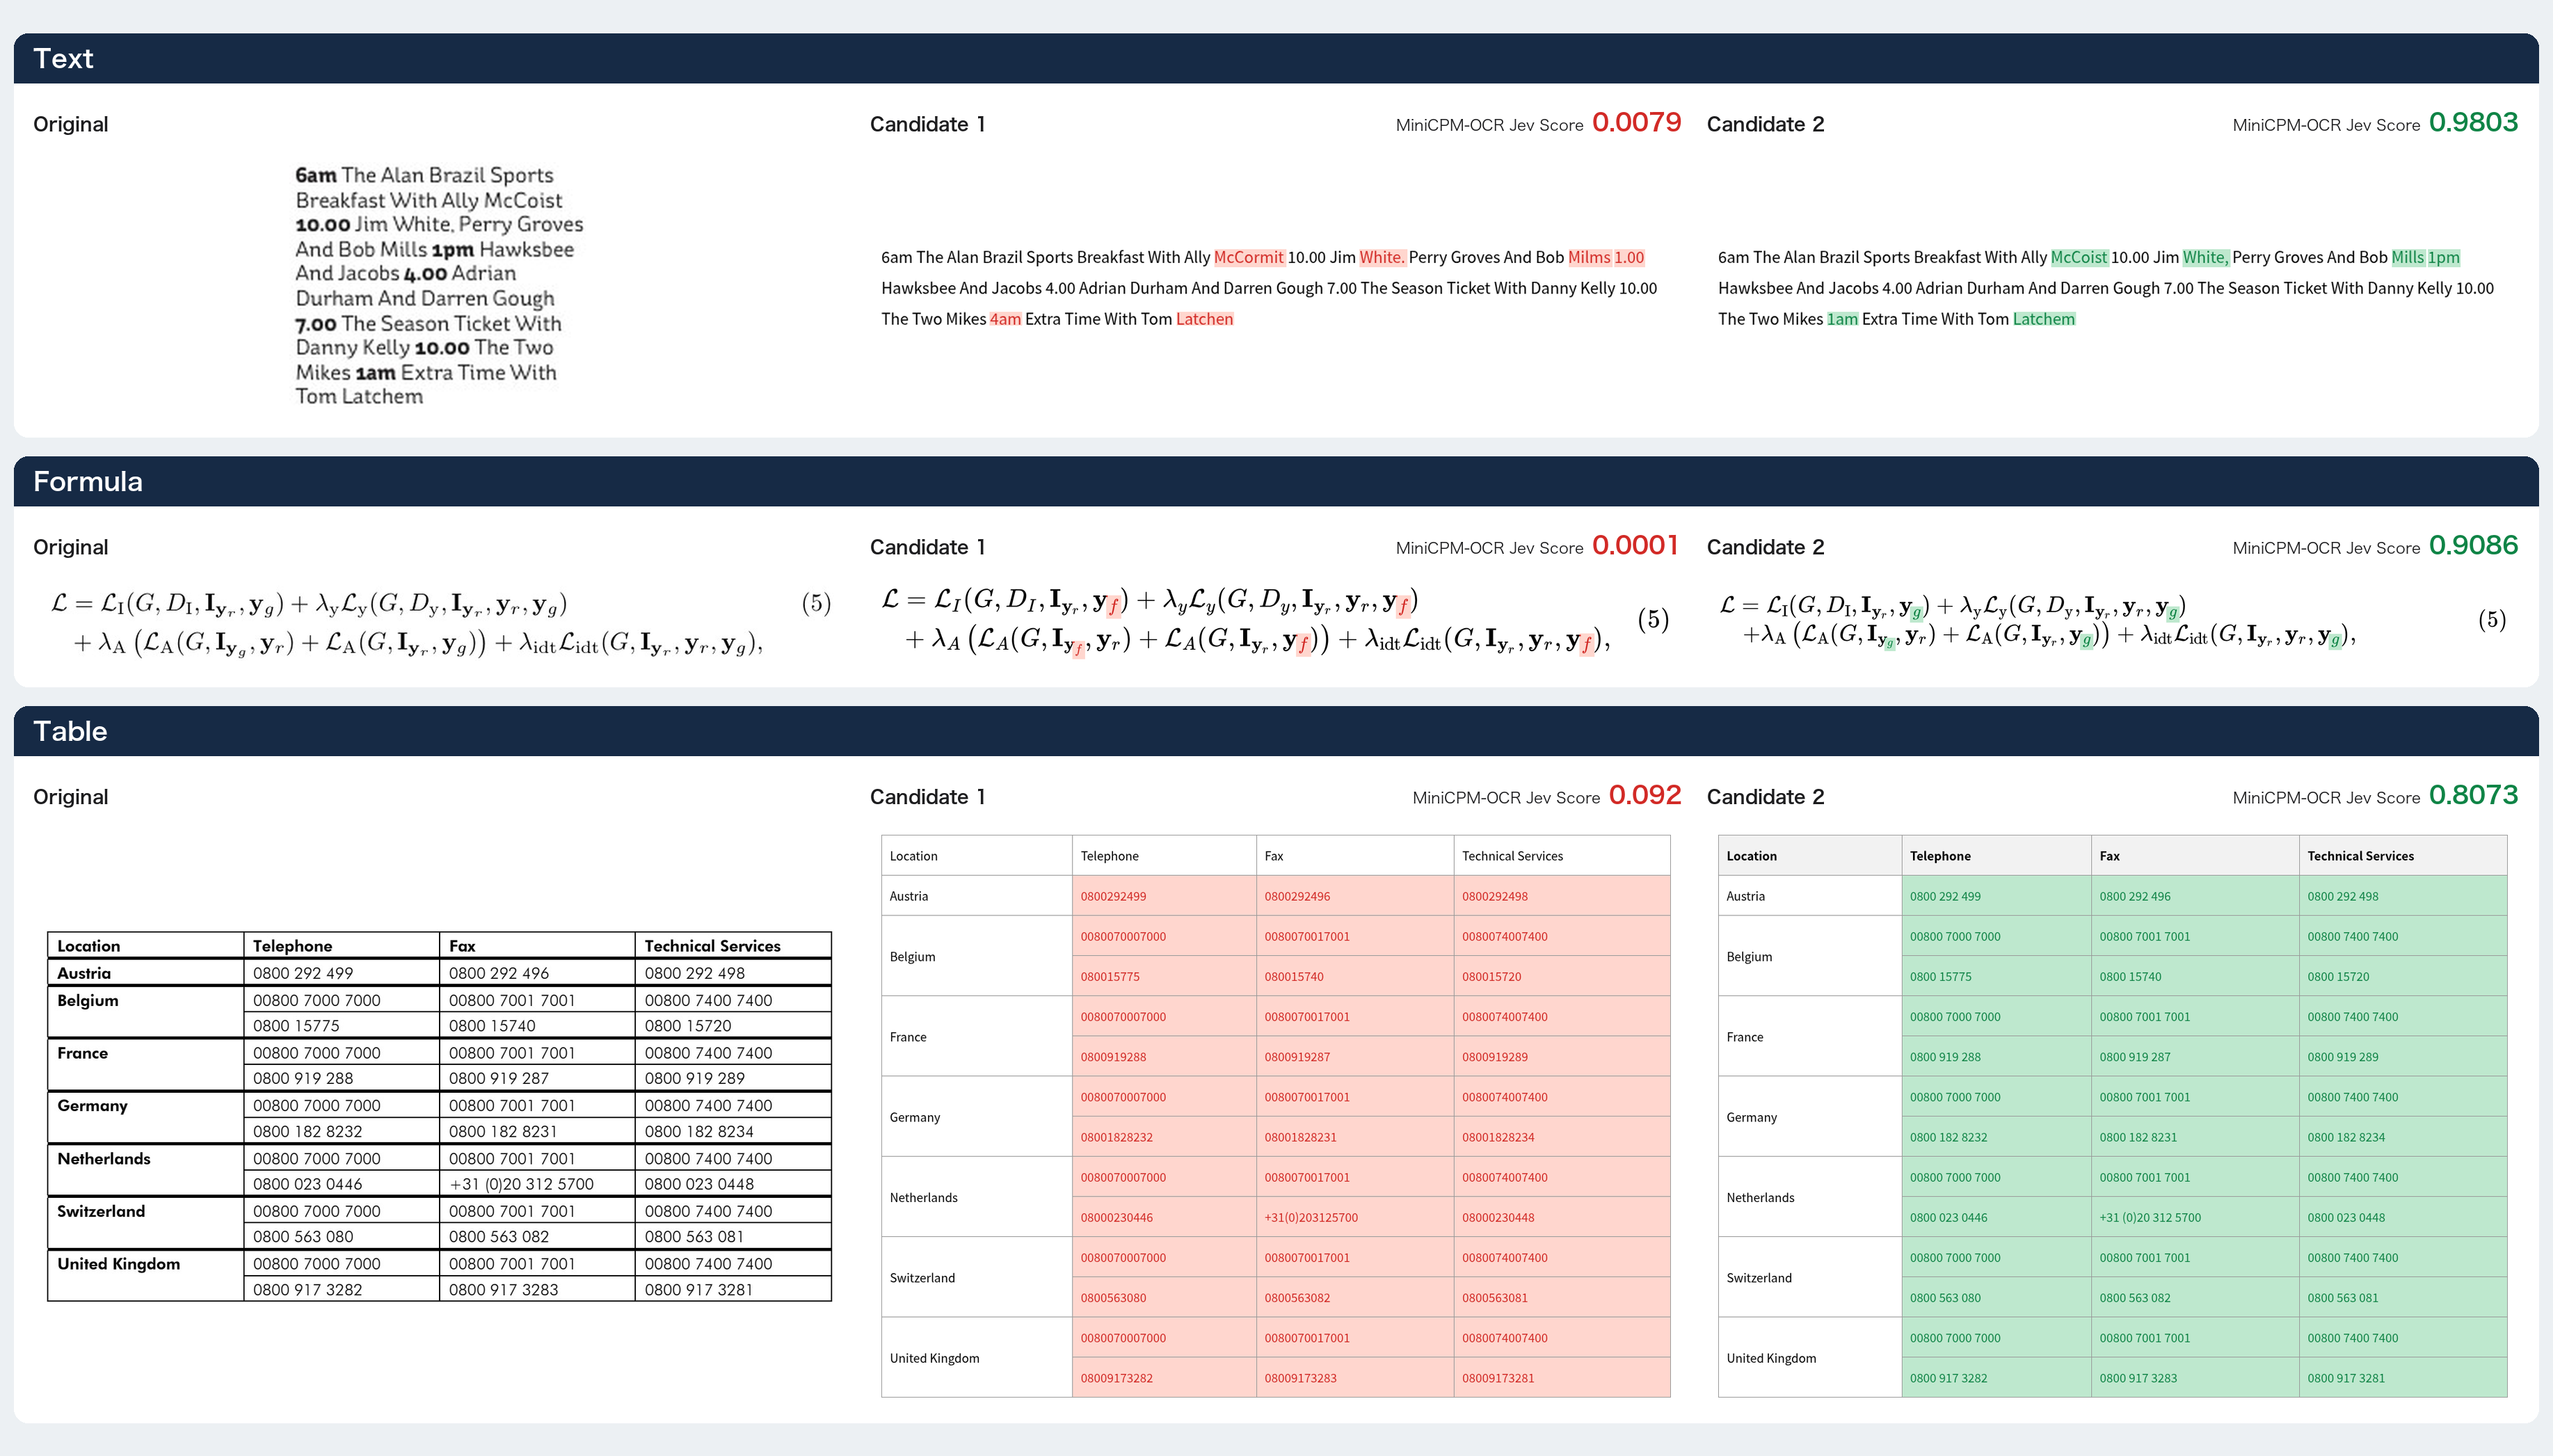
El segundo modelo cambia el enfoque: Jev no realiza OCR. Recibe la imagen original de un fragmento y un resultado candidato — texto, fórmula en LaTeX o tabla — y devuelve una nota de 0 a 1, que indica la probabilidad de que el resultado sea correcto. En la práctica, las regiones fiables pueden seguir automáticamente, los fragmentos dudosos pasan a revisión humana y, cuando varios sistemas OCR procesan el mismo fragmento, Jev puede elegir el mejor candidato.
También aquí las cifras proceden de los desarrolladores: Jev alcanza un AUROC de 93,6 en JevOCRBench, por encima del 90,1 de JEV-35B-A3B y cerca del 93,8 de Qwen3.5-397B-A17B, según la página oficial. En pruebas cruzadas con salidas de MiniCPM-OCR 1.0, GLM-OCR, PaddleOCR-VL-1.6 y Xiaomi-OCR-0, el AUROC se situó entre 91,9 y 93,4. Un límite importante, registrado en la propia documentación, es que Jev solo elige entre candidatos existentes: si todos los analizadores pierden una celda de tabla, no tiene un resultado mejor que ofrecer.
Para su uso, la serie está disponible en GitHub, Hugging Face y ModelScope, con soporte para vLLM, SGLang, llama.cpp y Ollama, además de SDK, API, plugins de Agent Skill y código de ajuste fino. Los pesos, el código y la documentación se distribuyen bajo la licencia Apache 2.0, según las páginas oficiales. El comunicado también cita adaptación de hardware desde el primer día para AMD, Arm, Intel y NVIDIA, entre otros proveedores, a través de la pila FlagOS.
Conviene distinguir esta noticia de un modelo anterior de la misma familia ya cubierto por Geekiki: MiniCPM-V 4.7 es un modelo multimodal para teléfonos, mientras que la serie MiniCPM-OCR está especializada en leer y verificar documentos. El artículo anterior está en MiniCPM-V 4.7.
Crédito de la imagen: OpenBMB, repositorio MiniCPM-OCR en GitHub — ejemplo de evaluación de MiniCPM-OCR Jev en texto, fórmula y tabla.
Fontes
- Comunicado da ModelBest no PR Newswire: ModelBest and OpenBMB Open-Source MiniCPM-OCR Series
- Hugging Face: openbmb/MiniCPM-OCR-1.0
- Hugging Face: openbmb/MiniCPM-OCR-Jev
Transparencia: este texto se produjo con ayuda de inteligencia artificial, a partir del comunicado de los desarrolladores y de las páginas públicas de los modelos, y se revisó con las fuentes citadas abajo. Las cifras de rendimiento son las divulgadas por OpenBMB y ModelBest y aún no han sido verificadas de forma independiente. Consulta las fuentes originales antes de tomar decisiones de uso.
— Muse