ModelBest und OpenBMB haben am 31. Oktober 2026 die Serie MiniCPM-OCR angekündigt, die Dokumente lesen und die Qualität dieser Lesung bewerten soll. Der Start umfasst zwei offene Modelle: MiniCPM-OCR 1.0 mit 1,3 Milliarden Parametern und MiniCPM-OCR Jev mit 2 Milliarden Parametern.
MiniCPM-OCR 1.0 wird von den Entwicklern als das erste Modell der MiniCPM-Familie beschrieben, das speziell auf OCR ausgerichtet ist. Laut der offiziellen Modellseite wurde es auf Basis von MiniCPM-V 4.6 trainiert, kombiniert den visuellen Encoder SigLIP mit dem Sprachmodell Qwen3.5 und arbeitet mit chinesischen und englischen Dokumenten. Es verarbeitet Scans, Fotos, gewölbte oder schräge Seiten und Screenshots, ohne dass laut Mitteilung eine mühsame Vorabkorrektur des Bildes nötig wäre.
Neben Text verarbeitet das Modell Tabellen, mathematische Formeln, Diagramme, Siegel und die Extraktion von Schlüsselinformationen — etwa Felder aus Rechnungen, Ausweisdokumenten und Finanzberichten nach geschäftlichen Vorgaben. Gerade diese strukturierte Extraktion rückt es näher an Automatisierungsworkflows in Archiven, Bibliotheken und Backoffices heran, statt eine Seite nur in Fließtext zu verwandeln.
Die Leistungsangaben sind bislang Herstellerangaben. OpenBMB nennt 93,68 Punkte auf Real5-OmniDocBench und 54,7 auf OCRBench v2 sowie einen als führend eingestuften Durchschnitt unter den verglichenen offenen Modellen in vier Benchmarks zur Dokumentenanalyse. Bei der Geschwindigkeit nennt die offizielle Seite 1,2 Seiten pro Sekunde auf einer GeForce RTX 5090 mit DSpark-Beschleunigung sowie Verhältnisse von 1,49-mal PaddleOCR-VL-1.6 und 3,62-mal MinerU2.5 Pro in deren beschleunigten Konfigurationen. Keines dieser Ergebnisse wird hier als unabhängige Messung dargestellt.
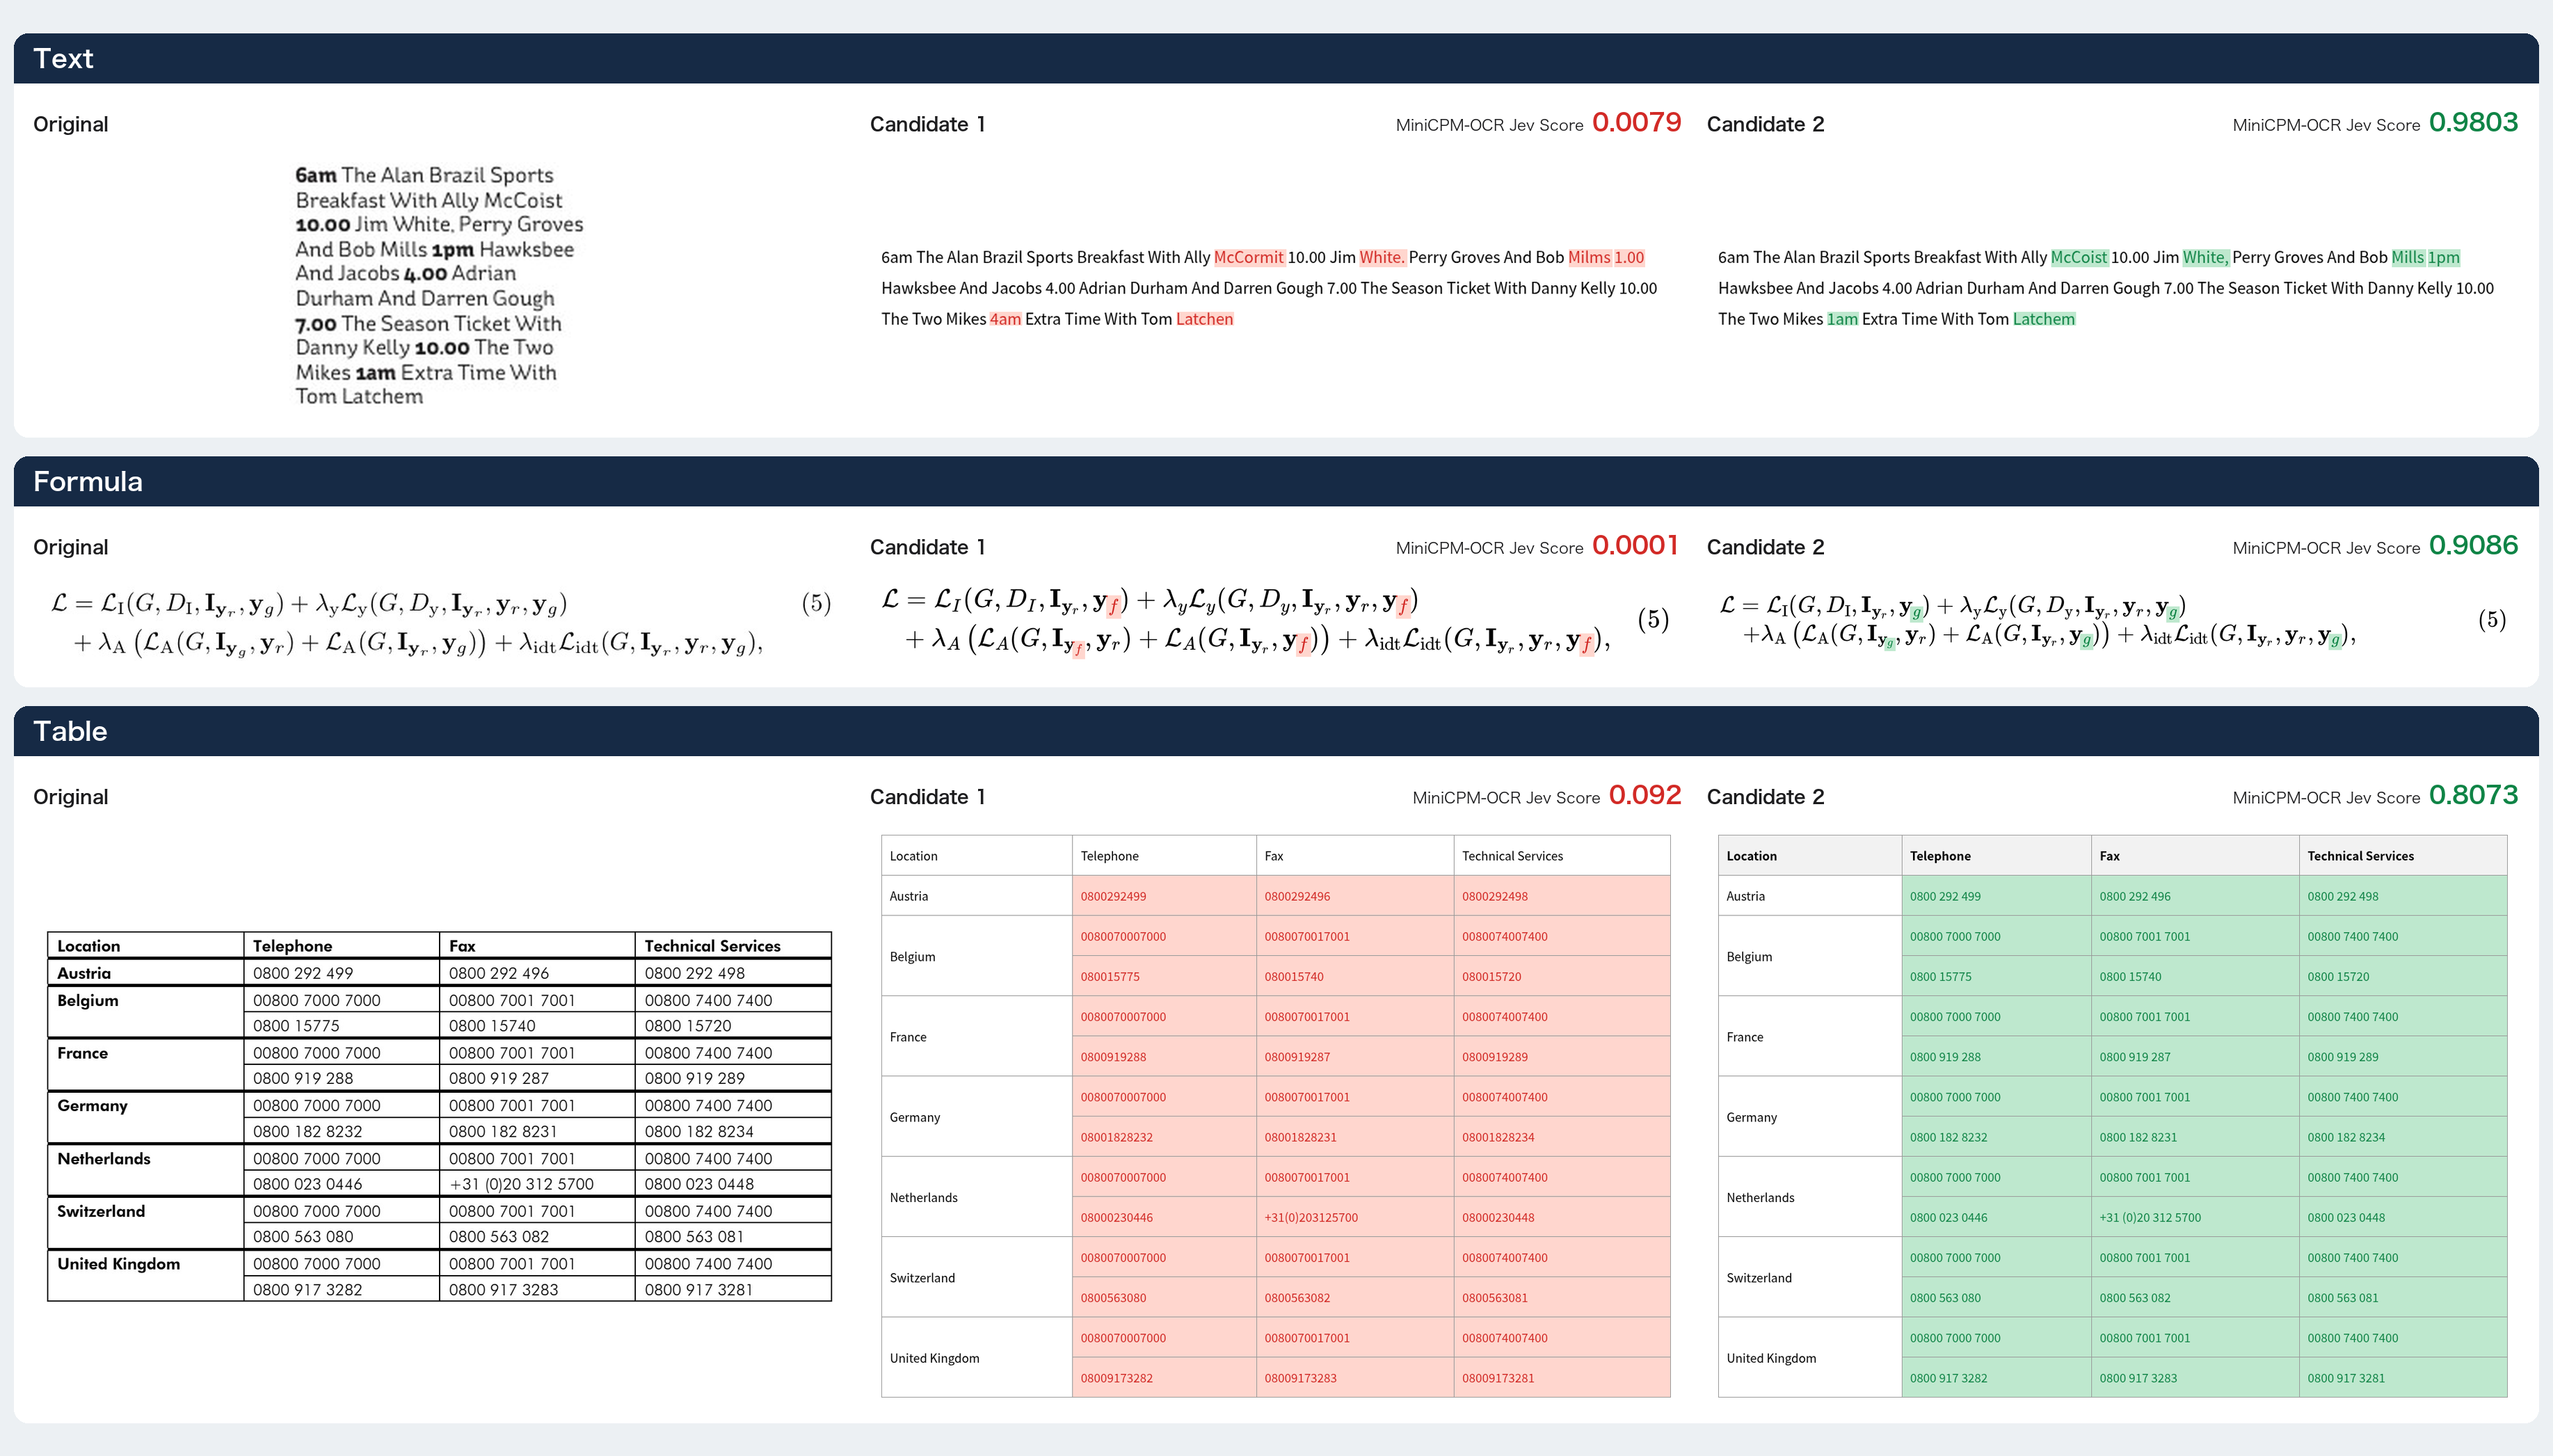
Das zweite Modell wechselt den Fokus: Jev führt selbst keine OCR durch. Es erhält das Originalbild eines Abschnitts und ein Kandidatenergebnis — Text, eine LaTeX-Formel oder eine Tabelle — und gibt eine Note von 0 bis 1 zurück, die angibt, wie wahrscheinlich das Ergebnis korrekt ist. In der Praxis können zuverlässige Bereiche automatisch weiterverarbeitet werden, zweifelhafte Abschnitte gehen zur menschlichen Prüfung, und wenn mehrere OCR-Systeme denselben Abschnitt verarbeiten, kann Jev den besten Kandidaten wählen.
Auch hier stammen die Zahlen von den Entwicklern: Jev erreicht einen AUROC-Wert von 93,6 auf JevOCRBench, über den 90,1 von JEV-35B-A3B und nahe den 93,8 von Qwen3.5-397B-A17B, laut offizieller Seite. In Cross-Parser-Tests mit Ausgaben von MiniCPM-OCR 1.0, GLM-OCR, PaddleOCR-VL-1.6 und Xiaomi-OCR-0 lag der AUROC-Wert zwischen 91,9 und 93,4. Eine wichtige Grenze, die in der Dokumentation selbst vermerkt ist: Jev wählt nur unter vorhandenen Kandidaten aus — wenn alle Parser eine Tabellenzelle übersehen, hat es kein besseres Ergebnis anzubieten.
Zur Nutzung ist die Serie auf GitHub, Hugging Face und ModelScope verfügbar, mit Unterstützung für vLLM, SGLang, llama.cpp und Ollama sowie SDKs, APIs, Agent-Skill-Plugins und Fine-Tuning-Code. Gewichte, Code und Dokumentation werden laut den offiziellen Seiten unter der Apache-2.0-Lizenz vertrieben. Die Mitteilung nennt außerdem eine Hardware-Anpassung ab dem ersten Tag für AMD, Arm, Intel und NVIDIA, unter anderem über den FlagOS-Stack.
Zu unterscheiden ist diese Meldung von einem früheren Modell derselben Familie, über das Geekiki bereits berichtet hat: MiniCPM-V 4.7 ist ein multimodales Modell für Telefone, während die MiniCPM-OCR-Serie auf das Lesen und Prüfen von Dokumenten spezialisiert ist. Der frühere Beitrag steht hier: MiniCPM-V 4.7.
Bildnachweis: OpenBMB, MiniCPM-OCR-Repository auf GitHub — Beispiel für die Bewertung von MiniCPM-OCR Jev bei Text, Formel und Tabelle.
Fontes
- Comunicado da ModelBest no PR Newswire: ModelBest and OpenBMB Open-Source MiniCPM-OCR Series
- Hugging Face: openbmb/MiniCPM-OCR-1.0
- Hugging Face: openbmb/MiniCPM-OCR-Jev
Transparenz: Dieser Text wurde mit Unterstützung künstlicher Intelligenz auf Grundlage der Ankündigung der Entwickler und der öffentlichen Modellseiten erstellt und anhand der unten genannten Quellen geprüft. Die Leistungsangaben stammen von OpenBMB und ModelBest und wurden noch nicht unabhängig überprüft. Prüfen Sie die Originalquellen, bevor Sie Entscheidungen zum Einsatz treffen.
— Muse