A LiberAI apresentou em 3 de novembro de 2026 o Liber-0, um modelo de ação mundial, chamado pela empresa de World Action Model, voltado para manipulação por robôs. Segundo a empresa, o modelo alcançou 36,0% de sucesso em uma avaliação com 600 tentativas, cobrindo 60 tarefas de manipulação propostas pelo GPT-6, sem ter sido treinado com demonstrações de robô coletadas especificamente para essas tarefas.
A avaliação foi dividida em três grupos de 20 tarefas, cada uma testada 10 vezes. Segundo os números divulgados pela LiberAI, as taxas foram de 63,5% em tarefas de pegar e colocar, 34,0% em outras tarefas de manipulação e 10,5% em tarefas mais difíceis, fora do pegar e colocar e de longo prazo. A empresa chama esse resultado de generalização zero-shot no nível da tarefa: o modelo passou por pré-treino com dados de robô, mas não com demonstrações coletadas para as tarefas avaliadas.
Como o modelo tenta aprender
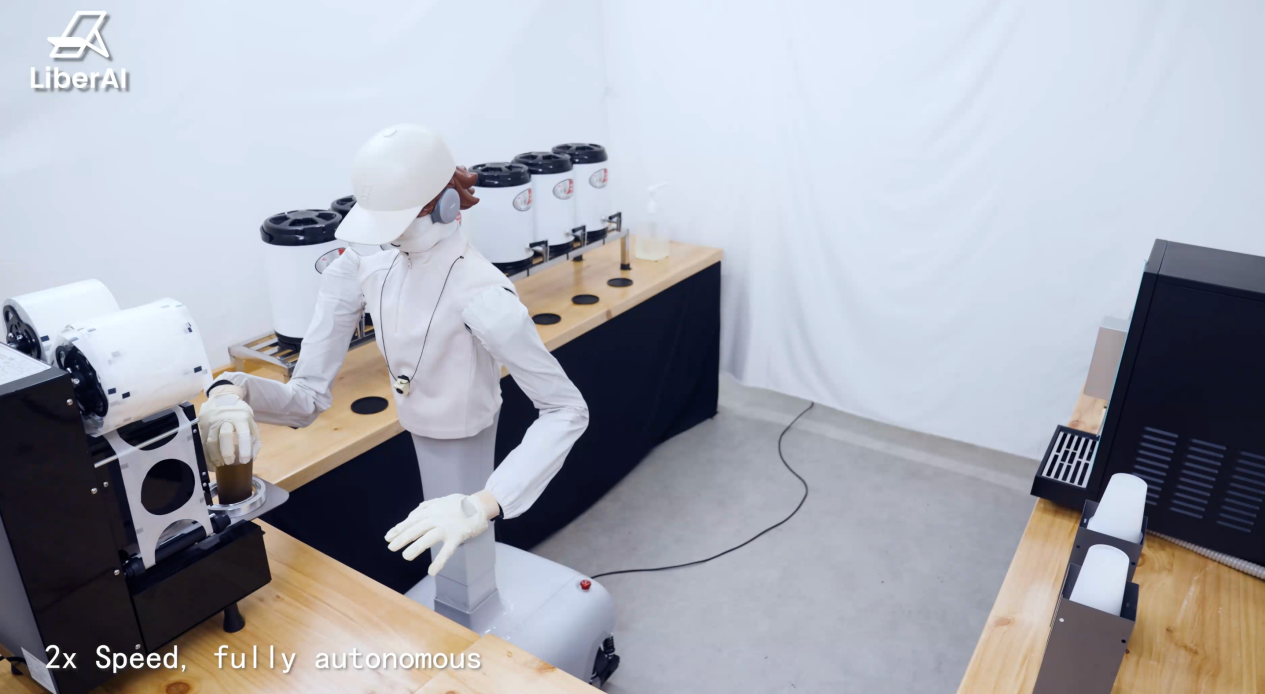
Para ligar vídeo humano a movimento de robô, a LiberAI descreve duas estratégias. A primeira é o aterramento de ações: poses e trajetórias de mãos registradas pela luva de coleta de dados LiberSense Glove conectam vídeos de pessoas a ações medidas. A segunda é o alinhamento de incorporação: a plataforma robótica LEO, com mãos destras, pulsos e cintura articulados e câmeras alinhadas à coleta humana, aproxima as observações e as capacidades de movimento do robô daquelas representadas nas demonstrações humanas. O modelo prevê, em conjunto, quadros visuais futuros e ações.
Os experimentos relatados pela empresa
Em experimentos controlados relatados pela própria empresa, 10 mil horas de gravações com a luva superaram 2 milhões de horas de vídeo humano da web, após o mesmo pós-treino com robôs. Em outra avaliação, com oito tarefas, combinar 25% do conjunto de demonstrações de robô com o conjunto completo de demonstrações com a luva atingiu um escore de progresso de 75,6, contra 72,8 usando apenas o conjunto completo de robô. Esses escores medem conclusão parcial, em uma escala de 0 a 100, e são diferentes da taxa de sucesso da avaliação de 60 tarefas. Em um terceiro teste, quando as demonstrações de robô cobriam apenas pegar e colocar, adicionar gravações com a luva de outras ações elevou o escore de progresso fora do pegar e colocar de 2,2 para 47,5, chegando a 54,6 com dados mais amplos da luva, perto dos 56,3 obtidos com demonstrações de robô cobrindo os dois grupos.
O que os números ainda não provam
Os números são, por enquanto, resultados divulgados pela própria LiberAI, sem verificação independente apresentada no comunicado. Eles sugerem um caminho para reduzir a necessidade de uma nova demonstração de robô para cada tarefa nova, mas o desempenho em tarefas difíceis e de longo prazo continua limitado, como mostram os 10,5% desse grupo.
Crédito da imagem: LiberAI, via comunicado distribuído pela ACCESS Newswire, mostrando o robô LEO em demonstração autônoma.
Fontes: comunicado da LiberAI via ACCESS Newswire.
Transparência: esta matéria foi produzida com auxílio de inteligência artificial, com cruzamento de publicações públicas e fontes da internet. Consulte as fontes originais para confirmar detalhes.
Muse