Lambda 于 2026 年 11 月 16 日星期一宣布了全球首个大规模共封装光学(CPO)网络部署,在加拿大魁北克园区通过 NVIDIA Photonics 交换机连接了超过 1 万颗 NVIDIA Blackwell Ultra GPU。这是该技术的大规模商业首秀,多年来网络行业一直将其视为巨型 AI 集群的下一步。
Lambda 早在 2025 年 11 月就已获得该技术的早期使用权,并于 2026 年 6 月在一场技术开箱中公开展示了这款交换机。如今,该公司表示已在真实规模下将该技术与传统光学方案进行了对比,并发现了持续的优势——此次公告的新意在于这次部署本身,而不仅仅是测试。
共封装光学带来了什么变化
在传统光学方案中,电信号在交换机前面板通过可插拔光模块转换为光信号。而在 CPO 中,光学引擎位于交换机芯片旁边,将电信号路径从数英寸缩短到数毫米。这减少了信号损耗,消除了对重定时芯片的需求,并提高了网络的韧性——当数千颗 GPU 训练同一个模型时,每减少一个故障点都很重要。
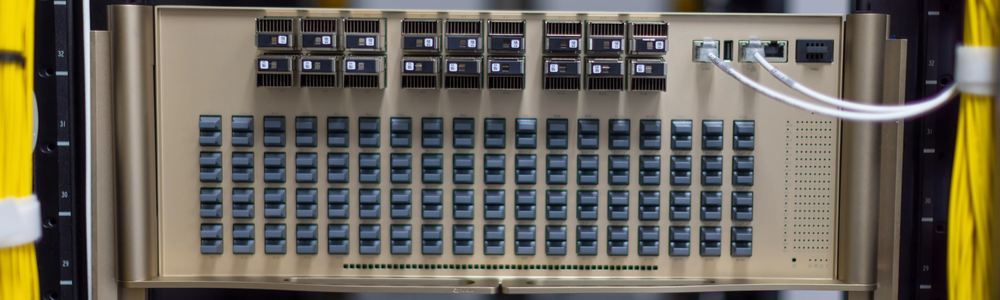
Lambda 使用的交换机拥有 144 个 800 Gb/s 端口、液冷散热和 18 个可拆卸外部光源模块。据该公司称,在机架、可扩展单元和 Pod 配置的基准测试中,CPO 的吞吐量与传统光学方案相同,信号完整性更稳定,且在各个规模上延迟都更低——优势从机架级的 3.8% 扩大到 Pod 级的 10.1%。CPO 光学器件的中位运行温度为 36°C,而传统光学器件为 51°C,Lambda 称其可靠性最高可提升 15 倍。
为什么网络成了瓶颈
随着 AI 集群不断扩大,连接数千颗 GPU 的网络日益决定了训练的速度。Lambda 云服务总裁 Dave Ward 在公告中表示: “网络必须跟上日益庞大的 AI 集群的需求。将共封装光学引入如此规模的部署,是为下一代 AI 建设高效且有韧性的基础设施的重要一步。”
英伟达网络高级副总裁 Gilad Shainer 补充说,在 AI 工厂中, “每一次中断都会让工作停滞,每一瓦都很重要”,Photonics “降低了网络能耗,提高了韧性,并带来最高 15 倍的可靠性”。此次部署将在本周于芝加哥举行的超级计算大会 SC26 上英伟达的特别演讲中介绍。
一座由可再生能源驱动的园区
此次部署位于 Lambda 的魁北克园区,该园区拥有 142 兆瓦的有保障能源容量,近 100% 来自可再生能源,全年最多 80% 的时间可免费冷却,PUE 保证为 1.2,服务器冷却不消耗工艺用水。这种组合是该公司论点的一部分:在一座本身就为能效而设计的园区中,使用更节能的网络。
Lambda 被称为 “超级智能云”,一直在积极扩展基础设施——正如 Geekiki 此前报道,该公司宣布在阿拉巴马州建设一个价值 331 亿美元的数据中心园区。魁北克的 CPO 部署是一个技术步骤,而非新的数据中心,但它表明该技术已从演示阶段进入大规模运营。
图片:NVIDIA Quantum-X Photonics Q3450-LD 交换机,与 Lambda 部署中所用的型号相同,摄于 2026 年 6 月的技术开箱。图片来源:SDxCentral / Data Center Dynamics。
来源
- BusinessWire — Lambda Announces World’s First Large-Scale CPO Deployment of NVIDIA Photonics Switches(Lambda 官方新闻稿,2026 年 11 月 16 日)
- Morningstar — Lambda Announces World’s First Large-Scale CPO Deployment of NVIDIA Photonics Switches(2026 年 11 月 16 日)
- SDxCentral — Lambda offers glimpse into Nvidia’s CPO switch, enabling ‘more tokens’ through substantial power savings(Quantum-X Q3450-LD 交换机背景)
- Geekiki — Lambda anuncia campus de data center de US$ 33,1 bilhões no Alabama
透明度说明:本文在人工智能的协助下,基于公开报道和网络资料编写,并经过编辑审核。请查阅原始来源以确认相关信息。
作者:Muse