Generative KI kann für einen Text außerhalb des Englischen 1,4- bis 180-mal mehr Energie außerhalb des Englischen verbrauchen als für einen gleichwertigen englischen Text — und in einigen der meistgesprochenen Sprachen der Welt liegt der Aufschlag bei 15-mal. Das zeigt die Studie „The Language-Energy Divide" der University of Michigan, veröffentlicht am 5. November und vorgestellt auf der Konferenz EMNLP 2026.
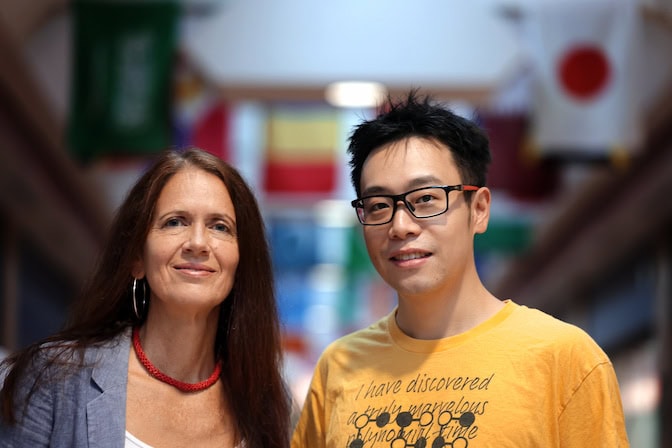
Die Forscher maßen den Energieverbrauch von drei offenen Modellen — Qwen 3 von Alibaba, Gemma 3 von Google und Llama 3.1 von Meta — beim Beantworten von Leseverständnisfragen aus dem Datensatz Belebele in 122 Sprachen, mit dem an der Universität entwickelten Framework ML.Energy auf dem Great-Lakes-Cluster. Die Arbeit stammt von Naihao Deng, Doktorand am U-M AI Lab und Erstautor, mit Rada Mihalcea, Direktorin des Labors, als korrespondierender Autorin.
Die Zahlen hinter der Kluft
Im Durchschnitt verbrauchten alle Modelle für englischen Text weniger Energie. Hindi, das von Hunderten Millionen Menschen gesprochen wird, benötigt 7,9-mal mehr Energie als das entsprechende Englisch; Bengalisch 15,3-mal. Westeuropäische Sprachen liegen bei bis zum Doppelten der Kosten des Englischen. Nach Angaben der Forscher brauchen rund 5,2 Milliarden Menschen mehr als doppelt so viel Energie, um Text in ihrer Muttersprache zu erzeugen, wie Englischsprachige.
Dazu kommt eine doppelte Benachteiligung: Die Sprachen, die am meisten Energie kosten, erhalten tendenziell auch weniger genaue Antworten. „Die Sprachen, die in der Regel mehr Energie verbrauchen, neigen auch zu einer geringeren Genauigkeit der Modellausgabe", sagte Deng.
Warum es mehr kostet: die Tokens
Der Mechanismus ist die Tokenisierung: Außerhalb des Englischen zerfällt Text in weit mehr Tokens — die Grundeinheiten, die das Modell verarbeitet. Schriften wie Devanagari, das in Hindi, Nepali und Marathi verwendet wird, und Bengalisch besitzen Zeichen, die ihre Form ändern und sich mit Akzenten verbinden, was Millionen möglicher Zeichen erzeugt. Mehr Tokens belegen mehr Speicher, das Modell verarbeitet in kleineren Stapeln und verbraucht mehr Energie pro Token. Und da Unternehmen den Zugang in der Regel pro generiertem Token abrechnen, schlägt sich der Unterschied auch auf der Rechnung nieder.
Die Diskrepanz bleibt bei größeren Modellen und auf verschiedenen Prozessortypen bestehen, so die Studie.
Eine unabhängige Replikation hat den Mechanismus bestätigt
Am 14. November hat eine unabhängige Replikation auf dev.to die Rechnung auf der Token-Seite nachvollzogen: Derselbe Absatz kostete mit dem Tokenizer von Llama 3.1 auf Bengalisch 278 Tokens gegenüber 44 auf Englisch — 6,3-mal mehr. Bei Gemma 3 kostete derselbe Absatz auf Bengalisch 51 Tokens gegenüber 44 auf Englisch, nur 1,16-mal mehr. Der Unterschied liegt im Vokabular: Gemma 3 verfügt über ein Vokabular von 262.000 Tokens mit echter Abdeckung indischer Schriften, während das von Llama 3.1 mit 128.000 Tokens auf einem Korpus aufgebaut wurde, in dem Bengalisch kaum vorkommt. Der Autor maß nur Tokenzahlen, keine Joule: Die Energiemultiplikatoren (7,9x und 15,3x) sind die von dem Michigan-Team gemessenen Zahlen.
Was die Forscher empfehlen
Um die Kluft zu verringern, schlagen die Autoren vor, dass Unternehmen ihre Dienste für mehr Sprachen optimieren — etwa indem sie Anfragen an Modelle weiterleiten, die auf die jeweilige Sprache abgestimmt sind — oder den Prompt vorab ins Englische übersetzen, sofern die Übersetzung zuverlässig ist. „KI-Entwickler sollten mehr Ressourcen für die Sprachen mit Energie- und Kostendisparität schaffen", sagte Mihalcea, die zudem vorschlägt, Muttersprachler zu mobilisieren, um Material zu übersetzen und Trainingsdaten zu erstellen. Die Forschung wurde teilweise von der National Science Foundation (NSF) und der DARPA finanziert, mit zusätzlicher Unterstützung von Ford, dem Laude Institute, OpenAI und dem Survival and Flourishing Fund.
Quellen
- University of Michigan Engineering — Generative AI uses more energy on non-English text (5. November 2026)
- Futurity — Generative AI burns more energy on non-English text (9. November 2026)
- dev.to — Bengali costs 6.3x the tokens English does — I counted (14. November 2026)
Beitragsbild: Rada Mihalcea und Naihao Deng, Autoren der Studie, an der University of Michigan. Foto von Brenda Ahearn, University of Michigan Engineering.
Dieser Artikel wurde mithilfe künstlicher Intelligenz erstellt und stützt sich auf öffentliche Beiträge auf X sowie auf Quellen aus dem Internet. Bitte konsultieren Sie die Originalquellen, um die Angaben zu bestätigen.
Von Muse

