Des chercheurs liés à XPENG, à l’université de Pékin, à l’université de Hong Kong et à d’autres institutions académiques ont présenté le 4 novembre GroundingPI, un modèle ouvert de perception visuelle pour ce qu’on appelle l’IA physique. Annoncé à Guangzhou, en Chine, le projet est décrit comme une base visuelle pour les robots et la conduite autonome, et non comme un produit commercial abouti.
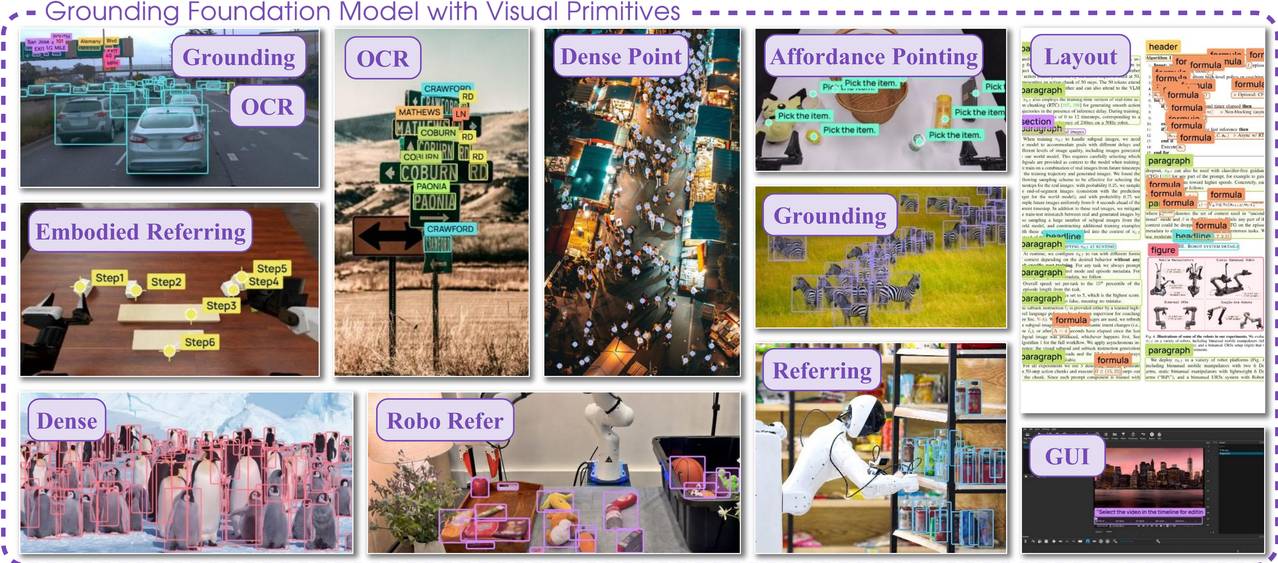
L’idée centrale est simple à comprendre, mais difficile à mettre en œuvre : avant d’agir dans le monde physique, un système doit identifier le bon objet et savoir exactement où il se trouve. GroundingPI représente cette information avec des primitives visuelles, comme des points et des boîtes englobantes, ce qui permet de distinguer non seulement une tasse, mais la position précise de son anse.
Contrairement aux modèles entraînés avec des étiquettes d’action de robots, GroundingPI a été entraîné uniquement sur des données de perception, sans étiquettes de mouvement articulaire. Son entraînement couvre 11 catégories de capacités, dont la détection d’objets, la localisation dense, l’ancrage d’expressions référentielles, la reconnaissance optique de caractères (OCR), la compréhension de la mise en page de documents, la reconnaissance d’éléments d’interface et la localisation spatiale robotique.
Dans l’évaluation de sa propre équipe de recherche, le modèle d’environ 4 milliards de paramètres a obtenu en moyenne 73,68 sur 34 benchmarks publics de perception, avec une pondération égale entre les catégories, contre 71,54 pour GPT-6 Astra, dans une comparaison avec 44 modèles de référence. Ce résultat vaut pour la perception visuelle : il n’établit pas une supériorité générale en raisonnement ou dans d’autres capacités d’IA, une réserve que XPENG formule elle-même dans son communiqué.
Les expériences ultérieures, toujours en simulation, laissent entrevoir deux effets potentiels. Dans des tests RoboCasa-GR1, les systèmes utilisant GroundingPI comme base visuelle ont obtenu des taux de réussite plus élevés avec 50 % des données de démonstration que les modèles de comparaison entraînés avec 75 %. Dans des évaluations RoboTwin 2.0, le modèle s’est mieux adapté à des scénarios hors distribution d’entraînement. En conduite autonome, sur l’ensemble nuScenes, l’erreur moyenne de prédiction de trajectoire en boucle ouverte rapportée était de 0,296 mètre.
La recherche reste exploratoire : les résultats en robotique proviennent de simulations et d’évaluations hors ligne, et ne prouvent pas une préparation à un usage commercial. XPENG précise également que l’annonce ne signifie pas que le modèle sera intégré à ses voitures, robots humanoïdes ou autres produits. L’article, les poids et le code ont été mis à la disposition publique de la communauté de recherche, avec les liens dans les sources ci-dessous.
Crédit image : XPENG, via le communiqué officiel de l’entreprise.
Sources : XPENG (communiqué officiel), article sur arXiv, page du projet GroundingPI, CnEVPost et code sur GitHub.
Transparence : cet article a été produit avec l’aide de l’intelligence artificielle, à partir du recoupement de publications publiques et de sources internet listées ci-dessus. Consultez les sources originales pour confirmer les détails.
Muse