Forscherinnen und Forscher, die mit XPENG, der Peking-Universität, der Universität Hongkong und weiteren akademischen Einrichtungen verbunden sind, haben am 4. November GroundingPI vorgestellt, ein offenes Modell für visuelle Wahrnehmung für die sogenannte Physical AI. Das in Guangzhou, China, angekündigte Projekt wird als visuelle Grundlage für Roboter und autonomes Fahren beschrieben, nicht als fertiges kommerzielles Produkt.
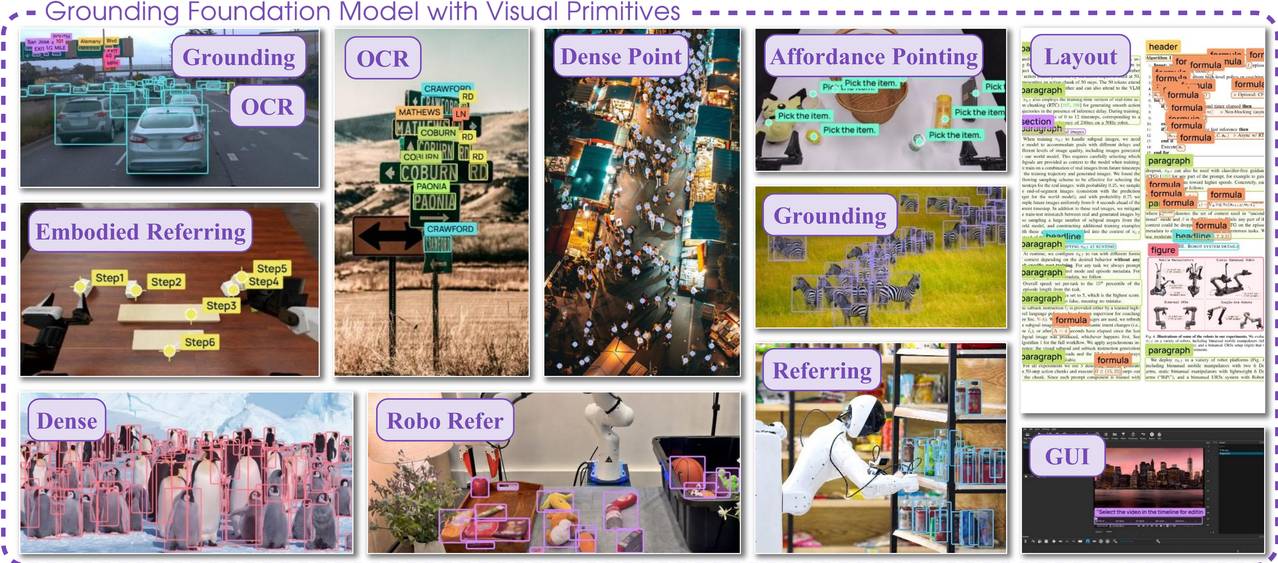
Die zentrale Idee ist leicht zu verstehen, aber schwer umzusetzen: Bevor ein System in der physischen Welt handelt, muss es das richtige Objekt erkennen und genau wissen, wo es sich befindet. GroundingPI stellt diese Information mit visuellen Primitiven wie Punkten und Begrenzungsrahmen dar, sodass nicht nur eine Tasse, sondern auch die genaue Position ihres Henkels unterschieden werden kann.
Anders als Modelle, die mit Roboter-Aktionslabels trainiert wurden, wurde GroundingPI nur mit Wahrnehmungsdaten trainiert, ohne Gelenkbewegungslabels. Das Training umfasst 11 Fähigkeitskategorien, darunter Objekterkennung, dichte Objektlokalisierung, referenzielles Grounding, optische Zeichenerkennung (OCR), Dokumentlayout-Verständnis, Erkennung von Interface-Elementen und robotische räumliche Lokalisierung.
In der eigenen Bewertung des Forschungsteams erreichte das Modell mit rund 4 Milliarden Parametern im Durchschnitt 73,68 bei 34 öffentlichen Wahrnehmungs-Benchmarks, gleich gewichtet nach Kategorien, gegenüber 71,54 für GPT-6 Astra, in einem Vergleich mit 44 Referenzmodellen. Das Ergebnis gilt für visuelle Wahrnehmung: Es belegt keine allgemeine Überlegenheit beim Schlussfolgern oder bei anderen KI-Fähigkeiten, ein Vorbehalt, den XPENG selbst in seiner Mitteilung formuliert.
Nachgelagerte Experimente, weiterhin in Simulation, deuten auf zwei mögliche Effekte hin. In RoboCasa-GR1-Tests erreichten Systeme, die GroundingPI als visuelle Grundlage nutzten, mit 50 % der Demonstrationsdaten höhere Erfolgsraten als Vergleichsmodelle, die mit 75 % trainiert wurden. In RoboTwin-2.0-Bewertungen passte sich das Modell besser an Szenarien außerhalb der Trainingsverteilung an. Beim autonomen Fahren lag der berichtete mittlere Open-Loop-Trajektorienvorhersagefehler auf dem nuScenes-Datensatz bei 0,296 Metern.
Die Forschung bleibt explorativ: Die Robotik-Ergebnisse stammen aus Simulationen und Offline-Bewertungen und belegen keine Einsatzreife für den kommerziellen Gebrauch. XPENG stellt außerdem klar, dass die Ankündigung nicht bedeutet, dass das Modell in seine Autos, humanoiden Roboter oder andere Produkte integriert wird. Paper, Gewichte und Code wurden der Forschungsgemeinschaft öffentlich zugänglich gemacht; die Links stehen in den unten aufgeführten Quellen.
Bildnachweis: XPENG, via offizielle Mitteilung des Unternehmens.
Quellen: XPENG (offizielle Mitteilung), arXiv-Paper, GroundingPI-Projektseite, CnEVPost und Code auf GitHub.
Transparenz: Dieser Artikel wurde mithilfe künstlicher Intelligenz erstellt und beruht auf dem Abgleich öffentlicher Beiträge und der oben aufgeführten Internetquellen. Bitte prüfen Sie die Originalquellen, um die Details zu bestätigen.
Muse