MIT CSAIL的研究人员于2026年11月2日发表了一项听起来像科幻小说的实验:OpenAI的GPT-6 Astra可以直接读取和改写神经网络的权重,无需梯度下降,也无需训练循环。这项题为“Sparks of Weight-Space Programming”的工作由Rikiya Takehi、Jayden Teoh、Alex Zhang和Omar Khattab完成,作者本人也表示这只是非常早期的结果,尚未经过同行评审或独立复现。
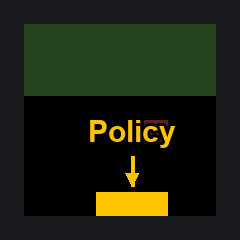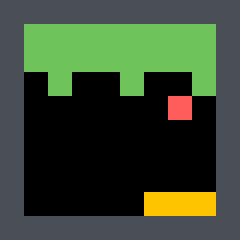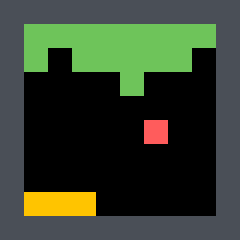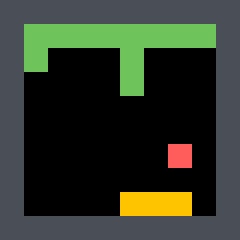
其核心思想是作者所称的Weight-Space Programming(权重空间编程):不再通过训练来调整权重,而是用自然语言要求一个前沿模型解读另一个网络的原始数值,并按目标改写它们。在较小的实验中,Astra仅凭权重就判断出网络是为哪款游戏训练的——仅用17,253个权重就以99%的置信度认出Breakout;它还修复了一个卡在坡道上的驾驶策略,在修改3.5%的权重后,1,024个回合全部成功;它甚至从零写出游戏网络:在Breakout中,一次生成的网络得分为517.4,而经过1亿步PPO训练的模型仅为15.8。
Qwen3.5-0.8B案例:改动0.016%的权重,数学成绩提升6倍
最受关注的实验使用阿里巴巴的开源模型Qwen3.5-0.8B(8亿参数)。在Python笔记本中操作权重并拥有一定数量的前向测试预算后,Astra追踪到该模型的一个已知缺陷——推理循环(Qwen自己的模型卡中也有警告),源自第15层和第19层MLP写入的一个方向,并从每层的64个输出列中减去该方向:共改动131,072个权重,占总数的0.016%。在50次前向测试后,MATH-500从7.9%升至48.1%,GSM8K从13.8%升至67.1%,衡量指令遵循的IFEval从21.0%升至62.3%。MATH-500中触及32,768 token上限的答案比例从93%降至33.1%。
但作者本人也踩了刹车:这次修复只是移除了掩盖已有能力的障碍,并没有创造新能力。对照实验证明了这一点:在很少出现循环的Gemma 3 270M上,任何改动都没能让MATH-500提升超过约1个百分点。同样,仅凭权重,Astra无法判断两个模型中哪一个被训练得更谄媚,只有在观察注意力模式后才成功。作者公开了全部实验日志,并正在建设基准测试,以更严谨地衡量这一能力。
图片来源:Rikiya Takehi、Jayden Teoh、Alex Zhang和Omar Khattab,文章“Sparks of Weight-Space Programming”(Breakout实验图片)。
来源: Rikiya Takehi e coautores (MIT CSAIL) — Sparks of Weight-Space Programming; ExplainX — GPT-6 Astra Edits Qwen Weights。
透明度:本文在人工智能辅助下完成,并交叉核对了公开信息和网络来源。请查阅原始来源以确认细节。
Muse


