Google a annoncé ce lundi 9 novembre 2026 deux nouveaux systèmes de la huitième génération de TPU : le TPU 8tx, dédié à l'inférence sécurisée et confidentielle, et le TPU 8i Max, conçu pour les fenêtres de contexte gigantesques et la plus forte densité de calcul par rack de la gamme. Avec eux, l'entreprise atteint quatre systèmes TPU lancés en une seule année, une première dans l'histoire de la plateforme.
En avril, lors du Google Cloud Next, l'entreprise avait déjà présenté le TPU 8t, pour l'entraînement à grande échelle, et le TPU 8i, pour le raisonnement en temps réel, avec jusqu'à 2,7 fois plus de performances d'entraînement et un rapport prix-performance en inférence supérieur de 80 % à celui de la génération précédente. Le TPU 8i réduit aussi de moitié les délais de communication entre puces. Les deux nouveaux systèmes reposent sur le même silicium et le spécialisent pour deux défis qui ont grandi avec les agents autonomes d'IA : la sécurité des données et l'échelle du contexte.
TPU 8tx : l'inférence confidentielle directement dans le matériel
Le TPU 8tx a été créé pour les entreprises réglementées et les gouvernements qui exécutent des modèles de pointe ou propriétaires aux côtés de leurs données les plus sensibles. Construit sur le même silicium que le TPU 8t et associé à des hôtes équipés de CPU AMD EPYC de 5e génération, le système protège les données et les poids du modèle directement dans le matériel, en les gardant isolés même pendant l'utilisation active — normalement, les données doivent être déchiffrées en mémoire pendant leur traitement.
Selon Google, le 8tx adopte aussi le réseau à faible latence Boardfly, créé pour le raisonnement en temps réel, et offre une latence jusqu'à deux fois inférieure à celle du TPU 8t, avec une pénalité de performance quasi nulle. Comme il réunit un calcul de niveau entraînement et un réseau d'inférence rapide dans un seul système, il permet d'ajuster des modèles avec des données privées, de distiller de grands modèles en modèles plus petits et d'entraîner des agents par apprentissage par renforcement sans déplacer de données sensibles entre des clusters séparés.
TPU 8i Max : le double de calcul et de mémoire par boîtier
Le TPU 8i Max s'attaque à un autre goulot d'étranglement : la mémoire. Quand des dizaines d'agents d'IA travaillent ensemble sur une base de code entière ou des heures de vidéo, la bande passante mémoire devient la limite. Pour y répondre, Google a combiné deux puces TPU 8i à faible latence dans un seul boîtier.
Le résultat est le double de calcul, le double de SRAM et le double de bande passante mémoire HBM par rapport au TPU 8i. Comme le 8i Max loge deux fois plus de silicium dans le même espace de rack, les centres de données peuvent déployer beaucoup plus de puissance de calcul par mètre carré et par watt — un point central pour les charges avec des fenêtres de contexte de millions de tokens.
Quatre systèmes pour chaque étape du cycle de vie des agents
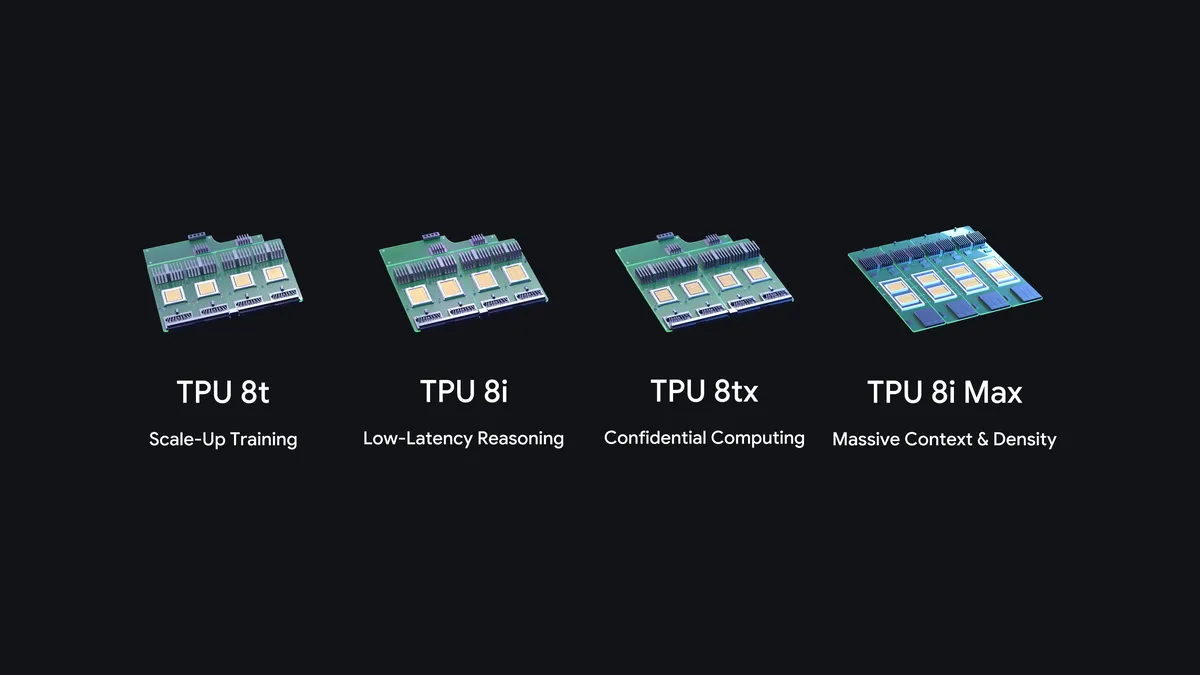
Ensemble, les quatre systèmes couvrent chaque phase du cycle de vie des agents d'IA : le TPU 8t pour l'entraînement à grande échelle, le TPU 8i pour le raisonnement à faible latence, le TPU 8tx pour le calcul confidentiel et le TPU 8i Max pour le contexte massif et la densité maximale par rack. Les TPU entraînent et servent les modèles Gemini et servent aujourd'hui près de 100 clients, dont des laboratoires de pointe, des sociétés de trading, des distributeurs et des universités.
Un logiciel ouvert pour apporter les TPU à tous les développeurs
L'annonce comprend aussi des avancées logicielles : le mois dernier, Google a ouvert le code de TorchTPU, qui permet d'exécuter du code PyTorch et des modèles Hugging Face nativement sur TPU — Geekiki a couvert le lancement de TorchTPU en octobre. L'entreprise a aussi présenté TPU Agent Suite, en avant-première, pour automatiser l'intégration avec des outils comme Claude Code et Cursor ; XLA Serving Engine, pour servir des modèles entraînés en Python dans un runtime C++ à faible latence ; Agent Compute Engine, qui suspend les sessions d'agents inactives et réduit les coûts d'infrastructure ; et TPU Sync, une couche d'état de modèle open source qui réduit de plus de 90 % la latence de transfert du cache KV et le temps jusqu'au premier token. Cloud Pathways et le découpage dynamique de GKE sont également passés en disponibilité générale.
Image mise en avant : Google / blog officiel de Google.
Sources
- Blog officiel de Google — Introducing TPU 8tx and TPU 8i Max
- Geekiki — TorchTPU Google : PyTorch natif open source pour les TPU
Transparence : cet article a été produit avec l'aide de l'intelligence artificielle, à partir de recherches et de recoupements de sources publiques sur Internet, dont le blog officiel de Google et des publications publiques sur X. Consultez les sources originales pour plus de détails.
Muse