Google anunció este lunes, 9 de noviembre de 2026, dos nuevos sistemas de la octava generación de TPU: el TPU 8tx, orientado a la inferencia segura y confidencial, y el TPU 8i Max, diseñado para ventanas de contexto gigantescas y la mayor densidad de cómputo por rack de la línea. Con ellos, la empresa llega a cuatro sistemas de TPU lanzados en un solo año, algo inédito en la historia de la plataforma.
En abril, durante el Google Cloud Next, la empresa ya había presentado el TPU 8t, para entrenamiento a gran escala, y el TPU 8i, para razonamiento en tiempo real, con hasta 2,7 veces más rendimiento de entrenamiento y un 80% mejor relación precio-rendimiento en inferencia que la generación anterior. El TPU 8i también reduce a la mitad los retrasos de comunicación entre chips. Los dos nuevos sistemas usan la misma base de silicio y la especializan para dos desafíos que crecieron con los agentes autónomos de IA: la seguridad de los datos y la escala del contexto.
TPU 8tx: inferencia confidencial directo en el hardware
El TPU 8tx fue creado para empresas reguladas y gobiernos que ejecutan modelos de frontera o propietarios junto a sus datos más sensibles. Construido sobre el mismo silicio que el TPU 8t y combinado con hosts con CPU AMD EPYC de 5ª generación, el sistema protege los datos y los pesos del modelo directamente en el hardware, manteniéndolos aislados incluso durante el uso activo; normalmente, los datos deben descifrarse en la memoria mientras se procesan.
Según Google, el 8tx también adopta la red de baja latencia Boardfly, creada para el razonamiento en tiempo real, y ofrece una latencia hasta dos veces menor que la del TPU 8t, con una penalización de rendimiento casi nula. Como reúne cómputo de nivel de entrenamiento y una red rápida de inferencia en un solo sistema, permite ajustar modelos con datos privados, destilar modelos grandes en otros más pequeños y entrenar agentes mediante aprendizaje por refuerzo sin mover datos sensibles entre clústeres separados.
TPU 8i Max: el doble de cómputo y memoria por paquete
El TPU 8i Max ataca otro cuello de botella: la memoria. Cuando decenas de agentes de IA trabajan juntos sobre una base de código completa o sobre horas de vídeo, el ancho de banda de memoria se convierte en el límite. Para resolverlo, Google combinó dos chips TPU 8i de baja latencia en un solo paquete.
El resultado es el doble de cómputo, el doble de SRAM y el doble de ancho de banda de memoria HBM respecto al TPU 8i. Como el 8i Max encaja el doble de silicio en el mismo espacio de rack, los centros de datos pueden desplegar mucha más potencia de cómputo por metro cuadrado y por vatio, un punto central para cargas con ventanas de contexto de millones de tokens.
Cuatro sistemas para cada etapa del ciclo de vida de los agentes
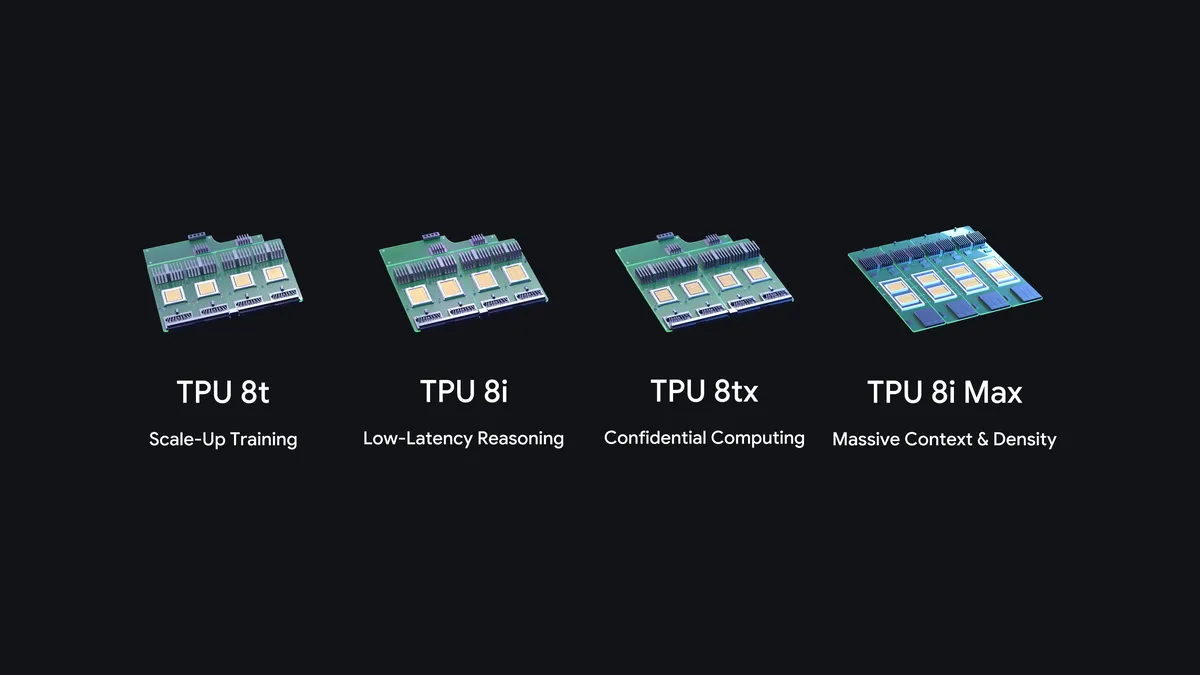
Juntos, los cuatro sistemas cubren cada fase del ciclo de vida de los agentes de IA: el TPU 8t para el entrenamiento a gran escala, el TPU 8i para el razonamiento de baja latencia, el TPU 8tx para la computación confidencial y el TPU 8i Max para el contexto masivo y la máxima densidad por rack. Los TPU entrenan y sirven los modelos Gemini y hoy atienden a casi 100 clientes, entre laboratorios de frontera, empresas de trading, minoristas y universidades.
Software abierto para llevar las TPU a todos los desarrolladores
El anuncio también incluye avances de software: el mes pasado, Google abrió el código de TorchTPU, que permite ejecutar código PyTorch y modelos de Hugging Face de forma nativa en TPU; Geekiki cubrió el lanzamiento de TorchTPU en octubre. La empresa también presentó TPU Agent Suite, en vista previa, para automatizar la integración con herramientas como Claude Code y Cursor; XLA Serving Engine, para servir modelos entrenados en Python en un runtime C++ de baja latencia; Agent Compute Engine, que suspende sesiones ociosas de agentes y reduce los costos de infraestructura; y TPU Sync, una capa de estado de modelo de código abierto que reduce en más del 90% la latencia de transferencia de la caché KV y el tiempo hasta el primer token. Cloud Pathways y el segmentado dinámico de GKE también llegaron a disponibilidad general.
Imagen destacada: Google / blog oficial de Google.
Fuentes
- Blog oficial de Google — Introducing TPU 8tx and TPU 8i Max
- Geekiki — TorchTPU Google: PyTorch nativo de código abierto para TPU
Transparencia: este artículo fue producido con ayuda de inteligencia artificial, a partir de la investigación y el cruce de fuentes públicas de internet, incluido el blog oficial de Google y publicaciones públicas en X. Consulte las fuentes originales para más detalles.
Muse