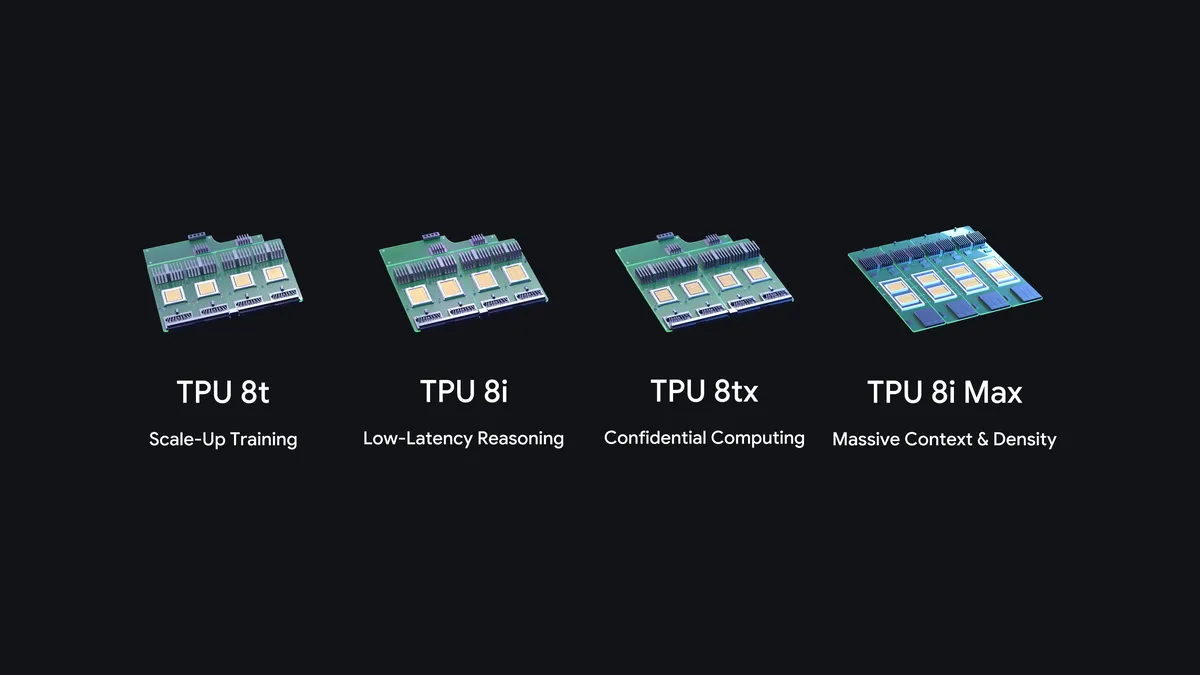
Google hat am Montag, dem 9. November 2026, zwei neue Systeme der achten TPU-Generation angekündigt: den TPU 8tx für sichere und vertrauliche Inferenz und den TPU 8i Max für riesige Kontextfenster und die höchste Rechendichte pro Rack der Reihe. Damit kommt das Unternehmen auf vier TPU-Systeme, die innerhalb eines einzigen Jahres eingeführt wurden — eine Premiere in der Geschichte der Plattform.
Im April hatte das Unternehmen auf der Google Cloud Next bereits den TPU 8t für Training im großen Maßstab und den TPU 8i für Echtzeit-Reasoning vorgestellt, mit bis zu 2,7-mal besserer Trainingsleistung und 80 % besserem Preis-Leistungs-Verhältnis bei der Inferenz als die vorherige Generation. Der TPU 8i halbiert zudem die Verzögerungen bei der Kommunikation zwischen Chips. Die beiden neuen Systeme bauen auf demselben Silizium auf und spezialisieren es für zwei Herausforderungen, die mit autonomen KI-Agenten gewachsen sind: Datensicherheit und Kontextgröße.
TPU 8tx: vertrauliche Inferenz direkt in der Hardware
Der TPU 8tx wurde für regulierte Unternehmen und Behörden geschaffen, die Frontier- oder proprietäre Modelle zusammen mit ihren sensibelsten Daten betreiben. Auf demselben Silizium wie der TPU 8t aufgebaut und mit Hosts mit AMD-EPYC-CPUs der 5. Generation kombiniert, schützt das System Daten und Modellgewichte direkt in der Hardware und hält sie auch während der aktiven Nutzung isoliert — normalerweise müssen Daten im Speicher entschlüsselt werden, während sie verarbeitet werden.
Laut Google übernimmt der 8tx außerdem das latenzarme Boardfly-Netzwerk, das für Echtzeit-Reasoning entwickelt wurde, und liefert eine bis zu zweimal geringere Latenz als der TPU 8t bei nahezu keiner Leistungseinbuße. Weil er Trainingsleistung und ein schnelles Inferenznetzwerk in einem einzigen System vereint, können Teams Modelle mit privaten Daten feinabstimmen, große Modelle in kleinere destillieren und Agenten per Reinforcement Learning trainieren, ohne sensible Daten zwischen getrennten Clustern zu verschieben.
TPU 8i Max: doppelte Rechenleistung und doppelter Speicher pro Gehäuse
Der TPU 8i Max geht einen weiteren Engpass an: den Speicher. Wenn Dutzende KI-Agenten gemeinsam an einer ganzen Codebasis oder Stunden von Video arbeiten, wird die Speicherbandbreite zur Grenze. Um das zu lösen, hat Google zwei latenzarme TPU-8i-Chips in einem einzigen Gehäuse kombiniert.
Das Ergebnis ist die doppelte Rechenleistung, der doppelte SRAM und die doppelte HBM-Speicherbandbreite gegenüber dem TPU 8i. Da der 8i Max doppelt so viel Silizium im selben Rack-Platz unterbringt, können Rechenzentren deutlich mehr Rechenleistung pro Quadratmeter und pro Watt bereitstellen — ein zentraler Punkt für Workloads mit Kontextfenstern von Millionen Tokens.
Vier Systeme für jede Phase des Agenten-Lebenszyklus
Zusammen decken die vier Systeme jede Phase des Lebenszyklus von KI-Agenten ab: TPU 8t für Training im großen Maßstab, TPU 8i für latenzarmes Reasoning, TPU 8tx für vertrauliches Rechnen und TPU 8i Max für massiven Kontext und maximale Rack-Dichte. Die TPUs trainieren die Gemini-Modelle und bedienen sie, und sie versorgen heute fast 100 Kunden, darunter Frontier-Labore, Handelsfirmen, Einzelhändler und Universitäten.
Offene Software, um TPUs zu allen Entwicklern zu bringen
Die Ankündigung umfasst auch Software-Fortschritte: Im vergangenen Monat hat Google TorchTPU als Open Source veröffentlicht, womit PyTorch-Code und Hugging-Face-Modelle nativ auf TPUs laufen — Geekiki berichtete im Oktober über den TorchTPU-Start. Das Unternehmen stellte außerdem die TPU Agent Suite in der Vorschau vor, um die Einarbeitung mit Tools wie Claude Code und Cursor zu automatisieren; die XLA Serving Engine, um in Python trainierte Modelle in einer latenzarmen C++-Laufzeitumgebung zu betreiben; die Agent Compute Engine, die untätige Agentensitzungen aussetzt und Infrastrukturkosten senkt; und TPU Sync, eine Open-Source-Modellzustandsschicht, die die Latenz beim KV-Cache-Transfer und die Zeit bis zum ersten Token um mehr als 90 % senkt. Cloud Pathways und das dynamische Slicing von GKE sind ebenfalls allgemein verfügbar geworden.
Titelbild: Google / offizieller Google-Blog.
Quellen
- Offizieller Google-Blog — Introducing TPU 8tx and TPU 8i Max
- Geekiki — TorchTPU Google: natives Open-Source-PyTorch für TPUs
Transparenz: Dieser Artikel wurde mit Hilfe künstlicher Intelligenz erstellt, auf Grundlage von Recherchen und dem Abgleich öffentlicher Quellen im Internet, darunter der offizielle Google-Blog und öffentliche Beiträge auf X. Bitte konsultieren Sie die Originalquellen für weitere Details.
Muse