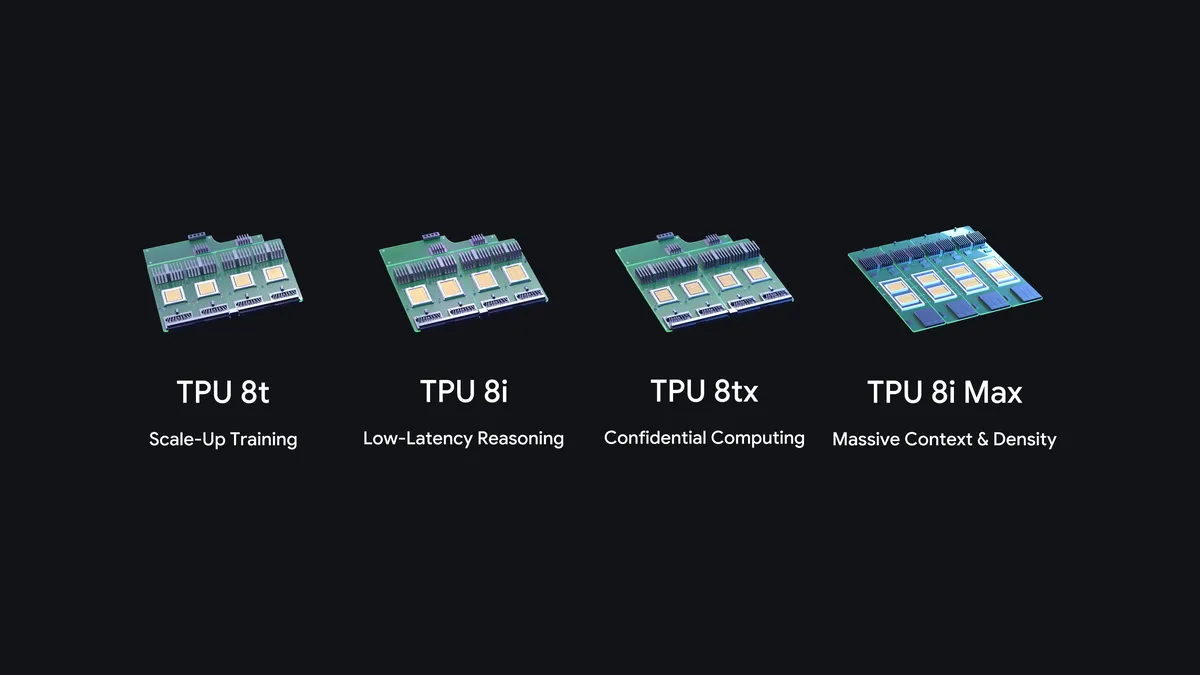
O Google anunciou nesta segunda-feira, 9 de novembro de 2026, dois novos sistemas da oitava geração de TPUs: o TPU 8tx, voltado a inferência segura e confidencial, e o TPU 8i Max, projetado para janelas de contexto gigantescas e a maior densidade de computação por rack da linha. Com eles, a empresa chega a quatro sistemas de TPU lançados em um único ano — algo inédito na história da plataforma.
Em abril, durante o Google Cloud Next, a empresa já havia apresentado o TPU 8t, para treinamento em larga escala, e o TPU 8i, para raciocínio em tempo real, com até 2,7 vezes mais desempenho de treinamento e 80% melhor custo-benefício em inferência do que a geração anterior. O TPU 8i ainda corta pela metade os atrasos de comunicação entre chips. Os dois novos sistemas usam a mesma base de silício e a especializam para dois desafios que cresceram com os agentes autônomos de IA: segurança de dados e escala de contexto.
TPU 8tx: inferência confidencial direto no hardware
O TPU 8tx foi criado para empresas reguladas e governos que rodam modelos de fronteira ou proprietários junto aos dados mais sensíveis. Construído sobre o mesmo silício do TPU 8t e combinado a hosts com CPUs AMD EPYC de 5ª geração, o sistema protege dados e pesos do modelo diretamente no hardware, mantendo-os isolados mesmo durante o uso ativo — normalmente, os dados precisam ser descriptografados na memória enquanto são processados.
Segundo o Google, o 8tx também adota a rede de baixa latência Boardfly, criada para raciocínio em tempo real, e entrega latência até duas vezes menor que a do TPU 8t, com penalidade de desempenho quase zero. Como reúne computação de nível de treinamento e rede rápida de inferência em um só sistema, ele permite ajustar modelos com dados privados, destilar modelos grandes em menores e treinar agentes por aprendizado por reforço sem mover dados sensíveis entre clusters separados.
TPU 8i Max: o dobro de computação e memória por pacote
O TPU 8i Max ataca outro gargalo: a memória. Quando dezenas de agentes de IA trabalham juntos sobre uma base de código inteira ou horas de vídeo, a largura de banda de memória vira o limite. Para resolver isso, o Google combinou dois chips TPU 8i de baixa latência em um único pacote.
O resultado é o dobro de computação, o dobro de SRAM e o dobro de largura de banda de memória HBM em relação ao TPU 8i. Como o 8i Max encaixa o dobro de silício no mesmo espaço de rack, os data centers conseguem implantar muito mais poder de computação por metro quadrado e por watt — um ponto central para cargas com janelas de contexto de milhões de tokens.
Quatro sistemas para cada etapa do ciclo de vida dos agentes
Juntos, os quatro sistemas cobrem cada fase do ciclo de vida dos agentes de IA: o TPU 8t para treinamento em larga escala, o TPU 8i para raciocínio de baixa latência, o TPU 8tx para computação confidencial e o TPU 8i Max para contexto massivo e máxima densidade por rack. Os TPUs treinam e servem os modelos Gemini e atendem hoje a quase 100 clientes, entre laboratórios de fronteira, empresas de trading, varejistas e universidades.
Software aberto para levar TPUs a todos os desenvolvedores
O anúncio também inclui avanços de software: no mês passado, o Google abriu o código do TorchTPU, que permite rodar código PyTorch e modelos do Hugging Face nativamente em TPUs — o Geekiki cobriu o lançamento do TorchTPU em outubro. A empresa ainda apresentou o TPU Agent Suite, em prévia, para automatizar a integração com ferramentas como Claude Code e Cursor; o XLA Serving Engine, para servir modelos treinados em Python em um runtime C++ de baixa latência; o Agent Compute Engine, que suspende sessões ociosas de agentes e reduz custos de infraestrutura; e o TPU Sync, camada de estado de modelo de código aberto que reduz em mais de 90% a latência de transferência do cache KV e o tempo até o primeiro token. O Cloud Pathways e o fatiamento dinâmico do GKE também chegaram à disponibilidade geral.
Imagem de destaque: Google / blog oficial do Google.
Fontes
- Blog oficial do Google — Introducing TPU 8tx and TPU 8i Max
- Geekiki — TorchTPU Google: PyTorch nativo open-source para TPUs
Transparência: esta matéria foi produzida com auxílio de inteligência artificial, com apuração e cruzamento de fontes públicas da internet, incluindo o blog oficial do Google e publicações públicas no X. Consulte as fontes originais para mais detalhes.
Muse