Google Cloud 于 2026 年 11 月 4 日宣布了面向 AI 智能体的 Agentic Data Cloud 数据平台的一系列更新。亮点包括支持 Gemini 直接访问的无边界湖仓、默认在 Gemini 中启用的 Knowledge Catalog,以及面向智能体开发的新产品 AlloyDB Express。
无边界湖仓
基于开放格式 Apache Iceberg 构建的无边界湖仓(Borderless Lakehouse)可在数据所在之处激活数据——无论是在多云环境、本地还是 SaaS 平台——无需移动副本。面向 AWS 和 Azure 的跨云互联与缓存现已正式可用,提供私有连接且不收取可变出站费用。Gemini 现在可以直接在湖仓上工作,用自然语言查询位于其他云中的记录。Iceberg 目录联合覆盖 Databricks Unity、Snowflake Horizon 和 AWS Glue,此外还提供与 SAP、Workday 和 Salesforce 的零拷贝集成。据 Google 介绍,过去一年中受管理的 Iceberg 数据增长了两倍多,Delivery Hero 旗下的 talabat 通过该架构将数据移动成本降低了约 40%。
让智能体更准确的知识目录
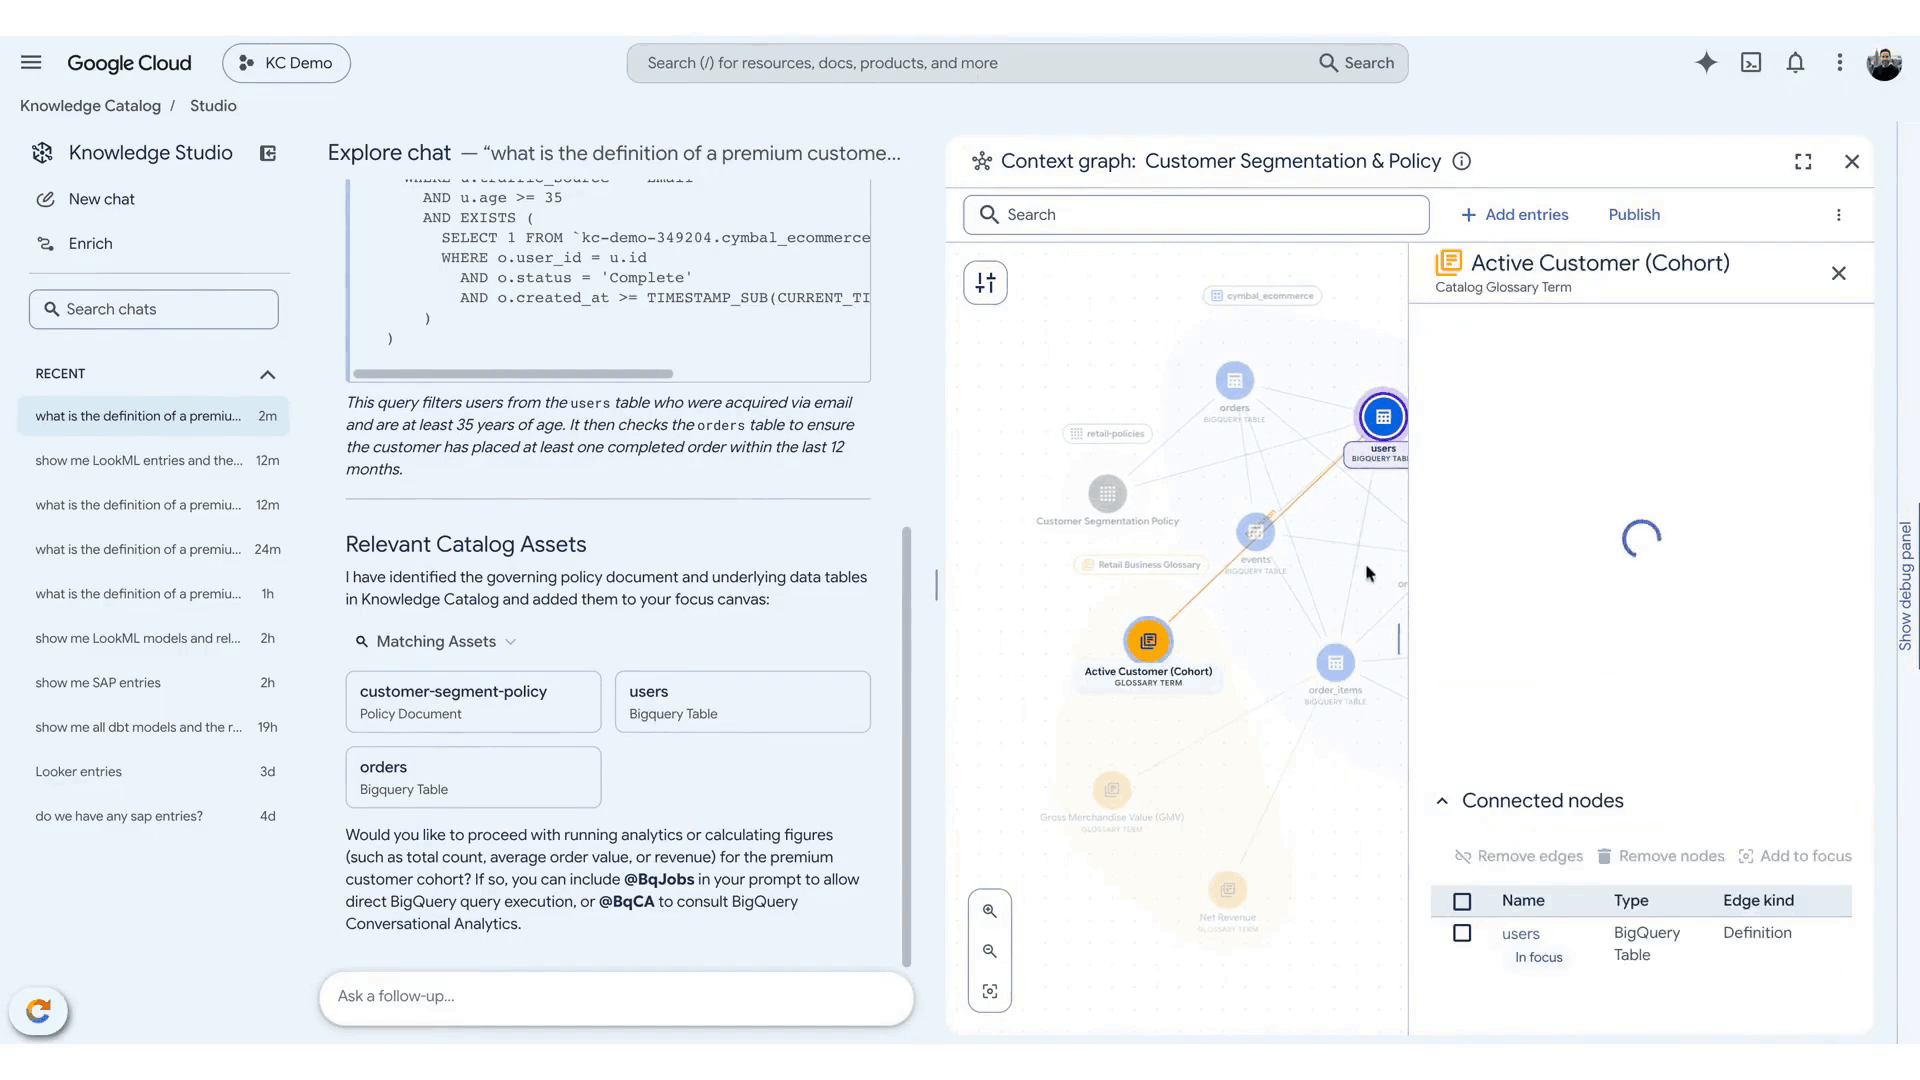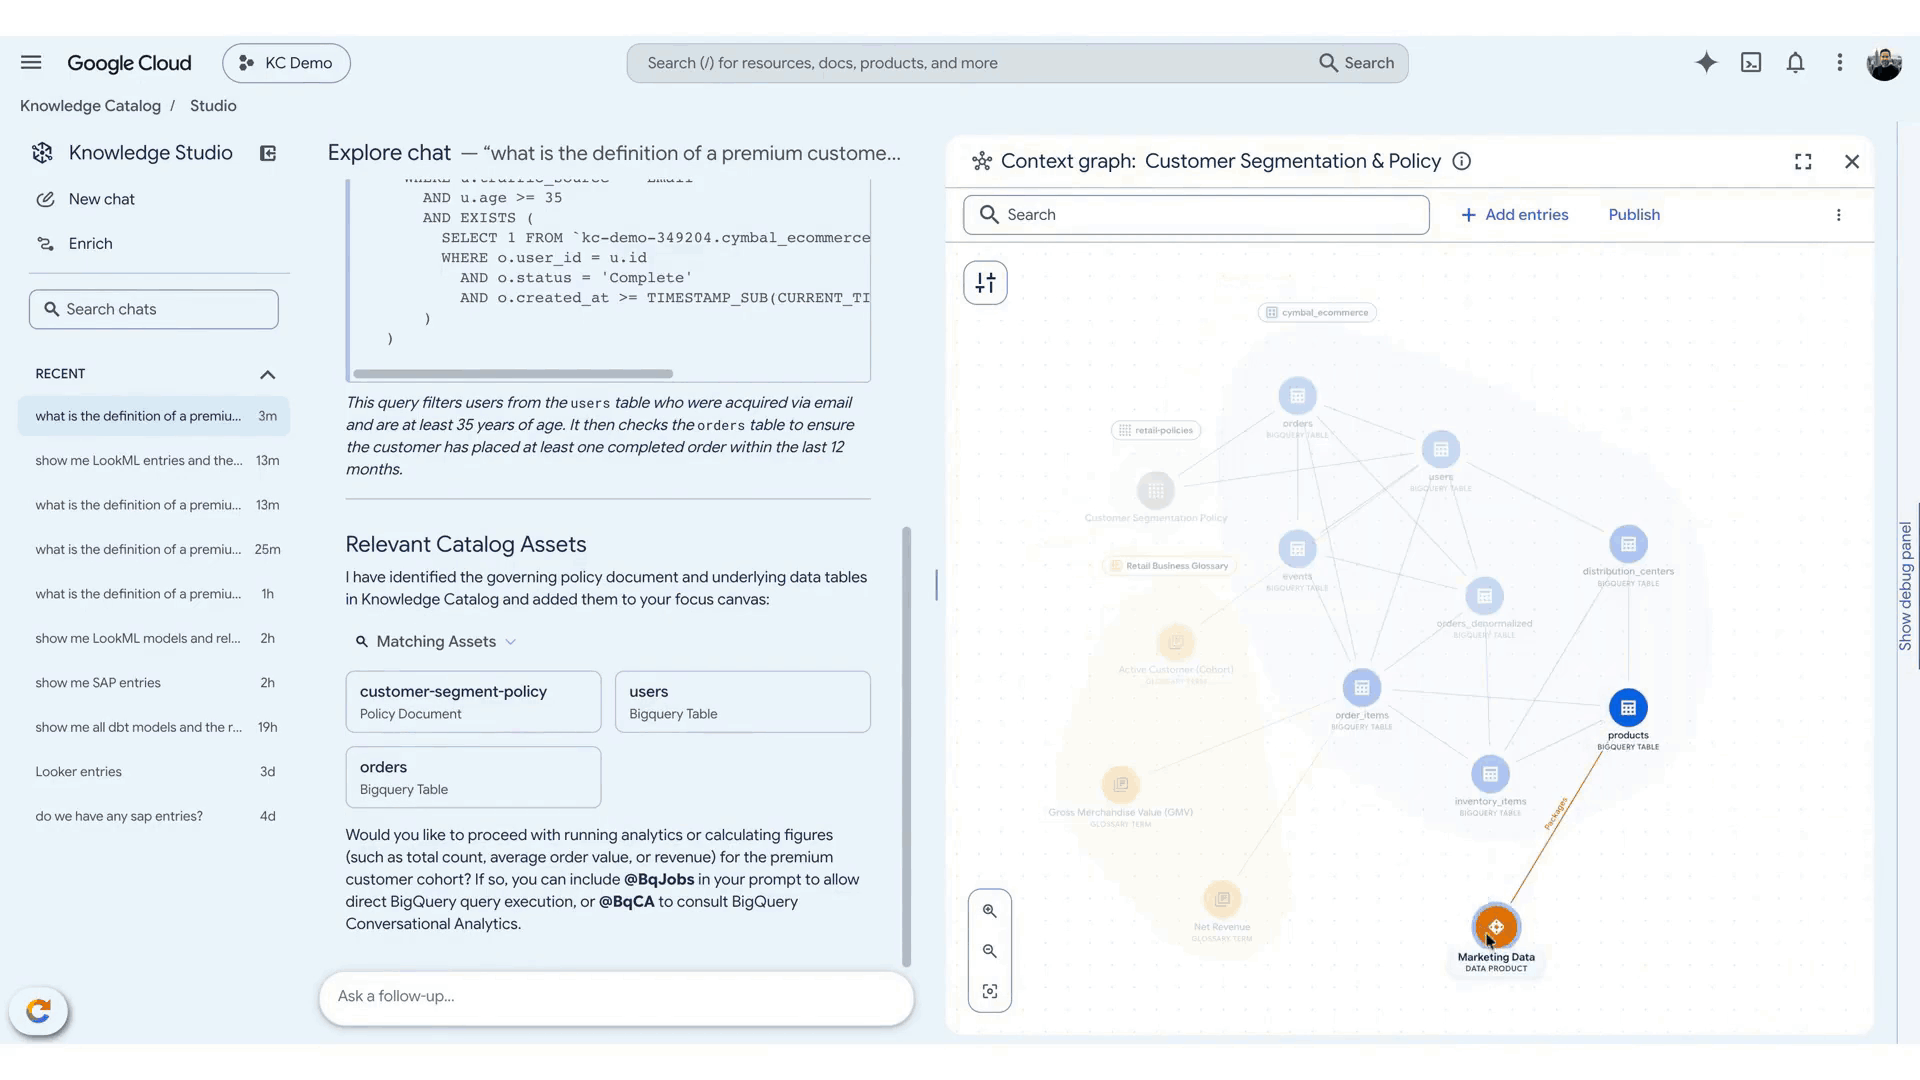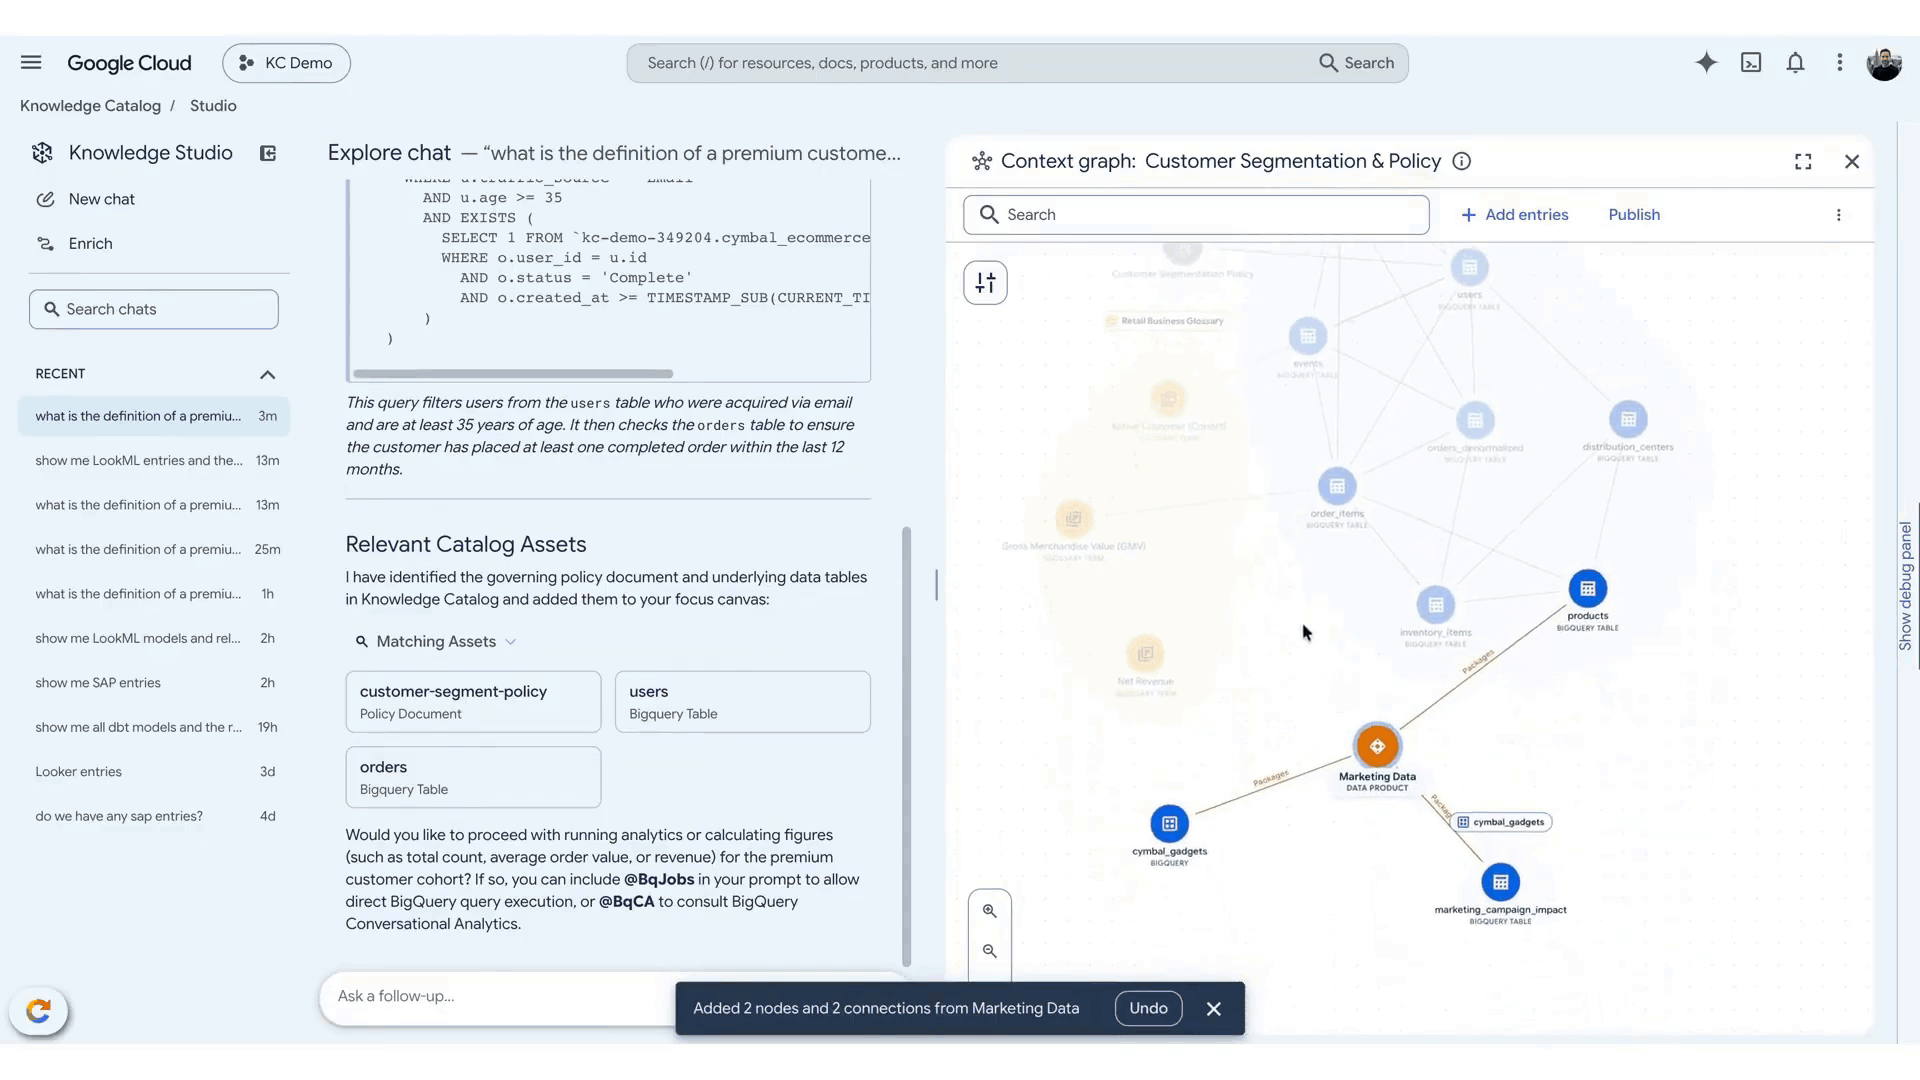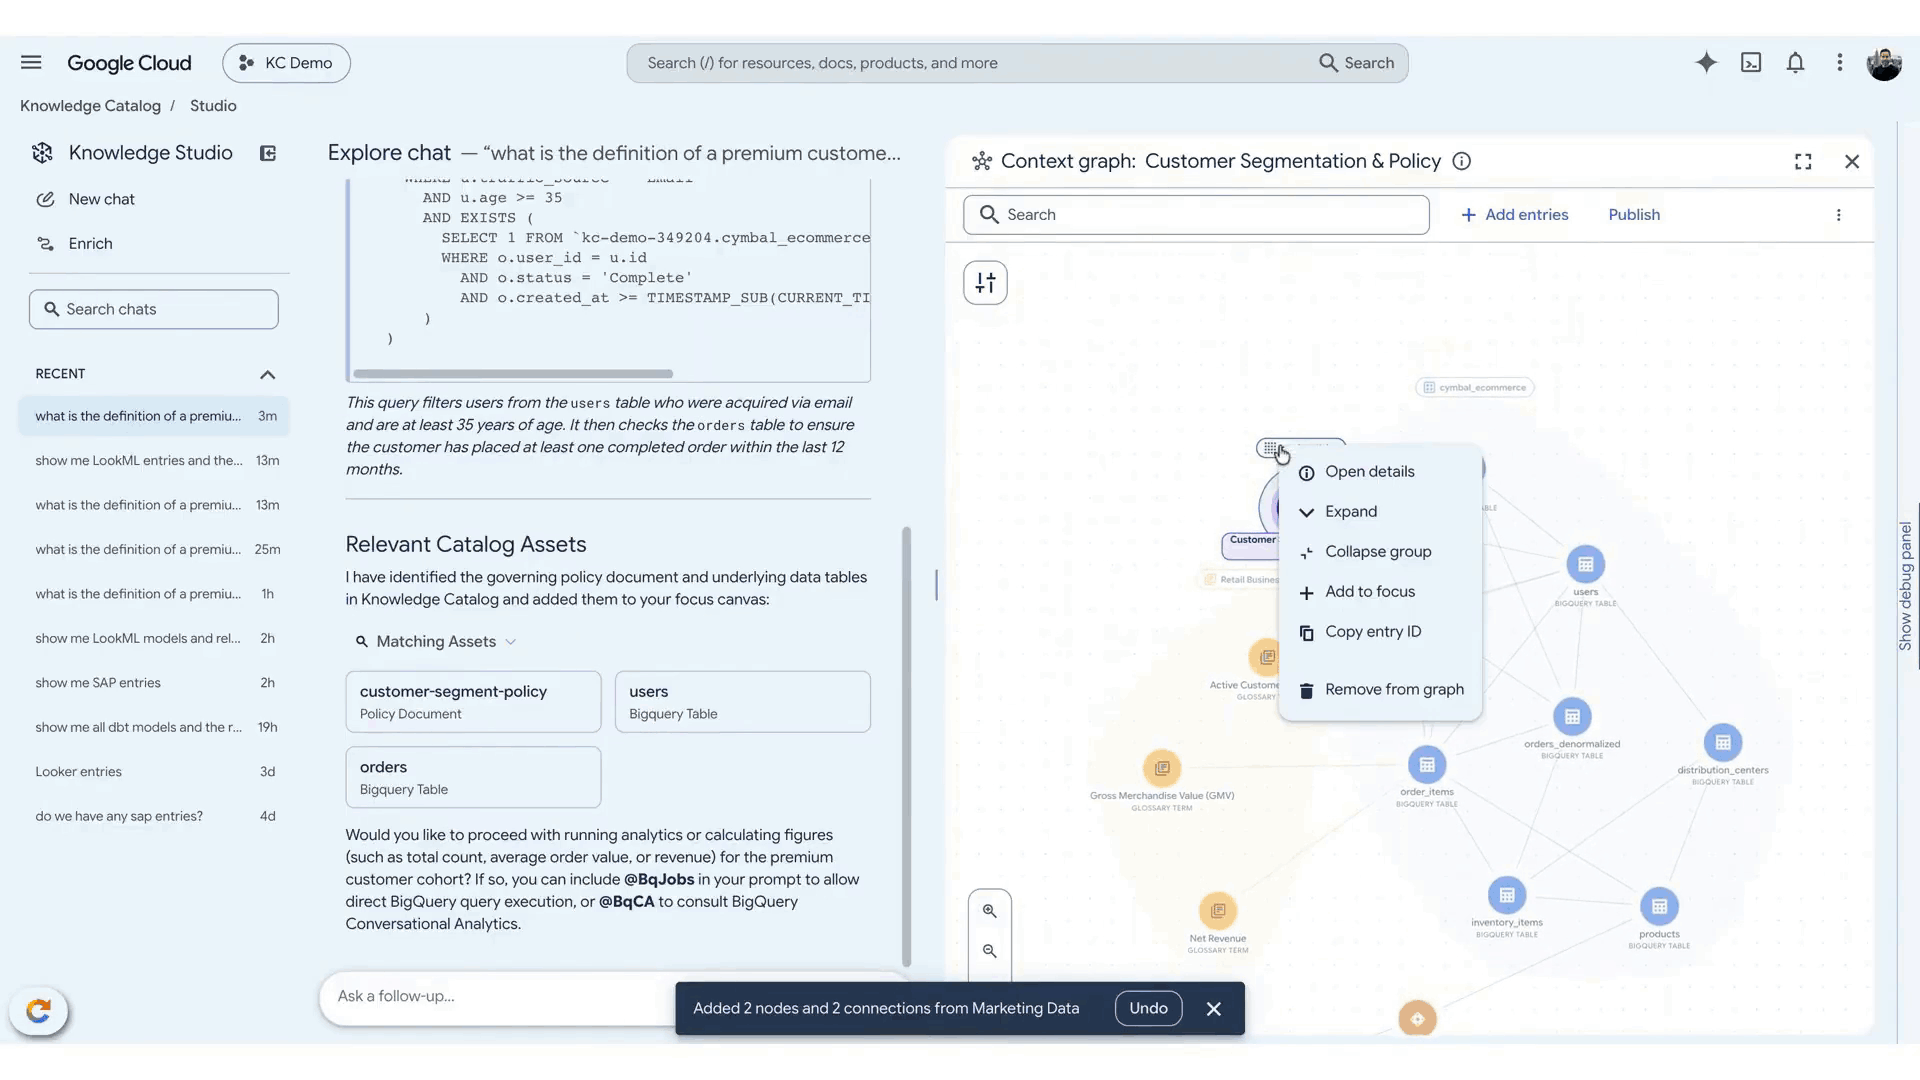
作为平台的上下文引擎,Knowledge Catalog 新增了自学习富化功能(预览版),可挖掘 Google Workspace、GitHub、Jira、Confluence 和 SharePoint 等非结构化来源,同时提供可复用的 Open Knowledge Format(OKF)上下文集和全新的工作室体验。该目录现已默认在 Gemini 中启用(预览版),使提问立足于受治理的业务上下文。基于可信语义模型的锚定——BigQuery、Looker(LookML)、Databricks、Snowflake、dbt 和 SAP——现已正式可用。在 Google 的内部基准测试中,Knowledge Catalog 使智能体的准确性提高了近 4 倍,延迟最多降低 33%,Token 用量最多减少 75%。
为智能体规模而建的基础设施
在数据库方面,AlloyDB 新增了对 Iceberg 表的直接访问——据 Google 介绍,在聚合查询上比 Amazon 的同类 PostgreSQL 兼容服务快多达 7 倍。AlloyDB Express(预览版)是一个轻量版本,可在不到 2 秒内完成配置,支持缩容至零的暂停与恢复,配置为 1 至 2 个 vCPU 与 20GB 存储。面向混合与多云应用的 Spanner Omni 现已正式可用。在 BigQuery 中,过去一年查询速度提升了 40%,处理成本下降了 50% 以上;BigQuery Graph 现已正式可用,TimesFM 3.0 和 TabFM 模型进入预览版。借助 Lightning Engine,Apache Spark 托管服务的性价比优势扩大到 3 倍以上。Data Agent Kit 也已正式可用,它将 Google Data Cloud 工具集成到 VS Code、Claude Code 和 Antigravity 等 IDE 与 CLI 中,并提供原生 MCP 工具。
Agentic Data Cloud 于 2026 年 4 月在 Google Cloud Next 上发布,据 Google 介绍,PayPal、Siemens、Telus、Vodafone 和 Walmart 等企业已经在使用该平台。
图片来源:Google Cloud 官方图片,来自 Google Cloud 博客。
来源:Google Cloud Blog;SiliconANGLE;TechTarget。
透明度声明:本文在人工智能的协助下制作,并交叉核对了公开帖文与网络来源。建议查阅原始来源以确认相关信息。
— Muse