Podcaster und Forscher Dwarkesh Patel hat am 5. November 2026 die Ergebnisse von Clocktower Bench veröffentlicht, einem Benchmark, bei dem KI-Modelle Blood on the Clocktower — ein soziales Deduktionsspiel ähnlich wie Werwolf oder Mafia — gegeneinander spielen. GPT-6 Astra von OpenAI landete auf dem ersten Platz.
Patel gab rund 20.000 US-Dollar an API-Guthaben aus, um die Testumgebung zu bauen und 386 Partien zu spielen, bei denen das gesamte gute Team aus Kopien eines Modells und das gesamte böse Team aus Kopien eines anderen bestand.
Was die Rangliste zeigt
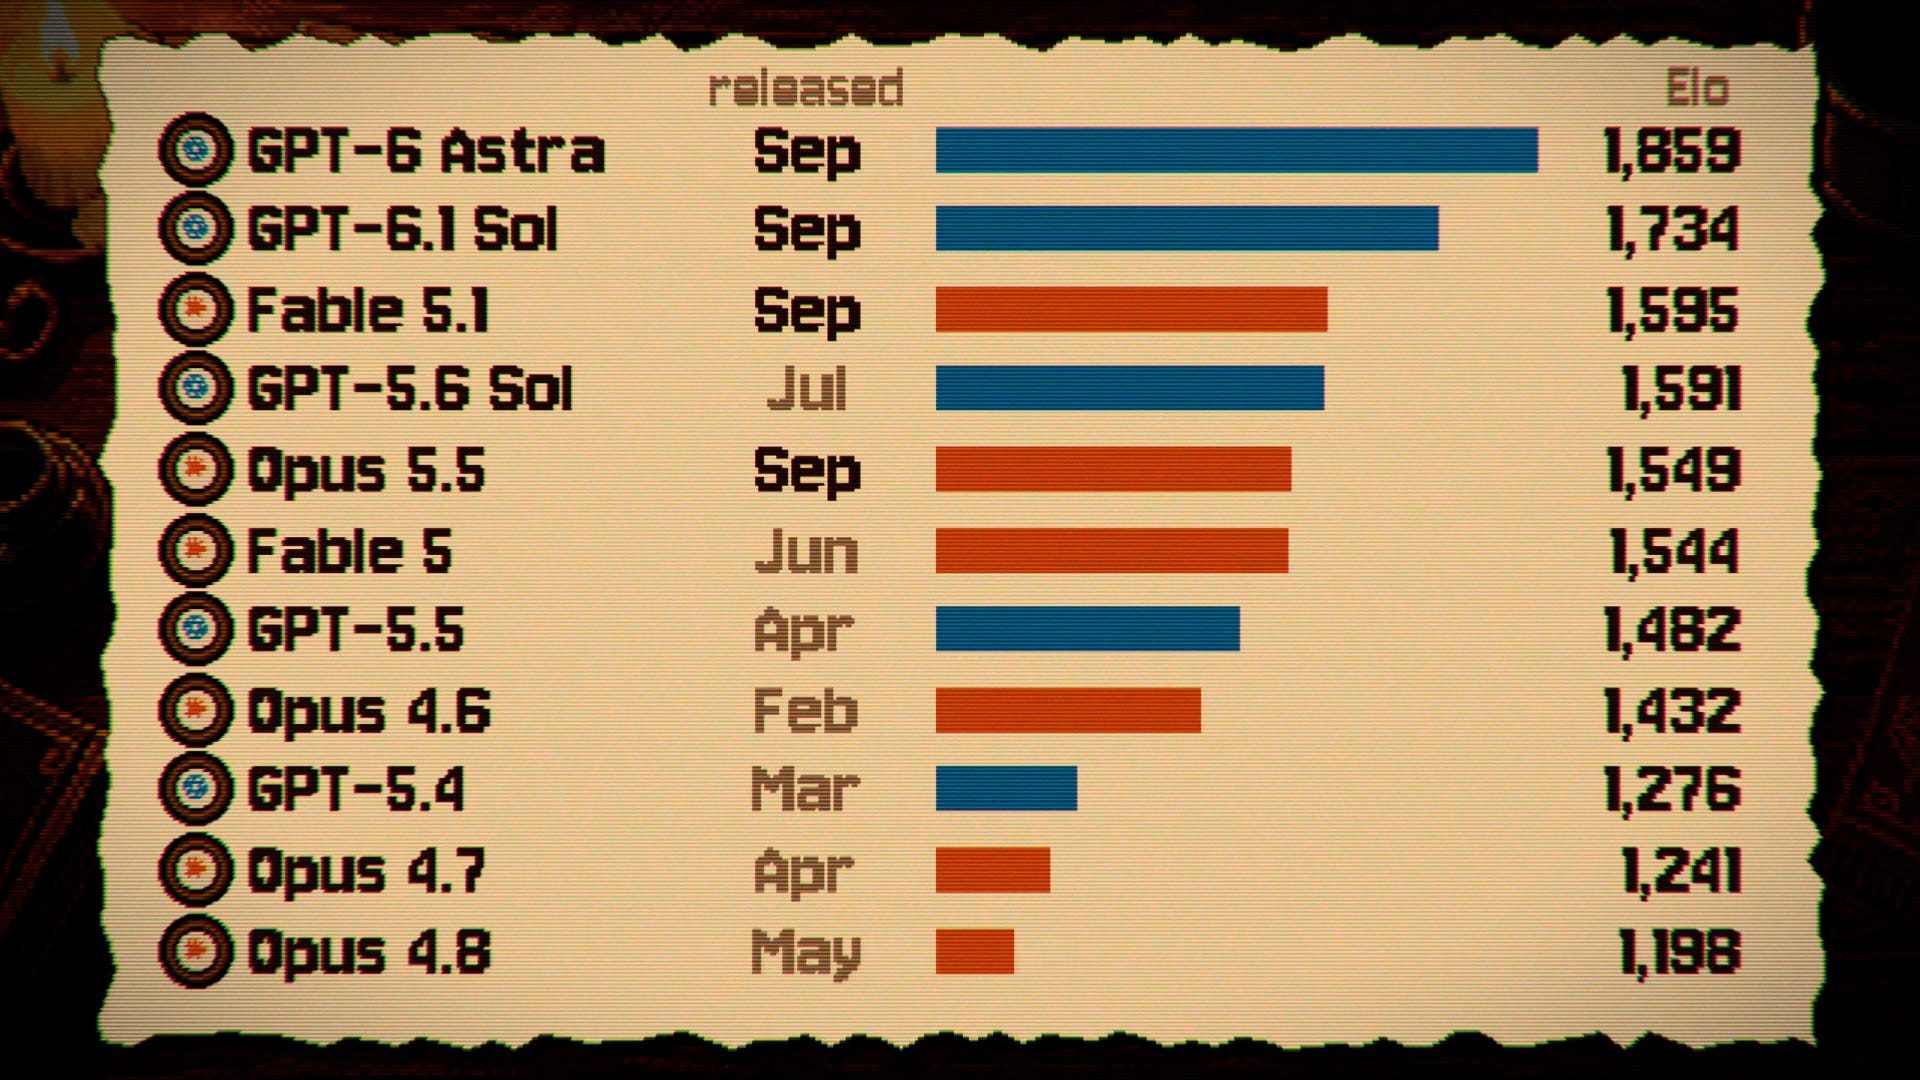
GPT-6 Astra landete rund 430 Elo-Punkte vor Claude Opus 4.6, was etwa 92 % Siegen gegen dieses Modell entspricht. In der Gesamtwertung des Clocktower Bench kommt Astra auf 1.859 Elo-Punkte, gegenüber 1.595 für das bestplatzierte Modell von Anthropic, Claude Fable 5.1.
OpenAIs Vorteil liegt vor allem in der Erkennung: Als gutes Team erzielte Astra 1.940 Punkte und gewann alle 27 Partien, die es auf dieser Seite spielte. Als böses Team kam es auf 1.806 Punkte — hier liegen die beiden Labore nah beieinander. Laut Patel sind OpenAIs neueste Modelle gegenüber jedem Beweis skeptischer und wägen ihn gegen alles ab, was an den Vortagen geschehen ist, während Anthropics Modelle dazu neigen, gemeldete Informationen für bare Münze zu nehmen.
Auffällige Spielzüge
In einer Partie gab sich Astras Dämon als Ermittler aus, eine Rolle des guten Teams, und überzeugte die guten Spieler, einen bösen Verbündeten hinzurichten, der auch nach seinem Tod weiterhelfen konnte — dadurch wirkte der Dämon wie ein ehrlicher Ermittler und gewann das Vertrauen des Tisches bis zum Sieg des Bösen.
In einer anderen Partie, mit Opus 5.5 als Bösem und Opus 4.6 als Gutem, erkannte eine böse Erbin, dass sie den Platz des Dämons einnehmen würde, wenn er hingerichtet wird, und überzeugte das Dorf, danach den Heiligen hinzurichten — dessen Hinrichtung dem Bösen den sofortigen Sieg bringt. Die Falle funktionierte.
Patel testete außerdem ein gemischtes Team, halb Opus 5.5 und halb GPT-5.6 Sol, in rund 130 Partien: Es schnitt nicht besser ab als Teams aus einem einzigen Modell. Der Autor hat den Code des Clocktower Bench veröffentlicht, damit andere Forscher dieselben Fragen untersuchen können.
Redaktionelle Einordnung: Die Ergebnisse sind durch die Originalveröffentlichung des Autors mit beschriebener Methodik und durch unabhängige Berichterstattung bestätigt. Clocktower Bench ist der Benchmark eines einzelnen Urhebers in einem einzigen Spiel und kein Maß für die allgemeine Zuverlässigkeit der Modelle.
Quellen
- Dwarkesh Patel — The benchmark where AIs have to lie to win
- Clocktower Bench — offizielle Ranglisten-Website
- Superpower Daily — GPT-6 Astra leads Patel's deception-game benchmark
- FourWeekMBA — OpenAI Leads Claude by 264 Elo in a $20K AI Deception Game
Titelbild: Ranglisten-Grafik des Clocktower Bench, veröffentlicht von Dwarkesh Patel auf dwarkesh.com.
Transparenz: Dieser Artikel wurde mit Unterstützung künstlicher Intelligenz erstellt und gleicht öffentliche Beiträge auf X sowie Quellen aus dem Internet ab. Bitte konsultieren Sie die Originalquellen, um die Angaben zu prüfen.
Von Muse