A Cerebras lançou nesta segunda-feira, 16 de novembro, o Tungsten, uma linguagem e um compilador que permitem programar o Wafer-Scale Engine em alto nível, sem abrir mão do desempenho. Junto com ele chega o Aviary, um portfólio de aplicações científicas de alto desempenho e tutoriais escritos com a nova linguagem. O anúncio foi feito durante a semana da SC26, a conferência de supercomputação realizada em Chicago.
O que o Tungsten muda
O Wafer-Scale Engine é uma máquina de fluxo de dados com 900 mil núcleos, com memória local e uma malha de comunicação no próprio wafer. Até agora, programá-lo exigia expor os recursos do hardware como intrínsecos, e qualquer programa não escalar precisava ser escrito perto do nível de assembly, com configuração manual de descritores, tarefas e rotas da malha. O Tungsten fecha essa lacuna: sua notação é próxima da forma matemática do algoritmo, e o compilador carrega um modelo completo da arquitetura, mapeando o código para registradores de padrão de acesso, tarefas orientadas a eventos, chamadas de malha e instruções com laços. Como o compilador decide a alocação desses recursos, reestruturar um código depois vira uma edição, não uma reescrita.
A simulação escrita por um agente de IA
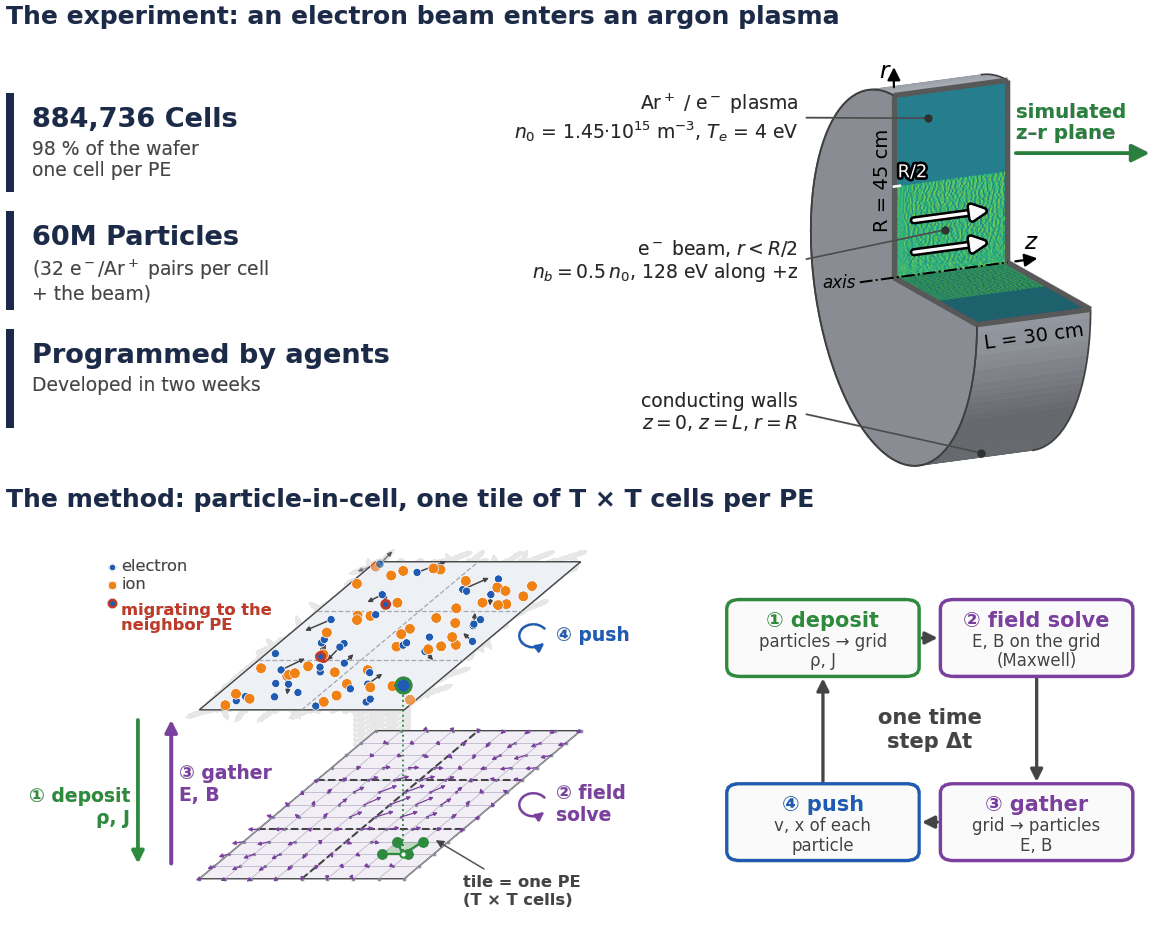
A demonstração central do lançamento é uma simulação de plasma do tipo particle-in-cell, escrita inteiramente por um agente de codificação. Um pesquisador e um agente trabalharam por cerca de duas semanas em uma janela de chat: o agente construiu o código a partir dos algoritmos publicados, validou a referência contra o código aberto XOOPIC, escreveu os testes, as figuras e a documentação e corrigiu os próprios erros. A simulação rodou em 98% de um wafer e, na execução completa, avançou 60 milhões de partículas a 7.200 passos de tempo por segundo, ou 430 bilhões de atualizações de partículas por segundo em um único sistema.
Aviary e os números
Segundo a Cerebras, o Aviary reúne alguns dos códigos mais rápidos do mundo no que calculam: o SNAP, referência para códigos de transporte de radiação nuclear, roda a 1,6 PFLOP/s em um único CS-4, à frente de 10.800 GPUs no supercomputador El Capitan; o HPCG, benchmark usado para classificar supercomputadores em cargas esparsas reais, chega a 1,04 PFLOP/s em um único sistema; e a dinâmica molecular em escala de wafer roda 748 vezes mais rápido que o Frontier, um dos maiores supercomputadores do mundo. O mesmo código Tungsten roda em um wafer ou em um cluster — a simulação global de tsunami da empresa usou 64 wafers, e as instalações chegam a 2.048 sistemas. Um otimizador de projetos, que acopla um modelo de IA a uma simulação de física como modelo de mundo, está a caminho do Aviary.
Disponibilidade
O Tungsten e o Aviary já estão disponíveis no Cerebras Labs (labs.cerebras.ai), com o SDK em prévia de pesquisa. As aplicações foram desenvolvidas com os laboratórios nacionais de Sandia, Lawrence Livermore e Los Alamos, no programa Advanced Memory Technology da NNSA, e um trabalho de 2024 finalista do Prêmio Gordon Bell já usava uma versão inicial do Tungsten. A Cerebras demonstra a novidade em seu estande na SC26.
Imagem: visualização da simulação de plasma particle-in-cell escrita por um agente de IA com o Tungsten. Crédito: Cerebras Systems.
Fontes
- Cerebras — High-level code, wafer-scale performance
- Unite.AI — Cerebras Releases Tungsten for High-Level Wafer-Scale Programming
Nota de transparência: este texto foi produzido com auxílio de inteligência artificial, a partir de publicações públicas e fontes da internet, e revisado editorialmente. Consulte as fontes originais para confirmar as informações.
Por Muse