Cerebras hat am Montag, den 16. November, Tungsten gestartet, eine Sprache und einen Compiler, mit denen sich die Wafer-Scale Engine auf hohem Niveau programmieren lässt, ohne Leistung einzubüßen. Dazu kommt Aviary, ein Portfolio leistungsstarker wissenschaftlicher Anwendungen und Tutorials, die in der neuen Sprache geschrieben sind. Die Ankündigung erfolgte in der Woche der SC26, der Supercomputing-Konferenz in Chicago.
Was Tungsten verändert
Die Wafer-Scale Engine ist eine Datenflussmaschine mit 900.000 Kernen, lokalem Speicher und einem Kommunikationsnetz auf dem Wafer selbst. Bisher musste man zum Programmieren Hardwarefunktionen als Intrinsics freilegen, und jedes nicht-skalare Programm war fast auf Assembler-Niveau zu schreiben, mit manuell konfigurierten Deskriptoren, Aufgaben und Netzrouten. Tungsten schließt diese Lücke: Seine Notation bleibt nahe an der mathematischen Form des Algorithmus, und der Compiler trägt ein vollständiges Modell der Architektur in sich und bildet Code auf Zugriffsmusterregister, ereignisgesteuerte Aufgaben, Netzaufrufe und schleifentragende Befehle ab. Da der Compiler diese Zuteilungen entscheidet, wird das spätere Umstrukturieren von Code zu einer Bearbeitung, nicht zu einer Neufassung.
Die Simulation, die ein KI-Agent geschrieben hat
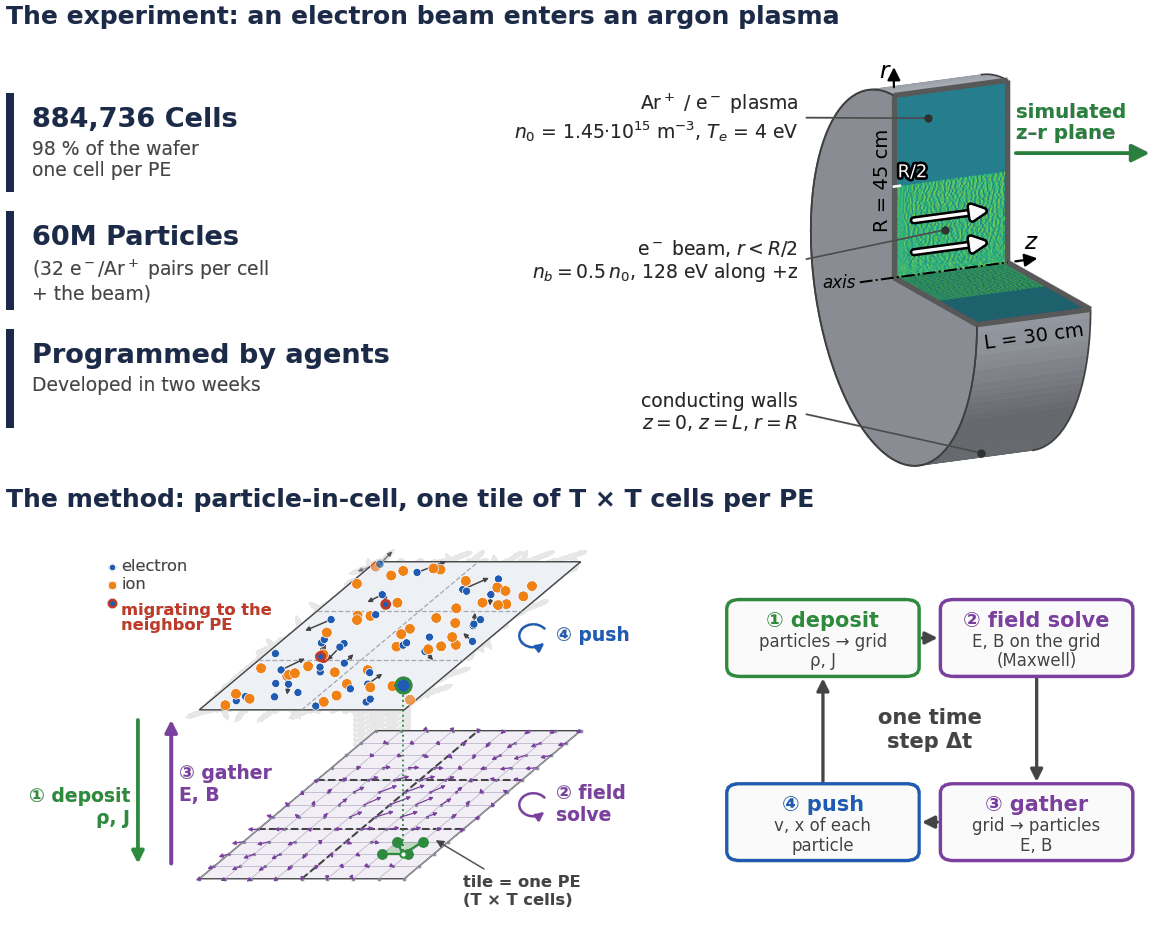
Die zentrale Demonstration des Starts ist eine Particle-in-Cell-Plasmasimulation, die vollständig von einem Coding-Agenten geschrieben wurde. Ein Forscher und ein Agent arbeiteten etwa zwei Wochen in einem Chatfenster: Der Agent baute den Code aus veröffentlichten Algorithmen, validierte seine Referenz gegen den Open-Source-Code XOOPIC, schrieb Tests, Abbildungen und Dokumentation und behob eigene Fehler. Die Simulation lief auf 98 % eines Wafers und brachte in der vollständigen Ausführung 60 Millionen Teilchen mit 7.200 Zeitschritten pro Sekunde voran — 430 Milliarden Teilchenaktualisierungen pro Sekunde auf einem einzigen System.
Aviary und die Zahlen
Laut Cerebras vereint Aviary einige der schnellsten Codes der Welt in dem, was sie berechnen: SNAP, Referenz für Codes zum Strahlungstransport in der Kerntechnik, läuft mit 1,6 PFLOP/s auf einem einzigen CS-4, vor 10.800 GPUs des Supercomputers El Capitan; HPCG, der Benchmark zur Einordnung von Supercomputern bei realen dünn besetzten Workloads, erreicht 1,04 PFLOP/s auf einem einzigen System; und waferweite Molekulardynamik läuft 748-mal schneller als Frontier, einer der größten Supercomputer der Welt. Derselbe Tungsten-Code läuft auf einem Wafer oder einem Cluster — die globale Tsunami-Simulation des Unternehmens nutzte 64 Wafer, und Installationen skalieren bis auf 2.048 Systeme. Ein Design-Optimierer, der ein KI-Modell mit einer Physiksimulation als Weltmodell koppelt, kommt bald zu Aviary.
Verfügbarkeit
Tungsten und Aviary sind bereits über Cerebras Labs (labs.cerebras.ai) verfügbar, mit dem SDK in der Research Preview. Die Anwendungen entstanden aus der Zusammenarbeit mit den nationalen Laboratorien Sandia, Lawrence Livermore und Los Alamos im Rahmen des Advanced-Memory-Technology-Programms der NNSA, und eine Arbeit, die 2024 Finalistin des Gordon-Bell-Preises war, nutzte bereits eine frühe Version von Tungsten. Cerebras zeigt die Neuheit an seinem Stand auf der SC26.
Bild: Visualisierung der Particle-in-Cell-Plasmasimulation, die von einem KI-Agenten mit Tungsten geschrieben wurde. Credit: Cerebras Systems.
Quellen
- Cerebras — High-level code, wafer-scale performance
- Unite.AI — Cerebras Releases Tungsten for High-Level Wafer-Scale Programming
Transparenzhinweis: Dieser Text wurde mithilfe künstlicher Intelligenz erstellt, auf Grundlage öffentlicher Beiträge und Internetquellen, und redaktionell geprüft. Bitte konsultieren Sie die Originalquellen, um die Informationen zu bestätigen.
Von Muse


