La Axelera Titania AIPU ha llegado: la startup europea de aceleradores de IA reveló el 12 de noviembre de 2026 la arquitectura detallada de Titania, su tercera generación de AIPU (AI Processing Unit). El diseño en chiplet busca llevar rendimiento de centro de datos a racks convencionales sin depender de HBM ni refrigeración líquida de alta densidad.
¿Qué ocurrió?
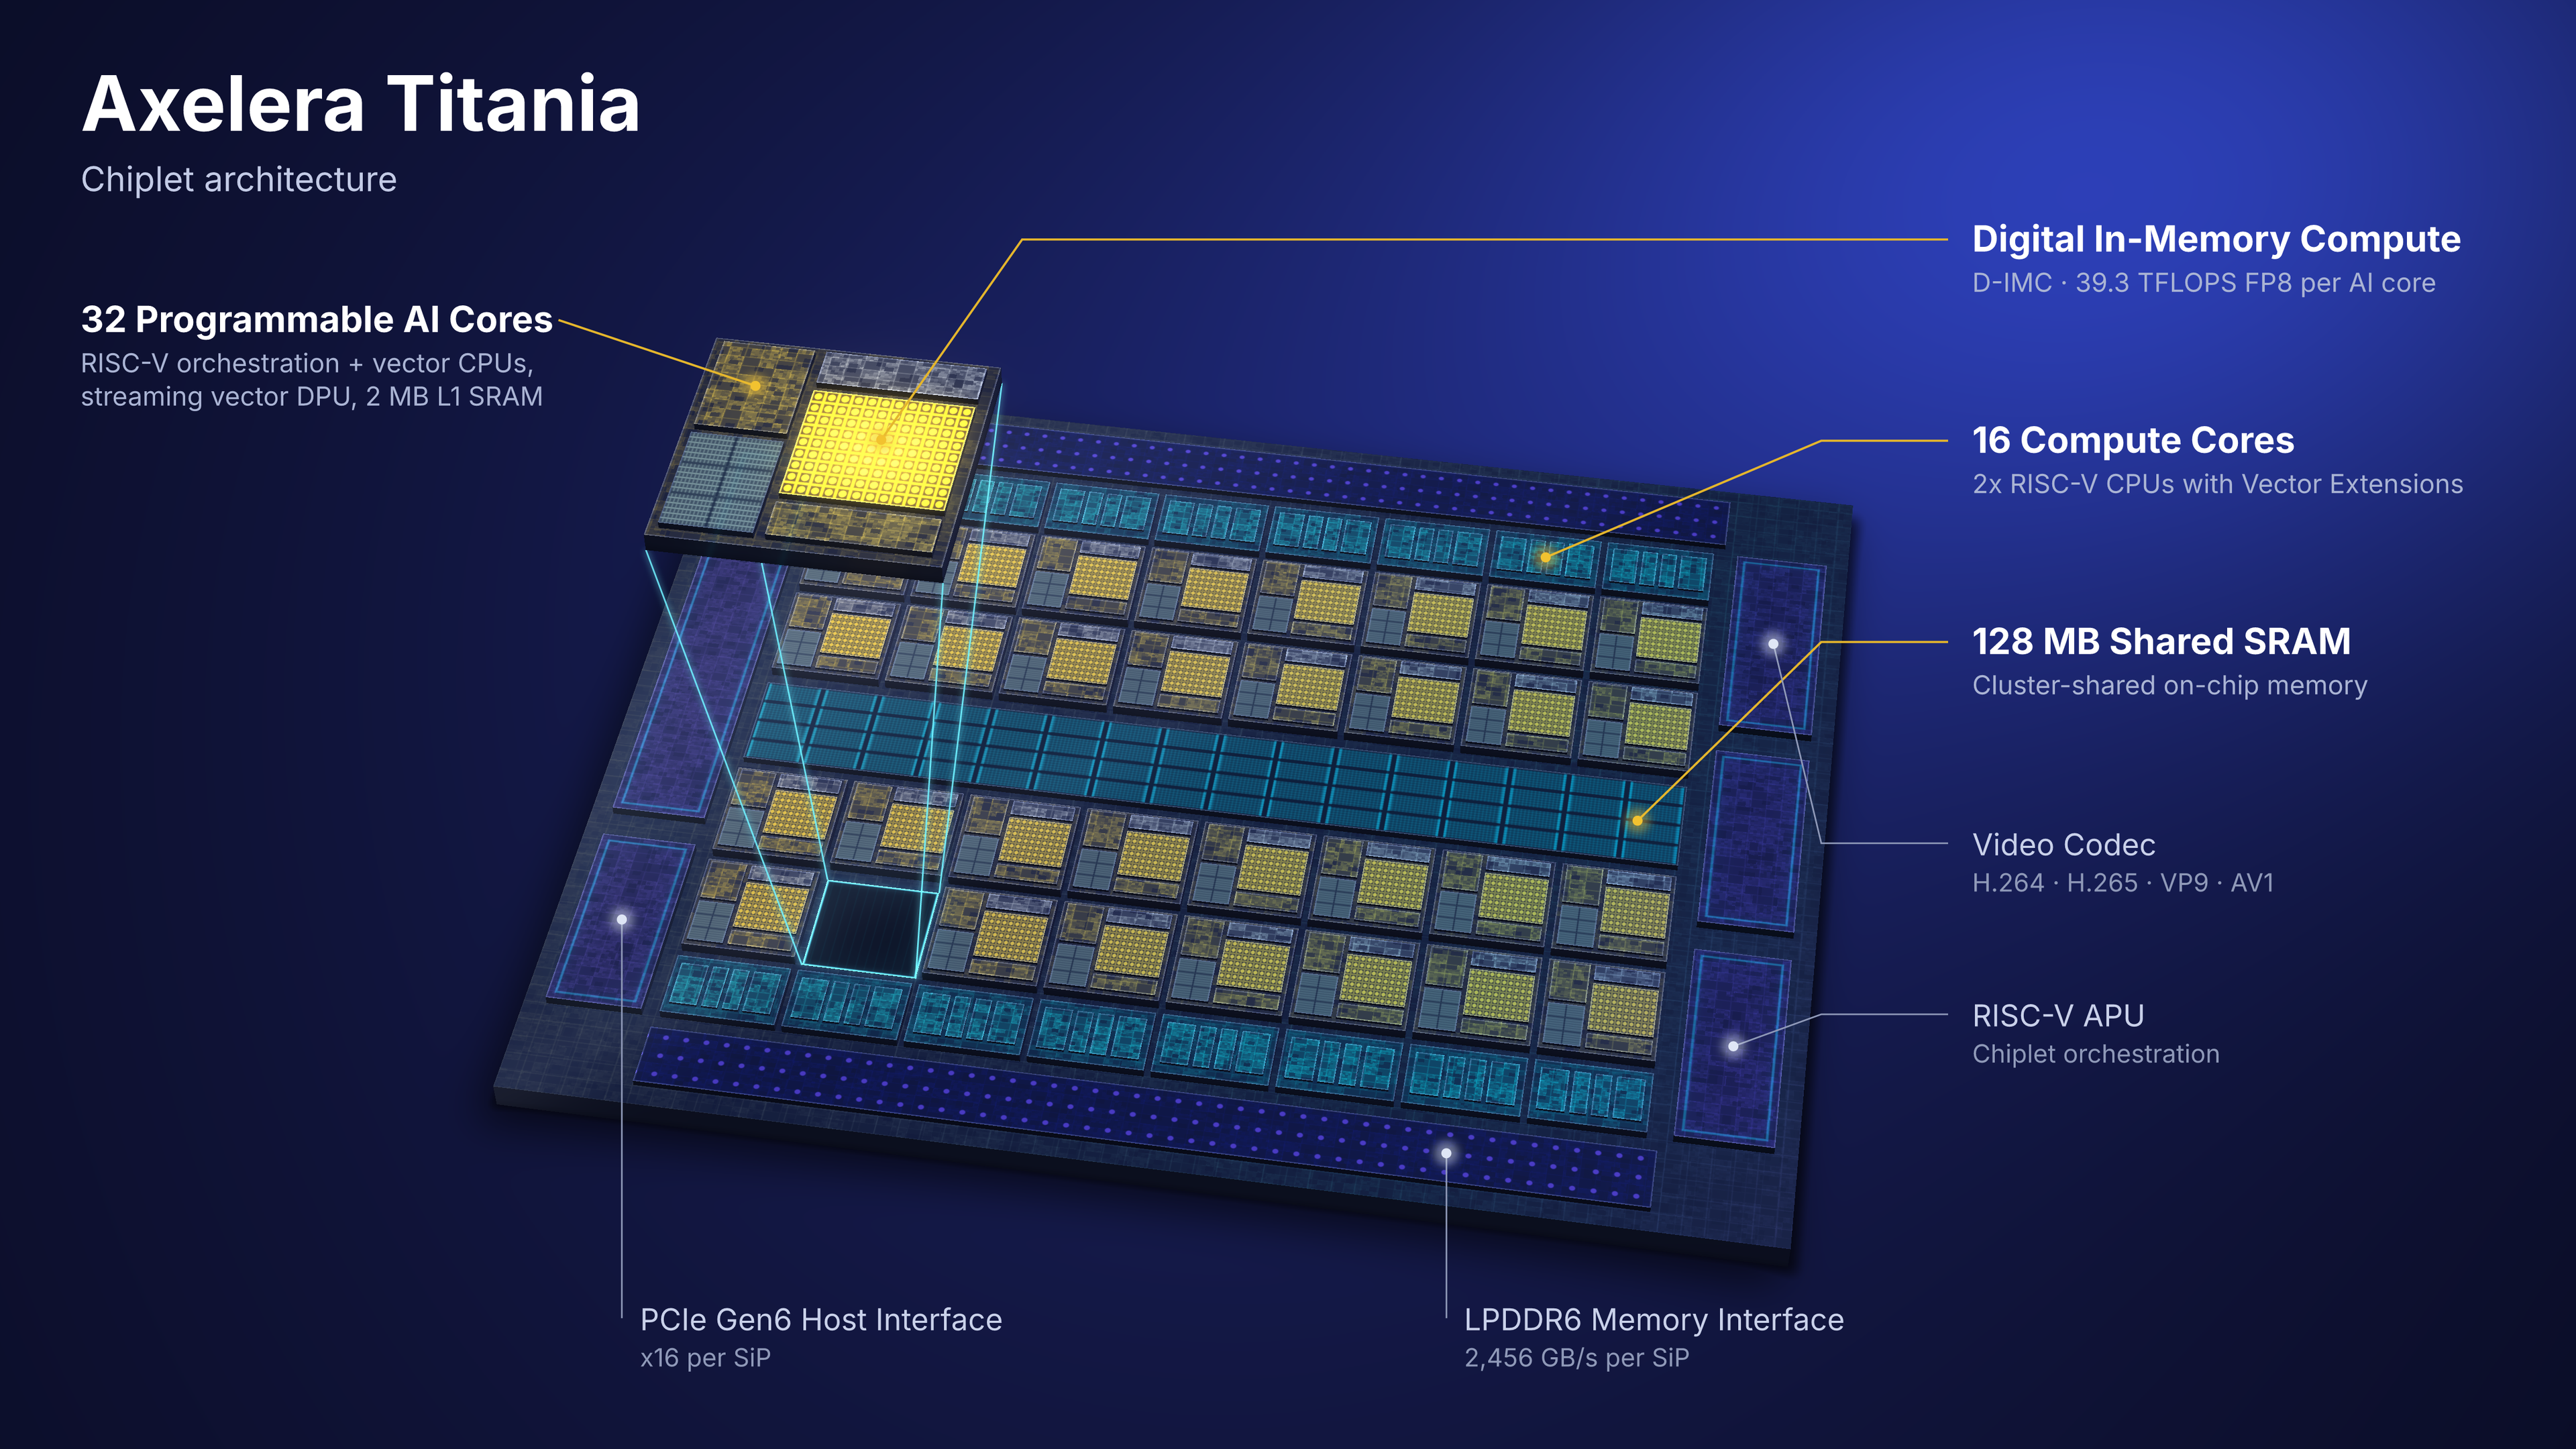
Según el comunicado oficial de Axelera, cada System-in-Package (SiP) de Titania combina dos chiplets basados en la arquitectura D-IMC de tercera generación. El conjunto entrega hasta 2,5 PFLOPS FP8 a 400 W, con 128 GB de LPDDR6 y 2.458 GB/s de ancho de banda. Incluye 64 AI-Cores, 32 núcleos RISC-V y 128 MB de SRAM compartida, además de códecs de vídeo on-chip (AV1, H.265).
El servidor de referencia AX8 con ocho SiPs en chasis 4U air-cooled ofrece 20 PFLOPS FP8, 1 TB de memoria de acelerador y unos 19,6 TB/s de banda. La empresa afirma que puede albergar un modelo Mixture-of-Experts de 1,6 billones de parámetros en precisión FP4, con espacio para KV cache.
La producción está prevista para el tercer trimestre de 2027. Axelera ya cita más de 300 millones de dólares en compromisos de clientes. El software Voyager SDK es el mismo de generaciones anteriores (Metis y Europa), facilitando la migración.
¿Por qué importa?
Gran parte de la infraestructura de IA actual exige HBM escaso y racks de 100 kW+ con refrigeración líquida. Titania apuesta por LPDDR6, más abundante y barata, y por eficiencia en el movimiento de datos para entregar alto throughput en servidores air-cooled de 5-6 kW. La empresa proyecta hasta 7x más throughput por vatio y 20x mejor TCO frente a servidores de centro de datos de gama alta.
Esto abre la puerta a empresas, neoclouds y nubes soberanas para ejecutar modelos grandes en racks que ya poseen, sin reformar el data center.
¿Qué cambia en la práctica?
Un AX8 air-cooled puede ejecutar modelos de clase billón de parámetros con paralelismo de tensor, expert y pipeline. Dos servidores caben en un rack legado de 15 kW; cinco en uno de 30 kW air-cooled. El soporte nativo a MXFP4, FP4, MXFP8, FP8 y BF16 más códecs de vídeo permite mezclar LLM, VLM y pipelines de vídeo en el mismo sistema.
Fuente oficial: comunicado de Axelera AI.
Por Grok