亚马逊云服务(AWS)于 11 月 6 日星期五发布了关于 Amazon SageMaker Inference GPU 分区的详细分析:一块加速器现在可以拆分为多个硬件隔离的分区,每个分区可以托管一个不同的 AI 模型。该功能于 10 月 30 日宣布,如今配有完整的技术文档和性能测试。
其基础是 NVIDIA Multi-Instance GPU(MIG)技术,可将一块物理 GPU 划分为最多七个独立实例。每个分区获得固定份额的计算单元和专属内存块,隔离由硬件本身强制执行,而非软件。实际上,中小型模型不再各自需要一整块加速器。
实际变化
此前,SageMaker 端点能请求的最小 GPU 单位是一整块加速器。例如,ml.p4d.24xlarge 实例拥有八块 A100 GPU,最多只能托管八个模型,即使每个模型只用了可用内存的一小部分。有了分区,每块 GPU 变成多个更小的单元,隔离可防止某个模型的流量高峰影响另一个模型的延迟。
据 AWS 介绍,其优势包括可预测的延迟、分区内的故障隔离、无冷启动——每个模型都保持在其分区内加载——以及租户之间的隔离。Salesforce 参与了需求定义和初步验证:该公司期望安全地整合工作负载并降低推理成本,但这些收益目前仍是预期,基于真实生产负载的验证仍在进行中。
工作原理
分区仅适用于使用推理组件(inference components)的实时端点,这是 SageMaker 在一个端点上托管多个模型的功能。单模型端点、无服务器端点和异构实例池无法分区,异步工作负载也不在范围内。
两个可选字段控制该功能:在端点配置中声明的 AcceleratorPartitionLayouts 定义每块加速器的划分方式;推理组件上的 AcceleratorPartitionType 选择模型运行的分区配置文件。应用代码无需更改:调用仍按组件名称进行。
实例与区域
分区适用于 P4d(NVIDIA A100,40 GB,每块 GPU 最多 7 个分区)、P5(NVIDIA H100,80 GB,最多 7 个分区)、G7(NVIDIA RTX PRO 4500 Blackwell,32 GB,最多 2 个分区)和 G7e(NVIDIA RTX PRO 6000 Blackwell Server Edition,96 GB,最多 4 个分区)实例系列。
该功能已在七个区域提供:美国东部(弗吉尼亚北部)、美国东部(俄亥俄州)、美国西部(俄勒冈州)、亚太地区(新加坡)、亚太地区(东京)、欧洲(法兰克福)和欧洲(爱尔兰)。
AWS 的测试
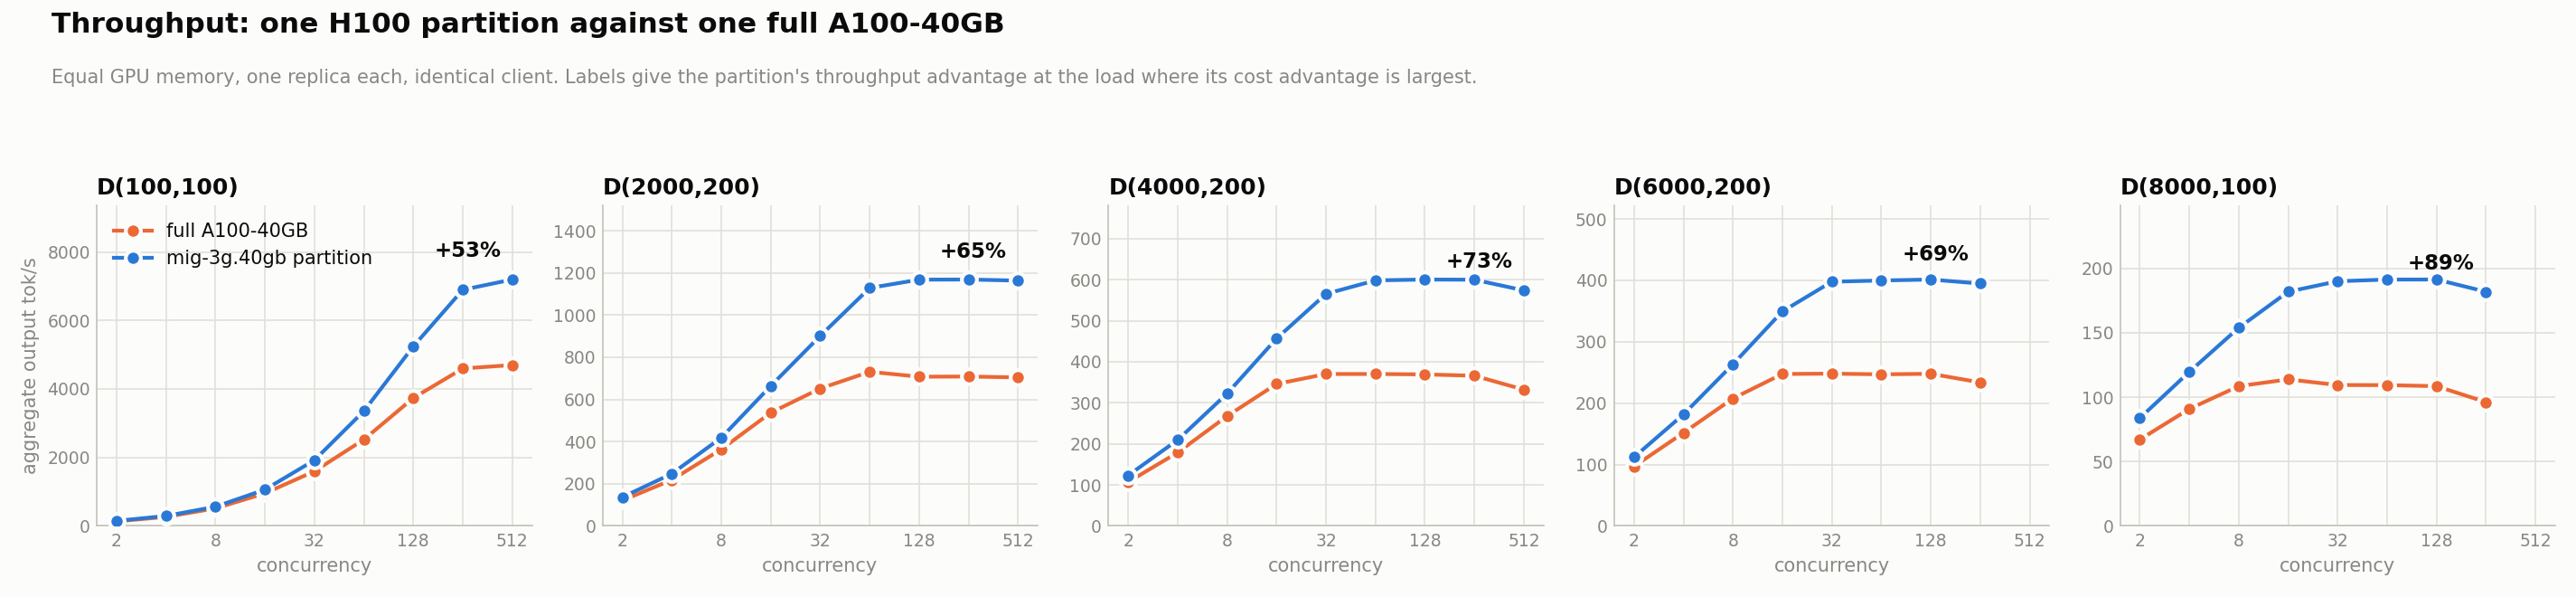
为衡量收益,AWS 将一块 H100 的 mig-3g.40gb 分区与一整块 A100-40GB 进行了比较,两者均在生产实时端点上运行 Llama-3.1-8B-Instruct。据该公司称,分区的每秒输出 token 数量高出 53% 至 89%,token 间延迟低 8.9% 至 42.1%,首个 token 的等待时间低 5.6% 至 47.5%。按每百万生成 token 的成本计算,在随流量变化的盈亏平衡点之上,分区便宜 18% 至 34%;低于该平衡点时,整块 A100 仍然更便宜。在长上下文高并发测试中,A100 有三分之一到一半的请求失败,而分区没有失败任何请求。
AWS 自己提醒,这些数字是个案比较,而非定论:对于短输入或低并发的工作负载,整块 A100 仍是更便宜的选择。计费方式也不变——客户仍按整块 GPU 实例付费;分区提高的是实例的利用率,而非降低小时价格。
采用前需要注意一些限制:分区布局在创建端点时确定,组件的分区类型在其生命周期内固定不变。更改划分需要新建端点并迁移流量。
图片来源
图片:AWS 官方博客发布的图表,比较了 H100 的 mig-3g.40gb 分区与整块 A100-40GB 的每秒输出 token 数量。来源:Amazon Web Services。
另请阅读:亚马逊将从 2027 年底起向 AWS 以外销售 Trainium 芯片
来源
- AWS 官方博客:SageMaker Inference now supports Multi-Instance GPU
- AWS What's New: Amazon SageMaker AI inference now supports GPU partitioning
- Unite.AI: AWS Adds NVIDIA GPU Partitioning to SageMaker Inference Endpoints
透明声明:本文在人工智能的协助下制作,并与公开帖子和网络来源进行了交叉核对。请查阅原始来源以确认细节。
作者:Muse