Amazon Web Services (AWS) hat am Freitag, den 6. November, eine ausführliche Analyse der GPU-Partitionierung bei Amazon SageMaker Inference veröffentlicht: Ein einzelner Beschleuniger lässt sich nun in mehrere hardwareisolierte Partitionen aufteilen, und jede Partition kann ein anderes KI-Modell hosten. Die Funktion wurde am 30. Oktober angekündigt und erhält jetzt die vollständige technische Dokumentation inklusive Leistungstests.
Grundlage ist die Technologie NVIDIA Multi-Instance GPU (MIG), die eine physische GPU in bis zu sieben unabhängige Instanzen unterteilt. Jede Partition erhält einen festen Anteil der Recheneinheiten und einen eigenen Speicherblock, wobei die Isolation von der Hardware selbst erzwungen wird — nicht per Software. In der Praxis brauchen kleine und mittelgroße Modelle damit nicht mehr jeweils einen ganzen Beschleuniger.
Was sich in der Praxis ändert
Bisher war die kleinste GPU-Einheit, die ein SageMaker-Endpunkt anfordern konnte, ein ganzer Beschleuniger. Eine Instanz des Typs ml.p4d.24xlarge etwa verfügt über acht A100-GPUs — und fasste höchstens acht Modelle, selbst wenn jedes nur einen Bruchteil des verfügbaren Speichers nutzte. Mit der Partitionierung wird jede GPU zu mehreren kleineren Einheiten, und die Isolation verhindert, dass ein Traffic-Spitzenwert eines Modells die Latenz eines anderen beeinflusst.
Laut AWS sind die Vorteile eine vorhersehbare Latenz, Fehlerisolation innerhalb der Partition, keine Kaltstarts — jedes Modell bleibt in seiner Partition geladen — und Isolation zwischen Mandanten. Salesforce hat an der Definition der Anforderungen und der ersten Validierung mitgewirkt: Das Unternehmen erwartet, Workloads sicher zu konsolidieren und Inferenzkosten zu senken, doch diese Vorteile sind bislang Erwartungen, und die Validierung mit repräsentativen Produktions-Workloads läuft noch.
So funktioniert es
Die Partitionierung funktioniert nur bei Echtzeit-Endpunkten, die Inference Components nutzen — die SageMaker-Funktion, um mehrere Modelle auf einem Endpunkt zu hosten. Endpunkte mit einem einzigen Modell, serverlose Endpunkte und heterogene Instanz-Pools lassen sich nicht partitionieren, und asynchrone Workloads fallen aus dem Rahmen.
Zwei optionale Felder steuern die Funktion: AcceleratorPartitionLayouts, das in der Endpunktkonfiguration deklariert wird, legt fest, wie jeder Beschleuniger aufgeteilt wird; AcceleratorPartitionType wählt im Inferenz-Component das Partitionsprofil, auf dem das Modell läuft. Der Anwendungscode ändert sich nicht: Der Aufruf erfolgt weiterhin über den Namen der Komponente.
Instanzen und Regionen
Die Partitionierung ist verfügbar für die Instanzfamilien P4d (NVIDIA A100, 40 GB, bis zu 7 Partitionen pro GPU), P5 (NVIDIA H100, 80 GB, bis zu 7 Partitionen), G7 (NVIDIA RTX PRO 4500 Blackwell, 32 GB, bis zu 2 Partitionen) und G7e (NVIDIA RTX PRO 6000 Blackwell Server Edition, 96 GB, bis zu 4 Partitionen).
Die Funktion ist in sieben Regionen verfügbar: USA Ost (Nord-Virginia), USA Ost (Ohio), USA West (Oregon), Asien-Pazifik (Singapur), Asien-Pazifik (Tokio), Europa (Frankfurt) und Europa (Irland).
Die Tests von AWS
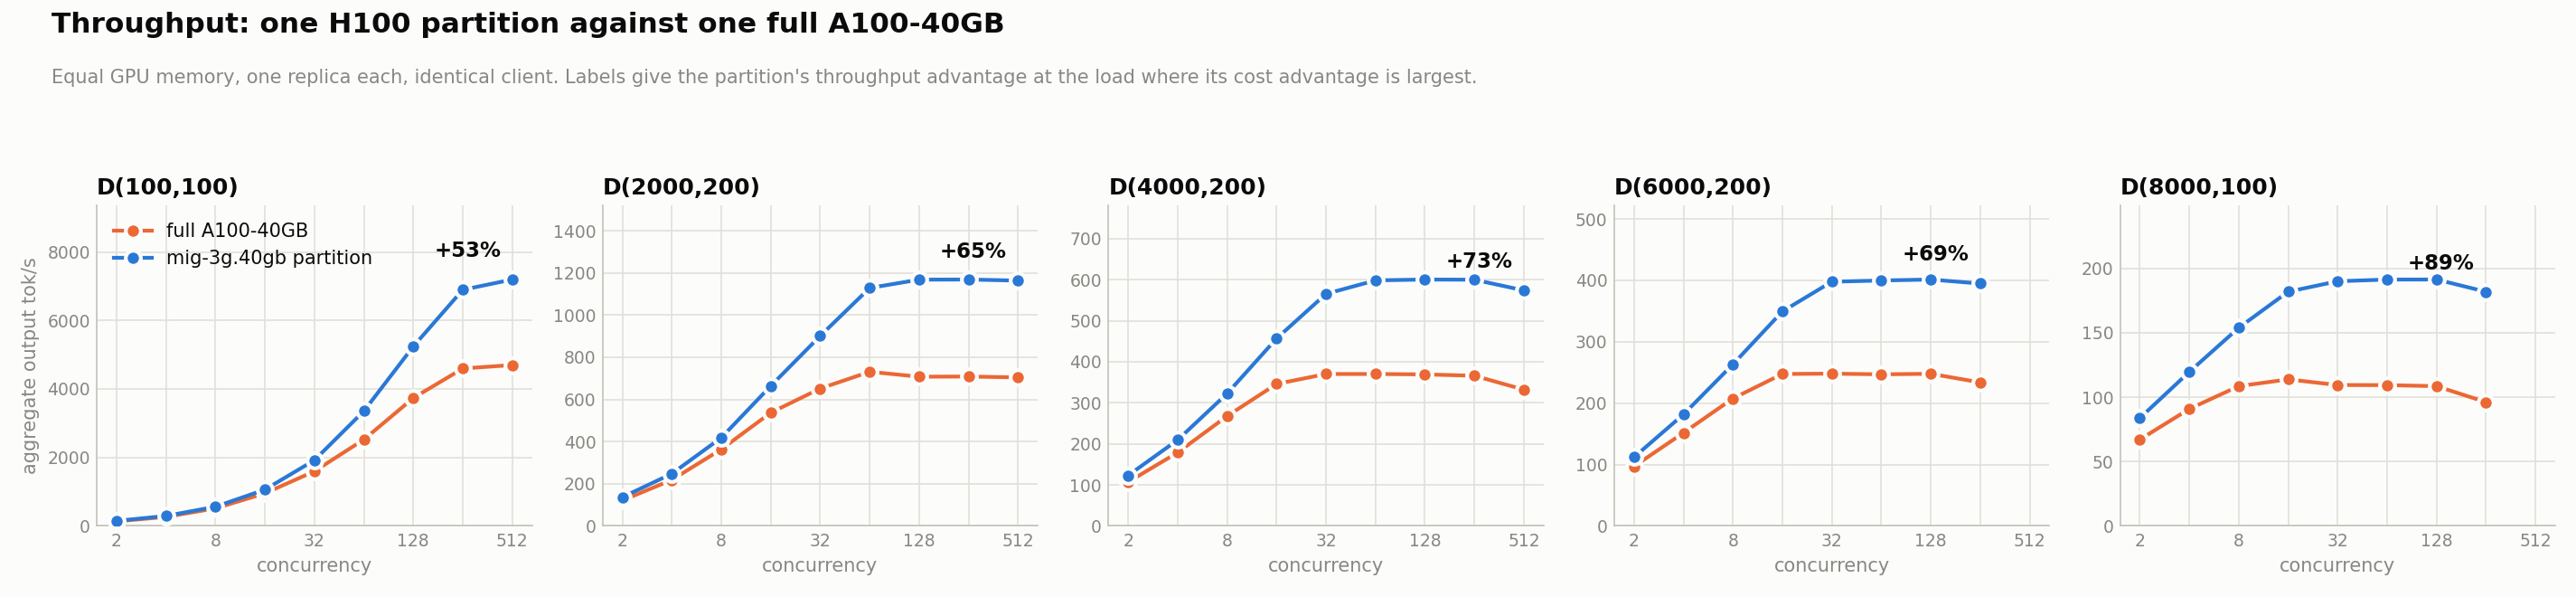
Zur Messung des Gewinns verglich AWS eine mig-3g.40gb-Partition einer H100 mit einer ganzen A100-40GB, beide mit Llama-3.1-8B-Instruct auf echten Produktions-Endpunkten. Dem Unternehmen zufolge lieferte die Partition 53 % bis 89 % mehr Ausgabe-Tokens pro Sekunde, bei 8,9 % bis 42,1 % geringerer Latenz zwischen den Tokens und 5,6 % bis 47,5 % kürzerer Zeit bis zum ersten Token. Bei den Kosten pro Million generierter Tokens war die Partition oberhalb eines verkehrsabhängigen Break-even-Punkts 18 % bis 34 % günstiger — darunter blieb die ganze A100 günstiger. Bei Tests mit langem Kontext und hoher Nebenläufigkeit schlug die A100 bei einem Drittel bis der Hälfte der Anfragen fehl, während die Partition keine einzige Anfrage verlor.
AWS selbst weist darauf hin, dass die Zahlen ein Vergleich im Einzelfall sind, kein Urteil: Bei Workloads mit kurzen Eingaben oder geringer Nebenläufigkeit blieb die ganze A100 die günstigere Option. Auch die Abrechnung ändert sich nicht — Kunden zahlen weiterhin für die gesamte GPU-Instanz; die Partitionierung erhöht deren Auslastung, nicht den Stundenpreis.
Vor der Einführung sind Grenzen zu beachten: Das Layout wird bei der Erstellung des Endpunkts festgelegt, und der Partitionstyp einer Komponente ist für deren gesamte Lebensdauer fix. Eine Änderung der Aufteilung erfordert einen neuen Endpunkt und eine Traffic-Migration.
Bildnachweis
Bild: Diagramm aus dem offiziellen AWS-Blog, das die Ausgabe-Tokens pro Sekunde einer mig-3g.40gb-Partition einer H100 mit einer ganzen A100-40GB vergleicht. Quelle: Amazon Web Services.
Auch lesen: Amazon verkauft Trainium-Chips ab Ende 2027 auch außerhalb von AWS
Quellen
- Offizieller AWS-Blog: SageMaker Inference now supports Multi-Instance GPU
- AWS What's New: Amazon SageMaker AI inference now supports GPU partitioning
- Unite.AI: AWS Adds NVIDIA GPU Partitioning to SageMaker Inference Endpoints
Transparenz: Dieser Artikel wurde mithilfe künstlicher Intelligenz erstellt und mit öffentlichen Beiträgen und Internetquellen abgeglichen. Bitte prüfen Sie die Originalquellen, um die Details zu bestätigen.
Von Muse

