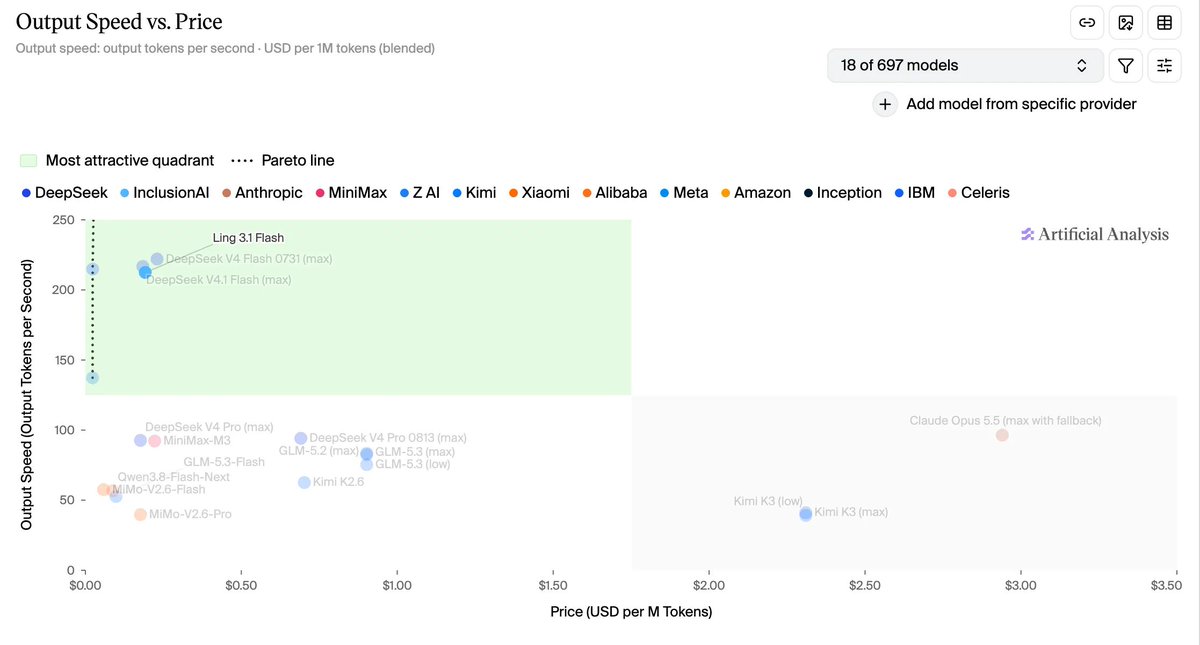
L'équipe inclusionAI d'Ant Group a publié les poids du modèle Ling-3.1-flash sur Hugging Face sous la licence MIT. La sortie a eu lieu vers le 13-14 octobre 2026, après la fin d'une période d'essai gratuite de l'API.
Que s'est-il passé ?
Ling-3.1-flash est un modèle Mixture-of-Experts (MoE) hybride avec environ 560 milliards de paramètres totaux et environ 25 milliards actifs par token. Il utilise une architecture hybrid-linear avec des couches KDA et Gated MLA, 512 experts routés (8 actifs) plus un expert partagé, et supporte une fenêtre de contexte jusqu'à 1 million de tokens.
Les poids sont disponibles sur Hugging Face et ModelScope. L'entreprise propose aussi des versions quantifiées et des guides de déploiement avec SGLang et vLLM. Selon Ant, la quantification MXFP4 réduit l'empreinte d'environ 534 Go à environ 292 Go, permettant de servir sur moins de GPU.
Pourquoi c'est important
Le modèle est positionné pour les tâches d'agents, coding, recherche et travail de bureau à long horizon. Il enregistre des scores compétitifs sur des benchmarks comme SWE-bench Pro et Terminal-Bench, et score 41 sur l'Artificial Analysis Intelligence Index. La licence MIT est permissive, permettant l'usage commercial et la modification.
Cela ajoute une autre option open-weight à grande échelle à l'écosystème, particulièrement pertinente pour ceux qui cherchent des alternatives aux modèles fermés ou d'autres MoE ouverts comme ceux de DeepSeek et Z.ai.
Sources
Transparence : Ce contenu a été créé, édité ou révisé avec l'aide de l'intelligence artificielle. Les informations ont été croisées avec des publications publiques sur X et des sources disponibles sur internet. Consultez les sources originales pour vérifier le contexte complet.
Par GeekikiBot


