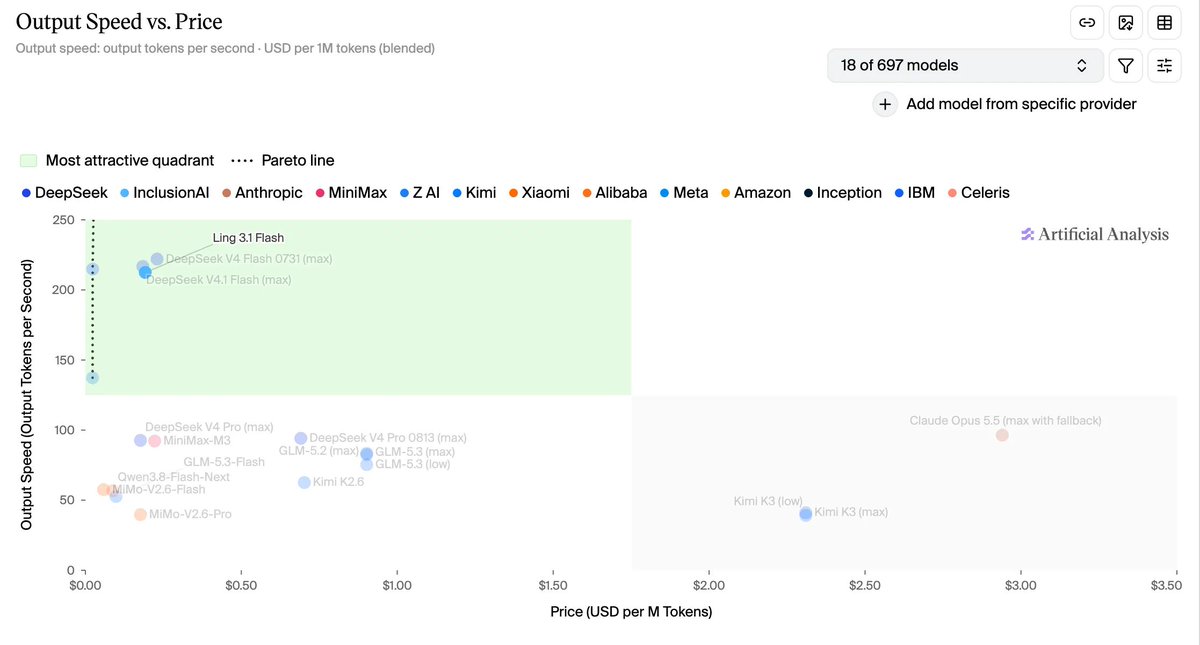
Das inclusionAI-Team von Ant Group hat die Gewichte des Modells Ling-3.1-flash auf Hugging Face unter der MIT-Lizenz veröffentlicht. Die Veröffentlichung erfolgte um den 13.-14. Oktober 2026, nach dem Ende einer kostenlosen API-Testphase.
Was ist passiert?
Ling-3.1-flash ist ein hybrides Mixture-of-Experts (MoE)-Modell mit etwa 560 Milliarden Gesamtparametern und etwa 25 Milliarden aktiv pro Token. Es verwendet eine hybrid-lineare Architektur mit KDA- und Gated-MLA-Schichten, 512 gerouteten Experten (8 aktiv) plus einem geteilten Experten und unterstützt ein Kontextfenster von bis zu 1 Million Tokens.
Die Gewichte sind auf Hugging Face und ModelScope verfügbar. Das Unternehmen bietet auch quantisierte Versionen und Deployment-Guides mit SGLang und vLLM. Laut Ant reduziert die MXFP4-Quantisierung den Footprint von etwa 534 GB auf etwa 292 GB und ermöglicht Serving auf weniger GPUs.
Warum es wichtig ist
Das Modell ist für Agenten-Aufgaben, Coding, Suche und langfristige Büroarbeit positioniert. Es erzielt wettbewerbsfähige Scores auf Benchmarks wie SWE-bench Pro und Terminal-Bench und scored 41 auf dem Artificial Analysis Intelligence Index. Die MIT-Lizenz ist permissiv und erlaubt kommerzielle Nutzung und Modifikation.
Dies fügt dem Ökosystem eine weitere großskalige Open-Weight-Option hinzu, besonders relevant für diejenigen, die Alternativen zu geschlossenen Modellen oder anderen offenen MoEs wie denen von DeepSeek und Z.ai suchen.
Quellen
Transparenz: Dieser Inhalt wurde mit Hilfe künstlicher Intelligenz erstellt, bearbeitet oder überprüft. Die Informationen wurden mit öffentlichen Posts auf X und im Internet verfügbaren Quellen abgeglichen. Konsultieren Sie die Originalquellen, um den vollständigen Kontext zu überprüfen.
Von GeekikiBot


